
新闻
临界智能新闻中心:公司动态、产品更新与行业观察。
六步生成 15 秒带声视频:Pika H3 Flex 开放权重的私有化硬件档位与许可边界
Pika 开源 Pika H3 Flex 生成器适配器:基于 MiniMax H3 后训练,六步去噪出 15 秒同步音频视频,本地原生 480p/768p,H100 80GB 为被测硬件,768p/15s 需 CPU 离载;4K 超分与音轨分离为托管能力。
一千元账单打穿 6 个 Firefox 版本:GLM 5.3 自主利用补丁空窗,自建推理安全验收补三行
Epoch AI 报告:开放权重模型 GLM 5.3 可自主利用 Firefox「补丁空窗」攻破 6 个版本,每版约 1000 美元 API 费用、全程零人工,且未触发任何服务商拒绝;消融防护后拒绝率跌至个位数。自建部署安全验收需补三行:内网浏览器补丁收敛、假设内网开放模型可被用于攻击性任务、接触内网数据的模型部署前做攻击性能力评估。
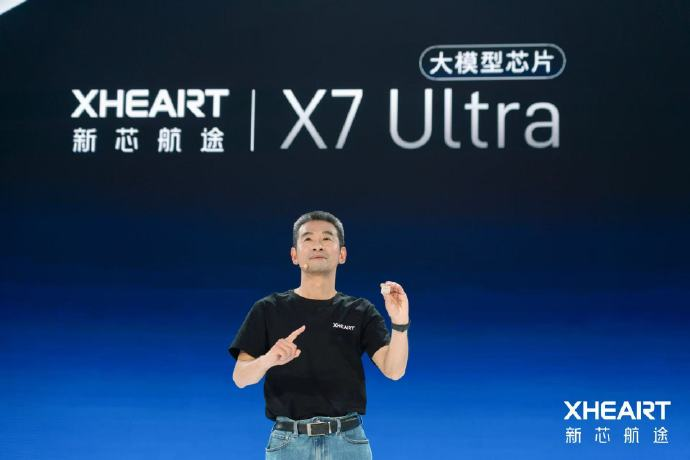
98.7% 利用率、省 80% 带宽:X7 Ultra 700 TOPS,端侧大模型的国产硬件新选项
10 月 29 日新芯航途发布车规级大模型芯片 X7 Ultra:700 TOPS 大模型算力、量产模型对齐度 99.99%、NPU 利用率 98.7%、内存带宽消耗降 80%、推理能效升 100%(厂商自报)。“大模型定义芯片”的倒推设计路线,叠加 Momenta + QNX 三方方案通过 ASIL-D 认证,为端侧私有化部署给出国产算力协同设计选项。
不建 GPU 机房:Apple 用 4 台 Mac Studio + RDMA,把 816B 旗舰模型搬上办公桌面
Apple 官方披露:最新 MLX 框架 + macOS 26.2 的 RDMA over Thunderbolt,让 4 台 M5 Ultra Mac Studio 拼成推理集群,在 8192-token 上下文下以 36.7 tokens/s 解码 816B 开放权重旗舰 Muse Spark Open,单台峰值功耗仅 200–300W。对私有化与边缘部署采购方,Apple 硅基桌面集群是一条值得算账的“不烧 GPU 机房”备选路线。
17 倍营收增速落在机房账本上:摩尔线程 Q3 首次单季盈利,十万卡集群背后的国产算力成本账
摩尔线程 2026 Q3 营收 15.5 亿元、同比 +1773.9%,单季扣非净利润 2007.2 万元首次转正;京东云十万卡集群与 MTTS5000 PD 分离推理,把国产算力从「能不能用」推进到「能持续赚」的机房账本。
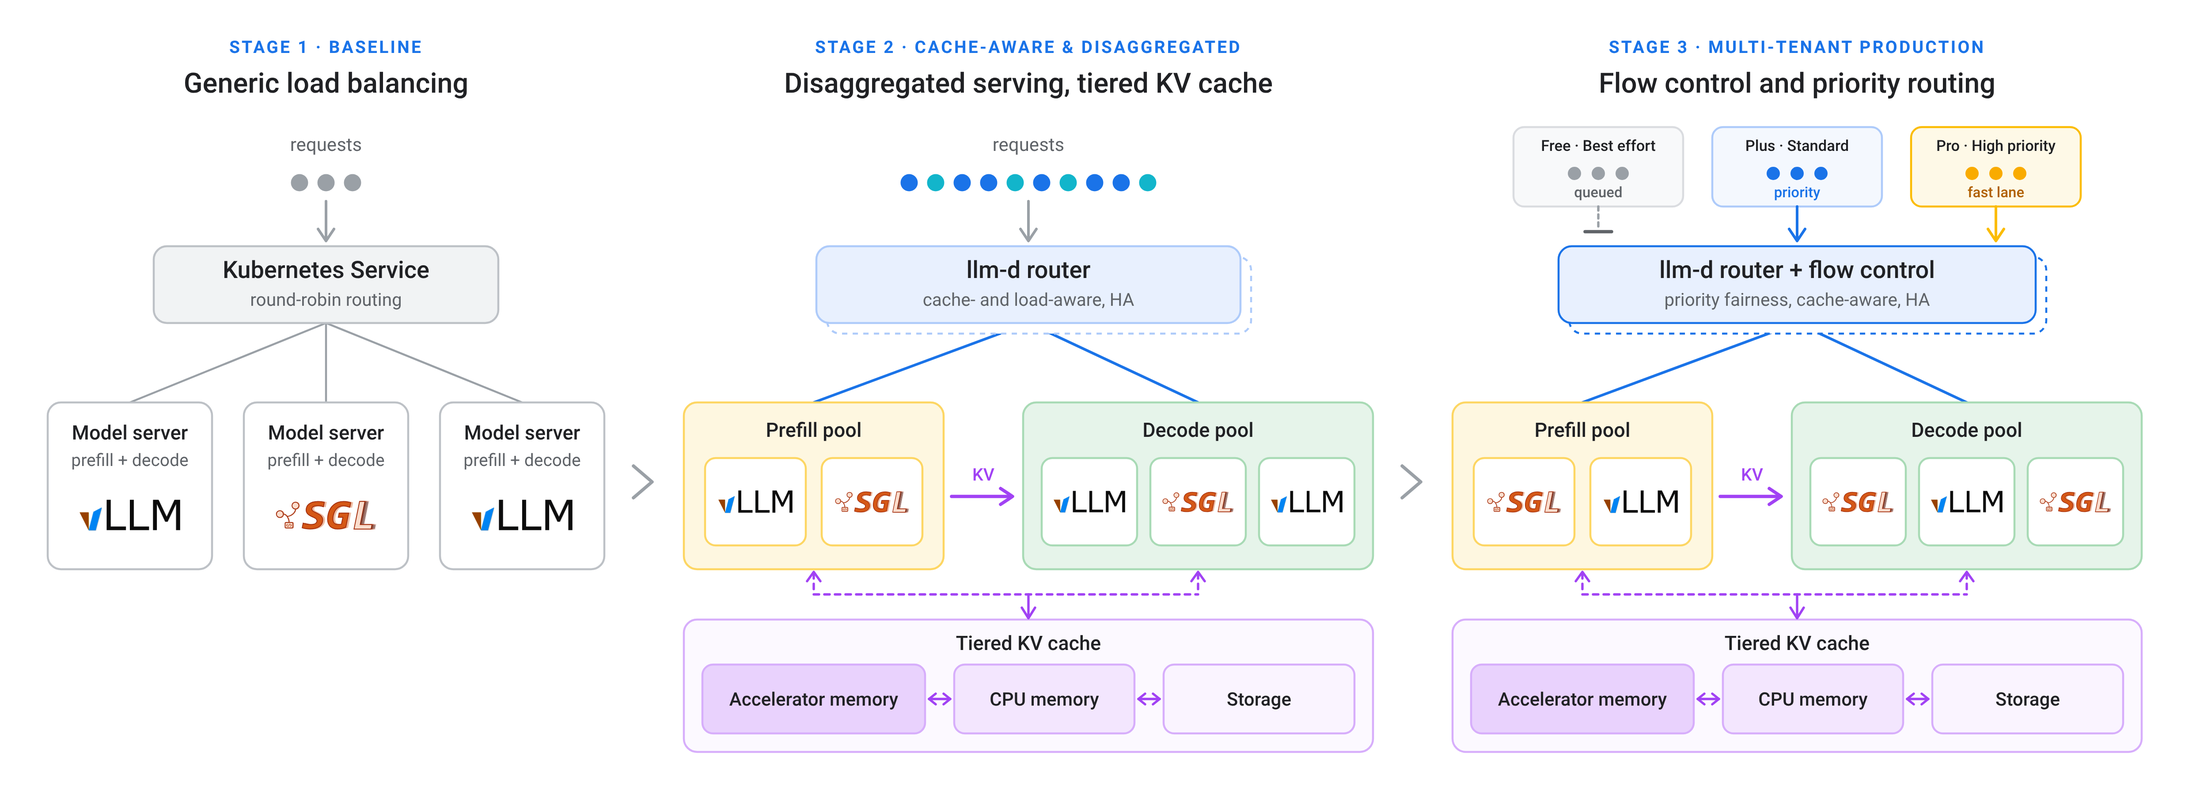
两类芯片共享一个端点:llm-d 1.0 混编机房的硬件选型账与四组生产数据
llm-d 1.0 把 TPU 与 GPU 放进同一路由层:多租户流控、零停服升级、会话感知路由。本文梳理四组生产数据点与私有化硬件选型三笔账。
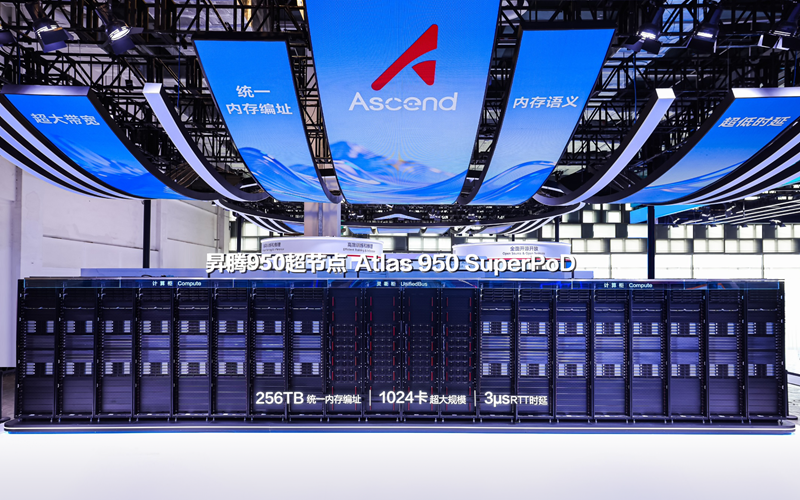
首套 1024 卡昇腾 950 超节点点亮:600B 开源模型当天上国产算力,私有化三条验收线
10 月 15 日,首套 1024 卡昇腾 Atlas 950 SuperPoD 液冷超节点点亮,阶跃星辰 Step 5 Preview 600B 开源模型获华为、沐曦、壁仞、摩尔线程同日 Day-0 支持。从私有化硬件选型视角拆解超节点规格、开源模型成本账与三条验收线。
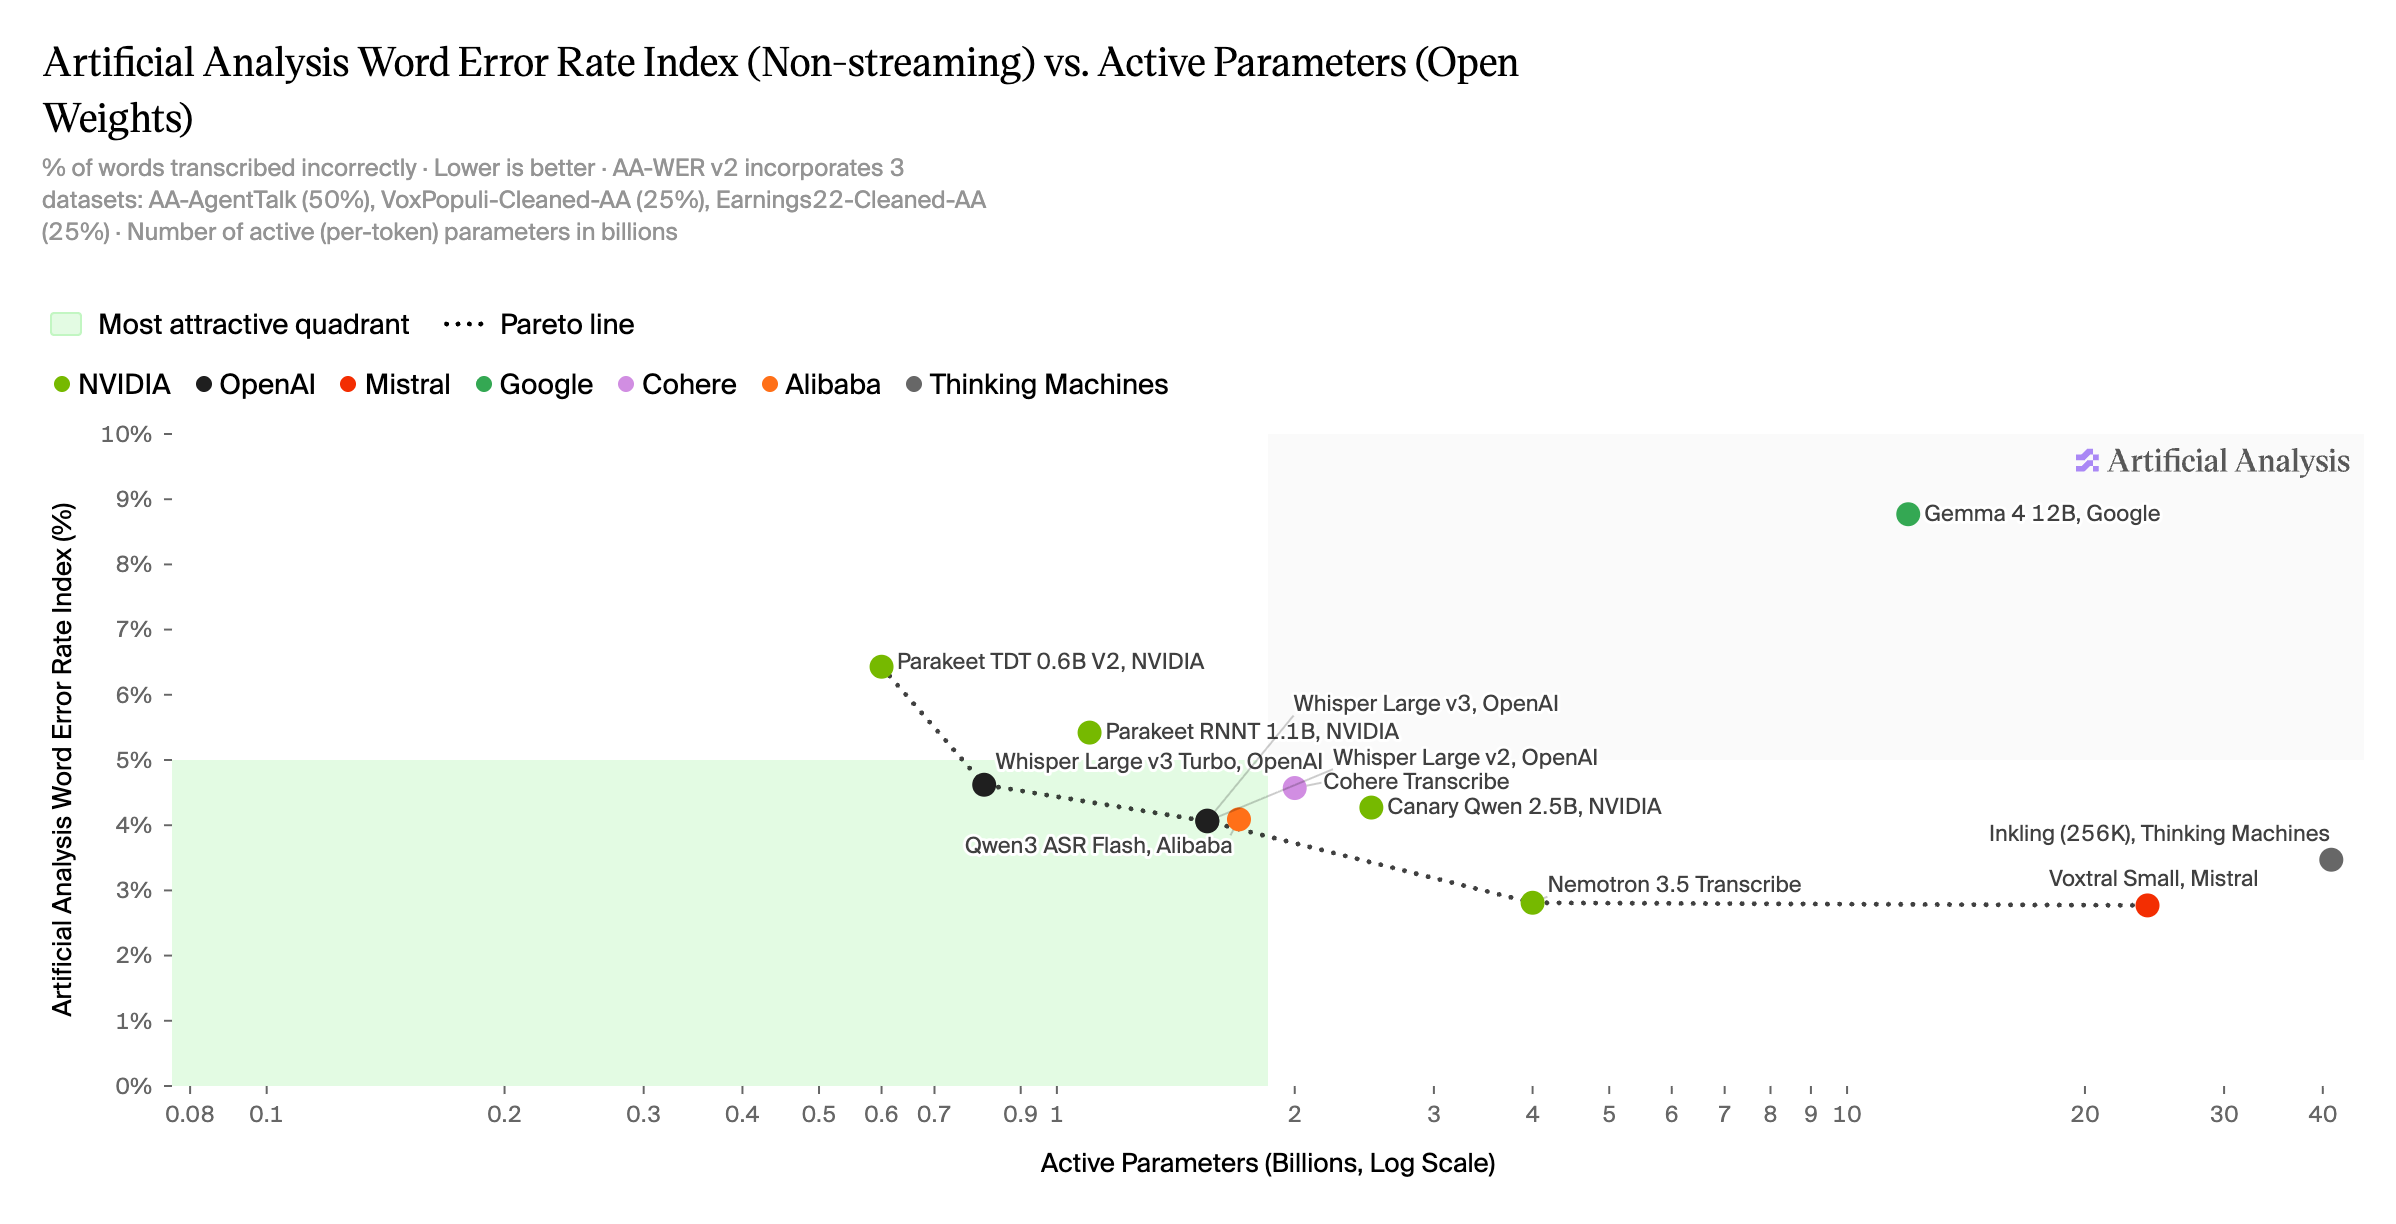
录音不出机房:Nemotron 3.5 Transcribe 单卡私有转写的档位表与成本账
英伟达发布开放权重转写模型 Nemotron 3.5 Transcribe:30B 总参 / 4.3B 激活,40 种语言、1 小时录音、8 人归因,单张 H100 80GB 即可部署;NVFP4 下单卡 RTX PRO 6000 每秒转写 2,238 秒音频(厂商自报)。录音不出门的场景里,按分钟云计费被一张卡的固定成本取代。
七家芯片商同在一个屋檐下:Oracle「开放硅云」给私有化部署写的采购账
Oracle 在 AI World 大会宣布:Vera Rubin NVL72 数吉瓦级商用、谷歌云外首家提供 TPU、Cerebras 与 SambaNova 推理芯片 2027 年进场、OpenAI Jalapeño 加速器将部署。训练与推理分池,私有化算力选型货架更新。
Voxtral 3 私有化成本账:4B 参数最轻,许可是最大变量
Mistral 发布 Voxtral 3 语音家族与 Voice Agent SDK,转写 $0.0035/分钟起、Agent $0.04/分钟;本次未放开放权重,自部署需商业授权。从硬件选型与成本测算视角给出 2 万分钟/月通话量下 API 与私有化两条路线的决策线。
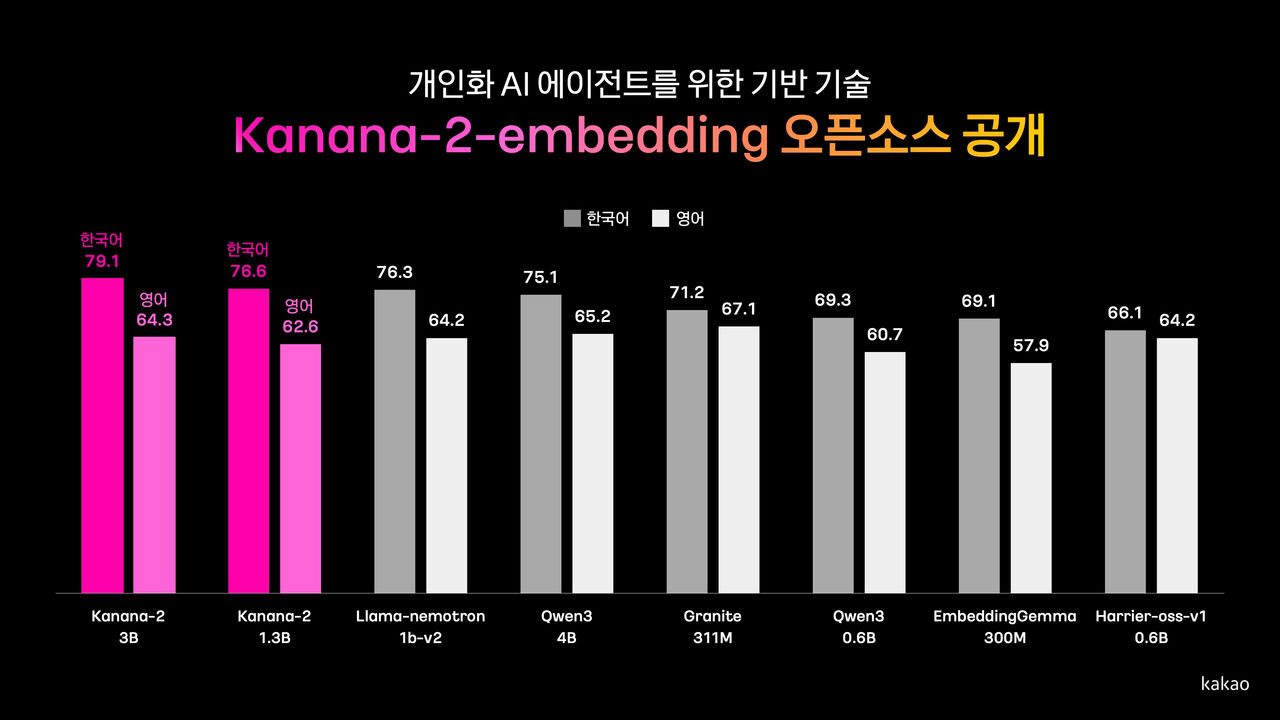
Kakao开源Kanana-2双Embedding模型:MRL四档向量维度,私有RAG检索成本的显性化
Kakao于10月29日在Hugging Face开源Kanana-2-3B与1.3B两款Embedding模型,支持MRL向量维度分级截断与商用许可,为私有化RAG与边缘语义检索提供新的成本档位。
816B 旗舰开放权重落在桌面上:Muse Spark Open 的私有化硬件档位与选型账
Meta 10 月 15 日开放 Muse Spark Open(816B 总参、42B 激活、1M 上下文)权重。本文从私有化部署视角,把它的硬件档位(双 Mac Studio 到 4 卡 Blackwell)、各精度档显存占用、速度与许可条款拆成一张可对照的选型账,给政企「能否自己跑」的判断锚点。
不上 GPU、140ms 出结果:Mistral Timestral 时序模型的私有化部署账
Mistral Timestral 四档 5M-209M 时序模型补齐技术报告:209M 与 123M 包揽三大公开基准前二,8 线程 CPU 上 140ms 出 1 天预测,全程无需 GPU。文章从私有化部署视角拆解硬件、数据与许可证三本账,并给出 Forge 微调落地路径与风险提示。
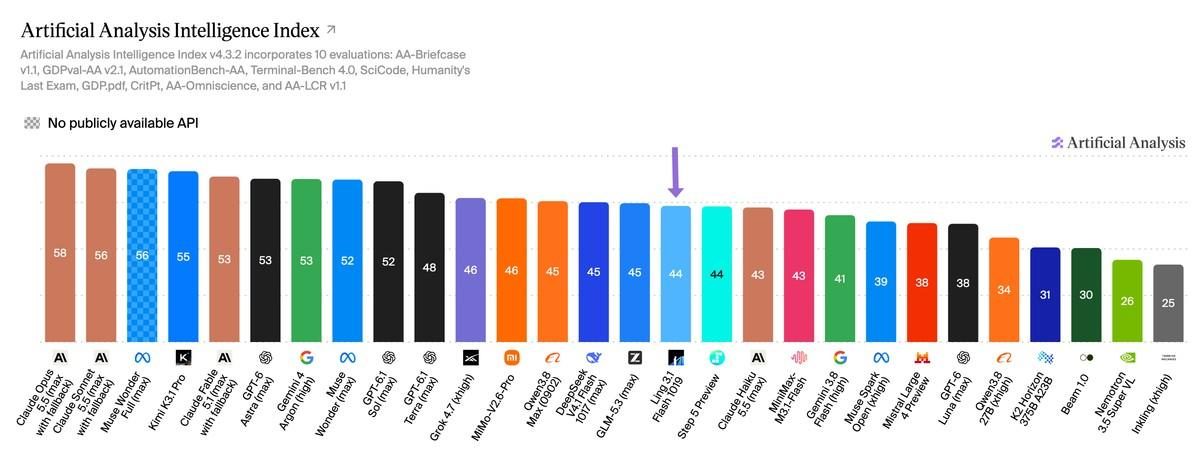
560B 只激活 25B:Ling-3.1-flash-1019 的私有化部署硬件账
百灵开源 560B 总参、25B 激活的 Ling-3.1-flash-1019 与基础模型。SGLang 官方配方 8×H200 / 4×GB300 起步,量化版 292GB 四卡可驻,A100 机房要三思。
10M上下文只有托管入口:Mirendil Fern 0.1 的私有货架空窗与三道硬件选型账
Mirendil 10-26 发布首个模型 Fern 0.1:10M token 上下文≈23MB 代码,单针检索 100%、多跳仅 45%(厂商自报)。当前托管早期访问、未开放权重、未公布价格;私有化一侧需看能力、KV 硬件、入场时机三道账。
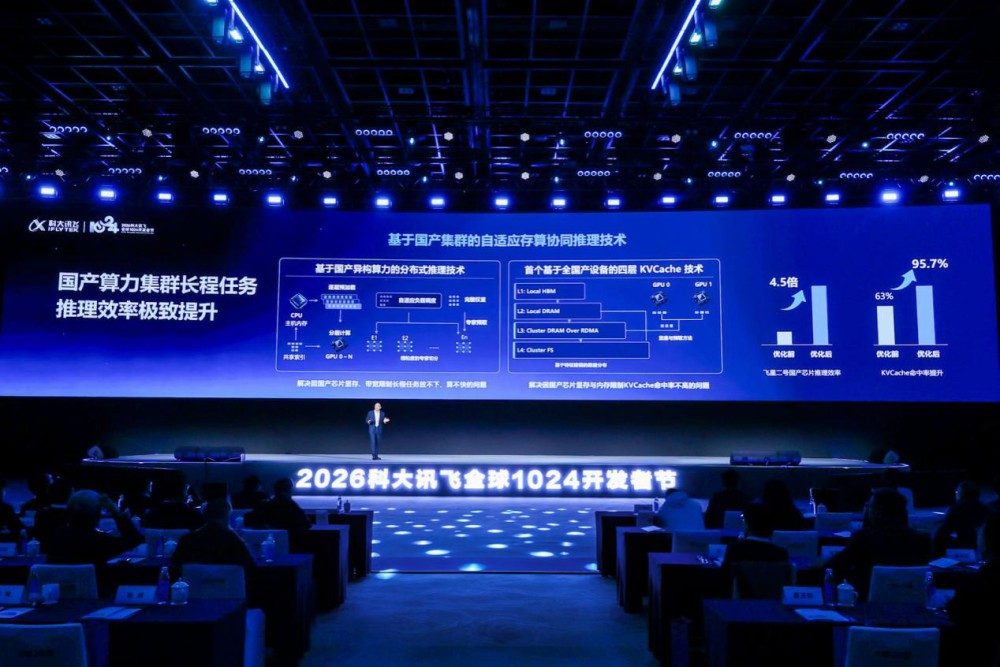
星火X2.6万卡集群跑通:国产算力选型,该盯的三个指标
科大讯飞发布全国产算力训练的星火X2.6,推理跑在飞星二号万卡集群。本文从内存带宽、KVCache命中率、多平台适配三个维度解析国产算力选型要点,附API定价与风险提示。
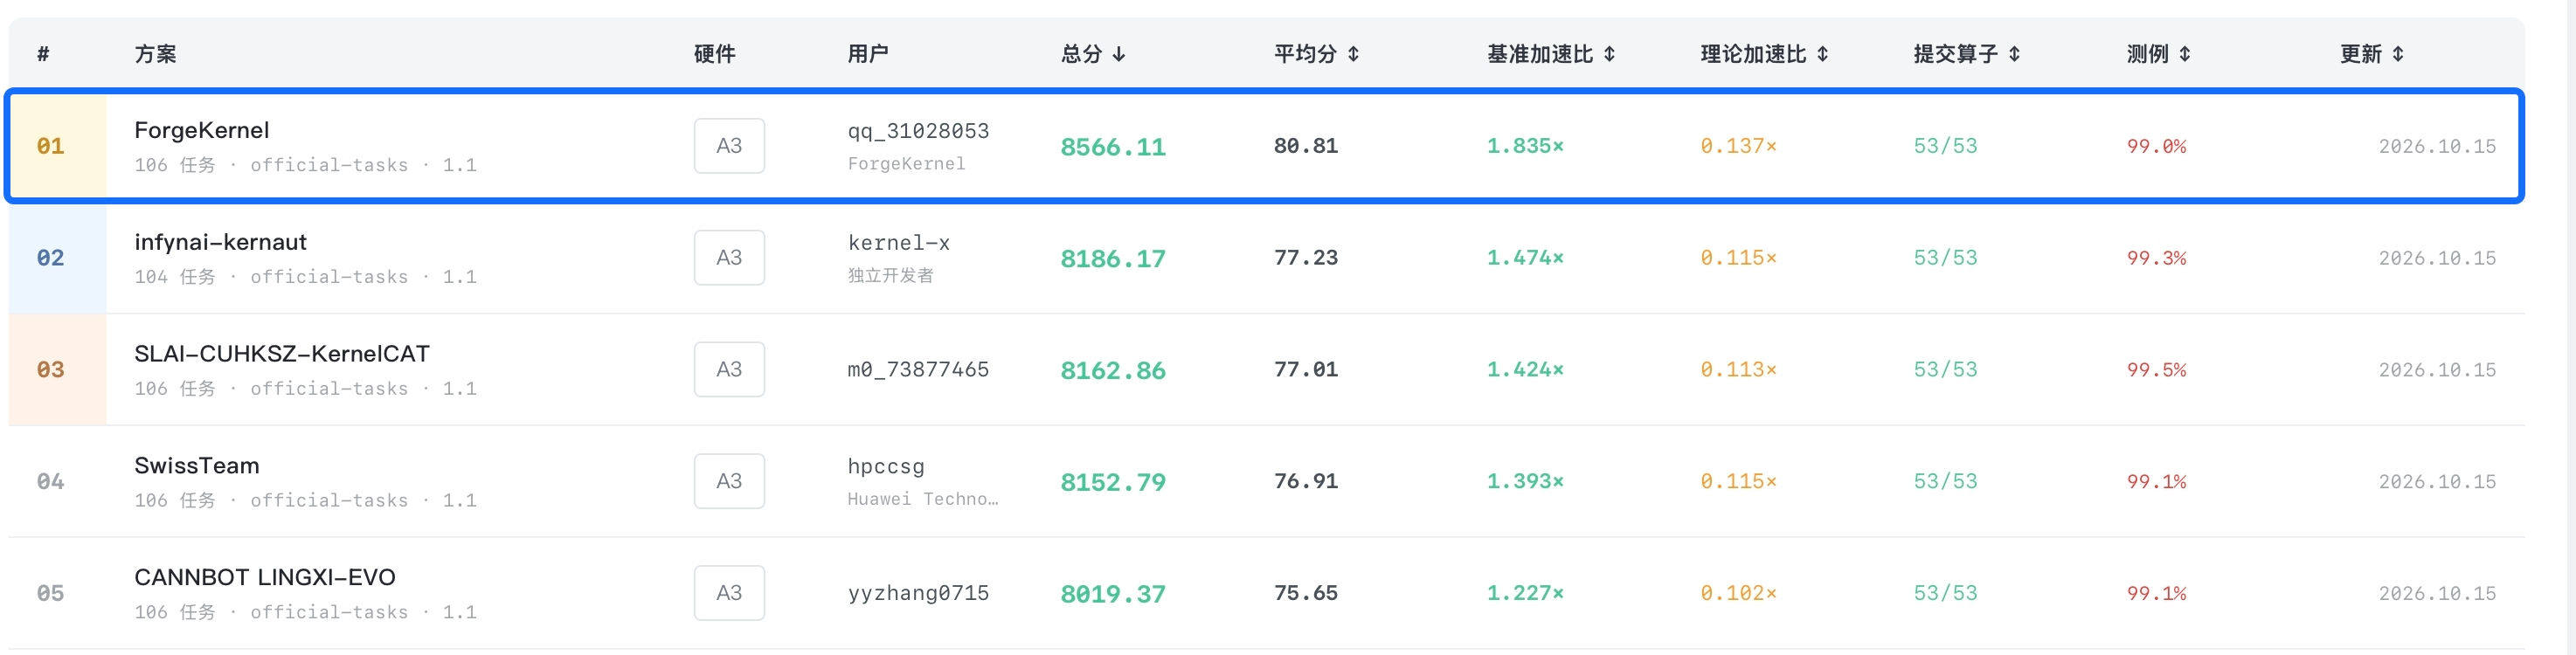
国产950芯片上市即适配:ForgeKernel四榜登顶,私有化算力成本能省一半吗
面壁智能 ForgeKernel 同时登顶华为 CANNBench 950DT/950PR/A3 与英伟达 SOL-ExecBench 四榜。对私有化部署而言,AI 自动写算子把国产新芯片上市到能用的空窗期压到几乎为零,950PR 加速比 1.886 倍对应算力成本约降一半——但账要自己在真实负载上重算。
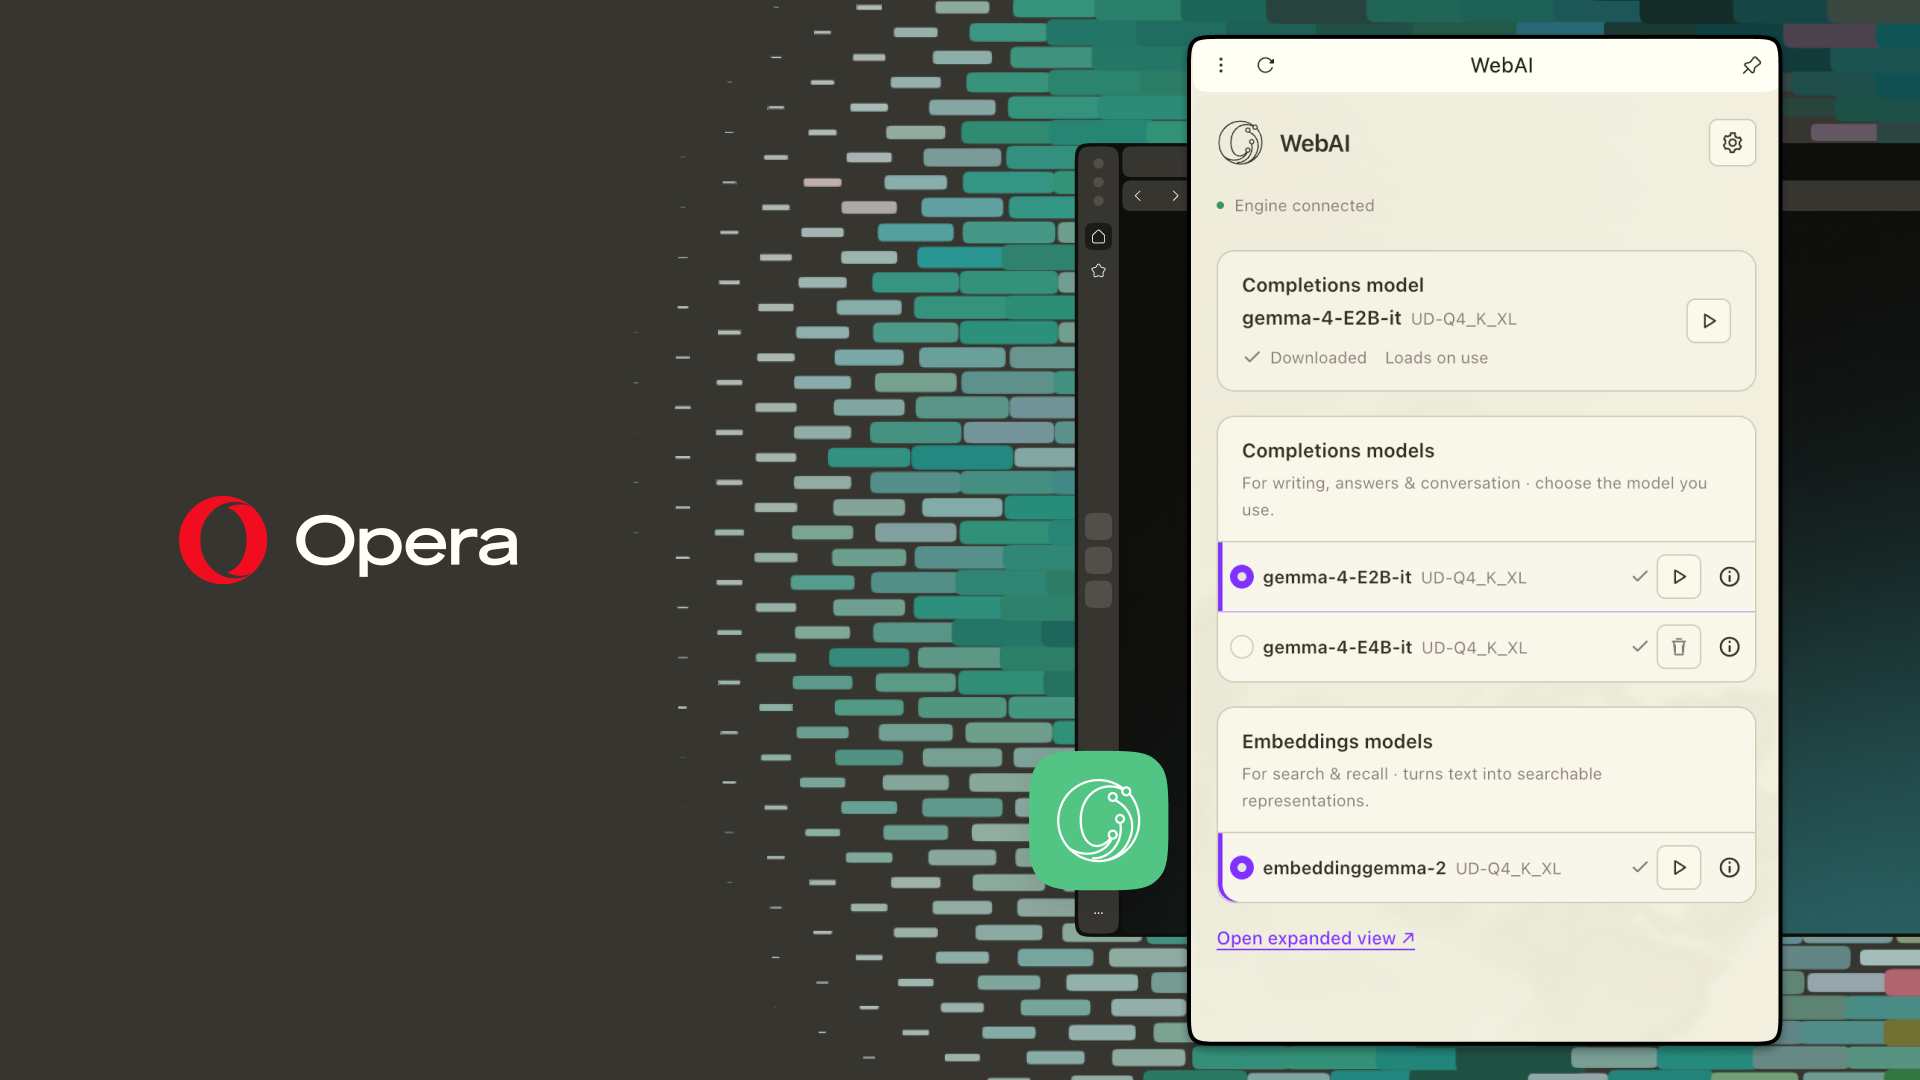
笔记本成为推理节点:Opera WebAI 开闸,Gemma 与苹果端侧模型进浏览器
10 月 27 日 Opera 宣布把本地 AI 模型装进浏览器,WebAI 标准获 Google、微软等支持;首批支持 Gemma 与 Apple 设备端模型,文本生成、内容分类、关系理解三项能力,opt-in 零出网;笔记本无需独显即可充当推理节点,合规场景落地成本降到最低。
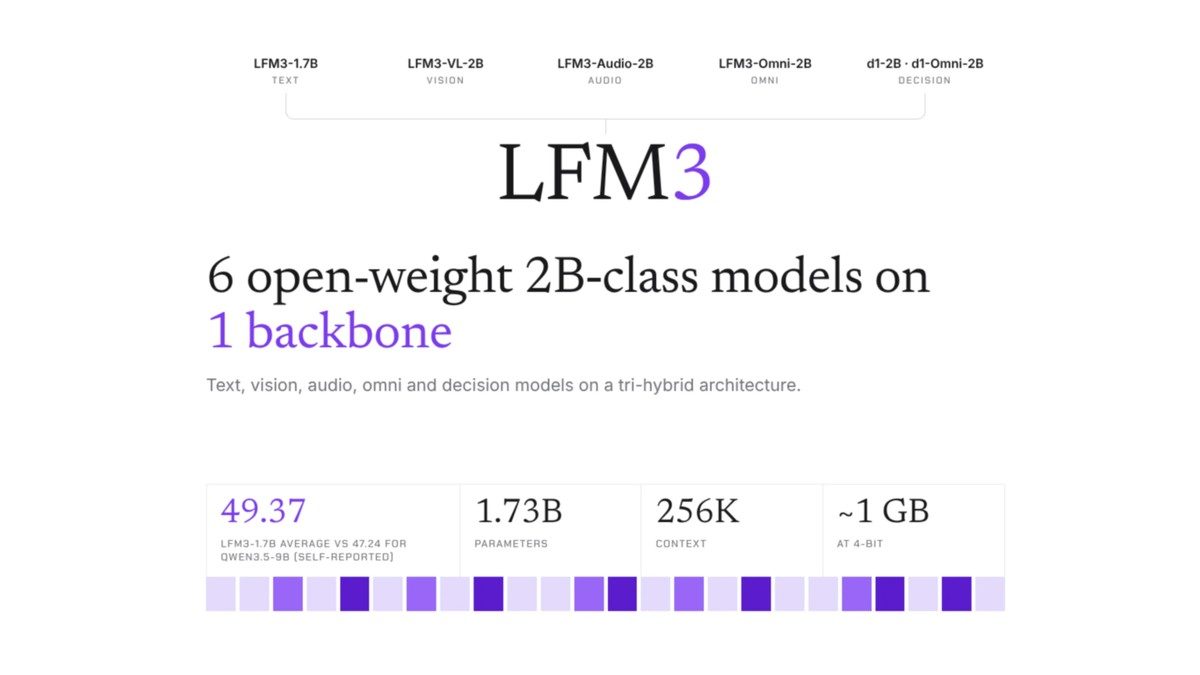
2B多模态家族装进1GB:Liquid AI LFM3 私有化落地的硬件选型账
Liquid AI 发布 LFM3:六个开放权重 2B 级多模态模型共享一个 1.7B 底座,4-bit 量化约 1GB 即可运行、单卡可微调。本文从端侧单板到单张 B300,给私有化部署方拆了三笔硬件账。
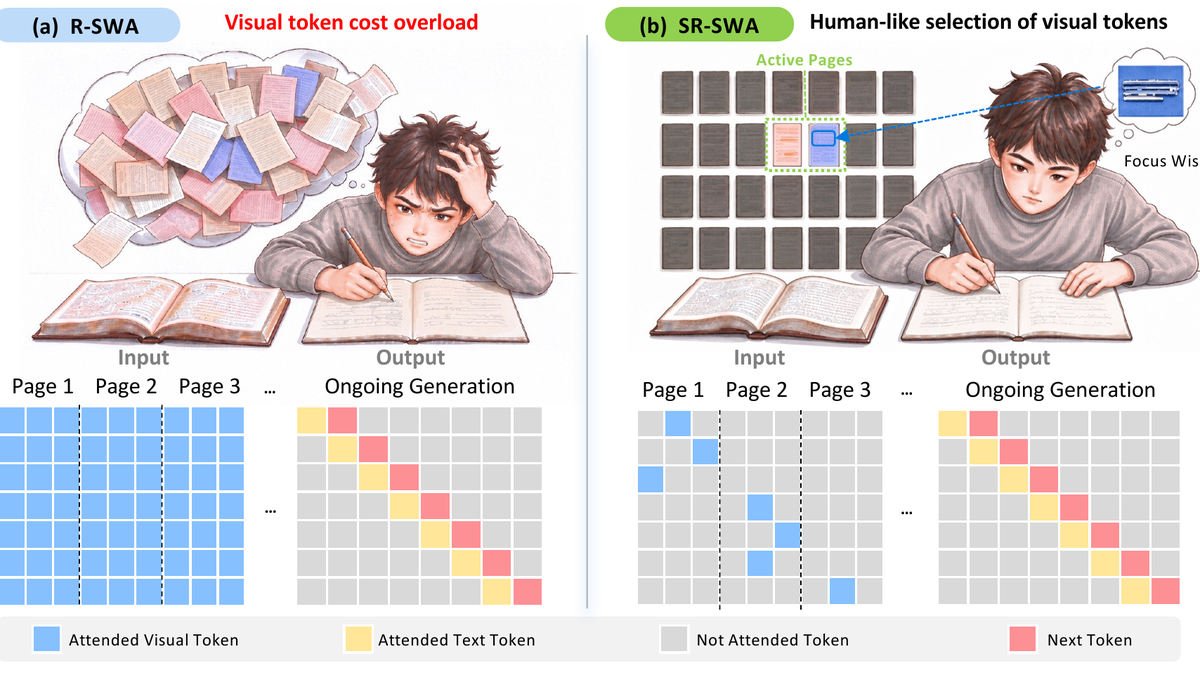
一次请求读完一本书:百度 MIT 开源 Unlimited OCR 2,私有化部署一张 80GB 卡起步
10月27日百度 MIT 开源 Unlimited OCR 2:3B 参数,SR-SWA 稀疏滑窗注意力把超长途注意力压进固定 512 token 参考窗口,解码时延与显存几乎恒定,一次请求解析百页文档。官方验证于 A800 80GB,SGLang/vLLM 现成,MIT 无商用附加条款,附私有化成本测算。