
笔记本成为推理节点:Opera WebAI 开闸,Gemma 与苹果端侧模型进浏览器
浏览器原生本地推理:WebAI 正式开闸
2026 年 10 月 27 日,Opera 在奥斯陆宣布开始向自家浏览器内置本地 AI 模型,首批预览已在 Opera One 上线,Opera GX 与 Opera Neon 随后跟进。这次发布的核心是 WebAI——一个被 Google、微软等公司支持的「提议中」Web 标准,允许网站和浏览器扩展调用运行在用户自己电脑上的 AI 模型。官方口径里,模型并不被锁定:实现是 model-agnostic 的、围绕开放权重模型构建,首发可用 Google 的 Gemma,Mac 上还支持 Apple 设备端基础模型。
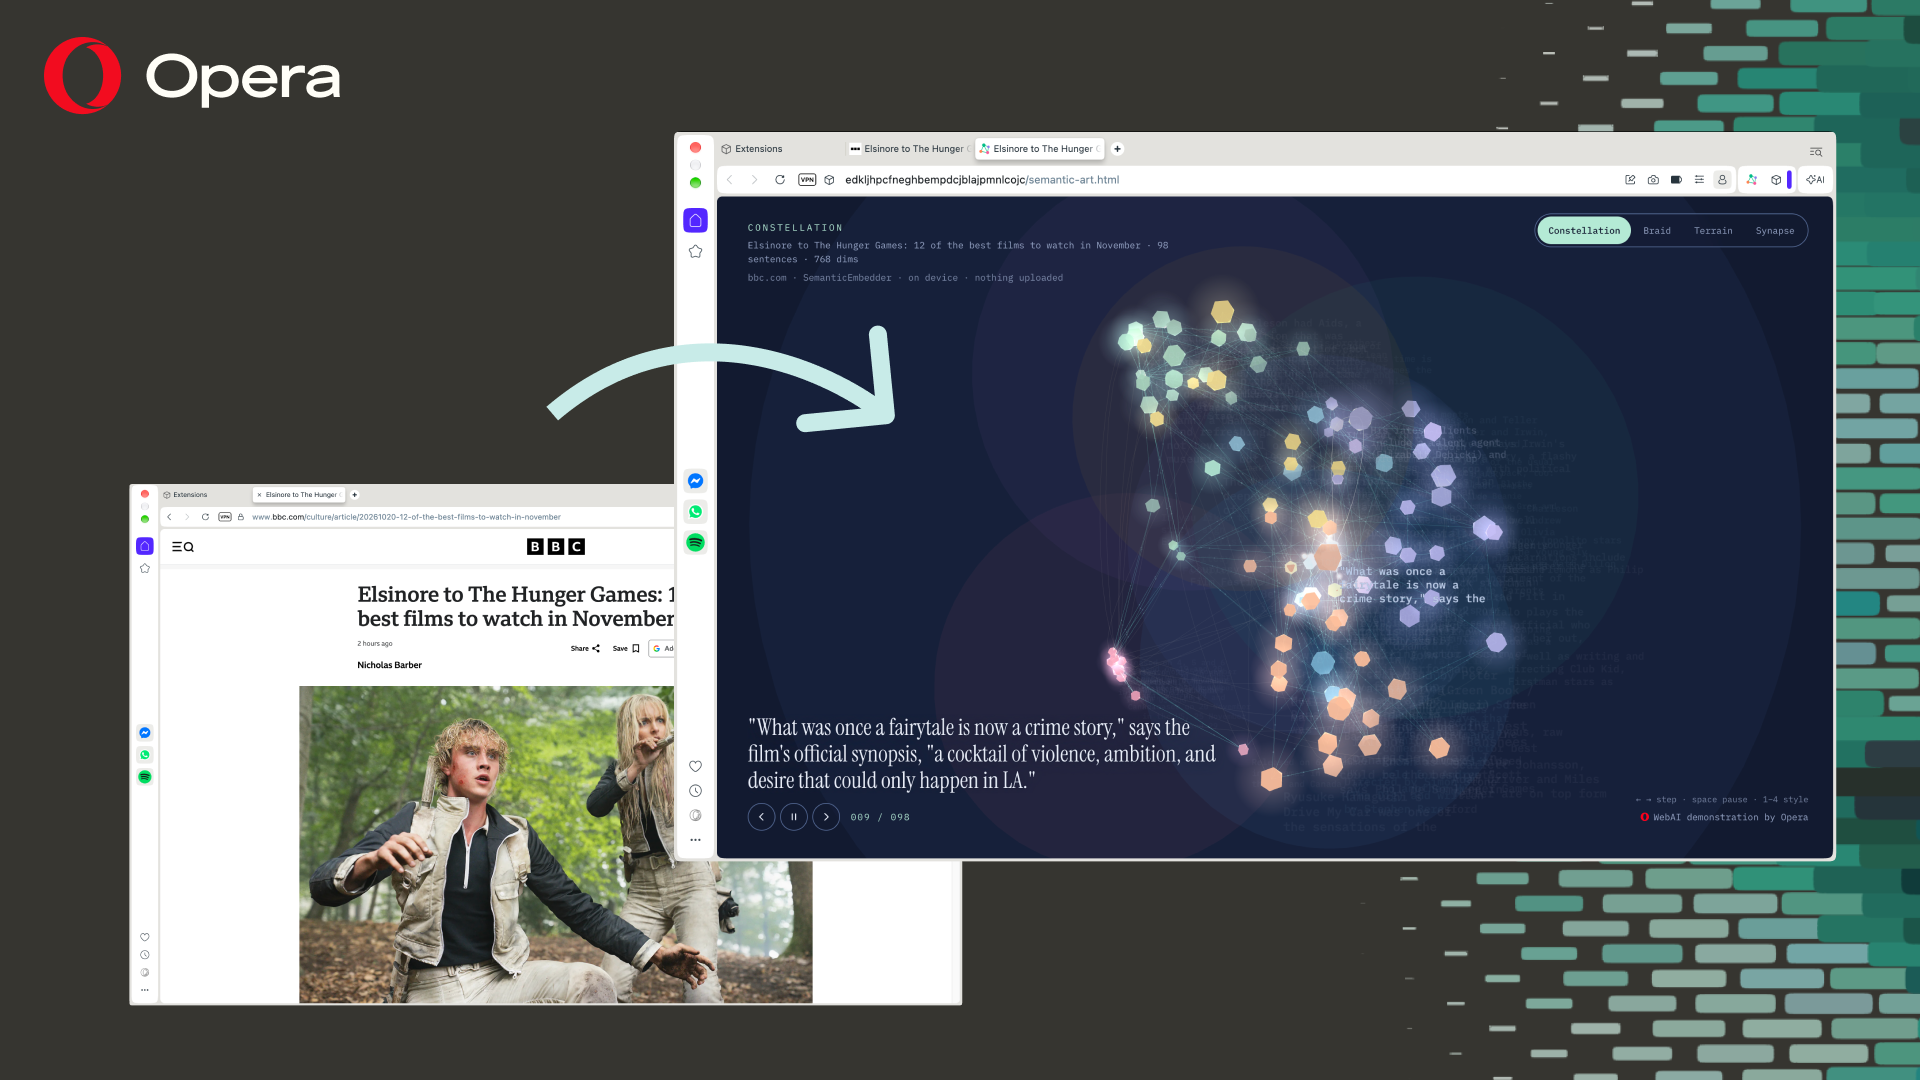
能力面共三项:文本生成、内容分类、理解信息片段之间的关系,全部在浏览器内完成。官方示例很具体:一个扩展可以在你的笔记本上整理标签页、标记标题党、挑出与你相关的招聘信息——不需要账号、不收费,数据也不发往任何 AI 服务。交互上 WebAI 是完全 opt-in:用户不开启就不下载任何东西,站点级权限决定哪些网站能调用本地 AI。平台支持 64 位 Windows PC(Intel 或 AMD)和 Apple 芯片 Mac,官方明确写着「性能取决于本地硬件」。
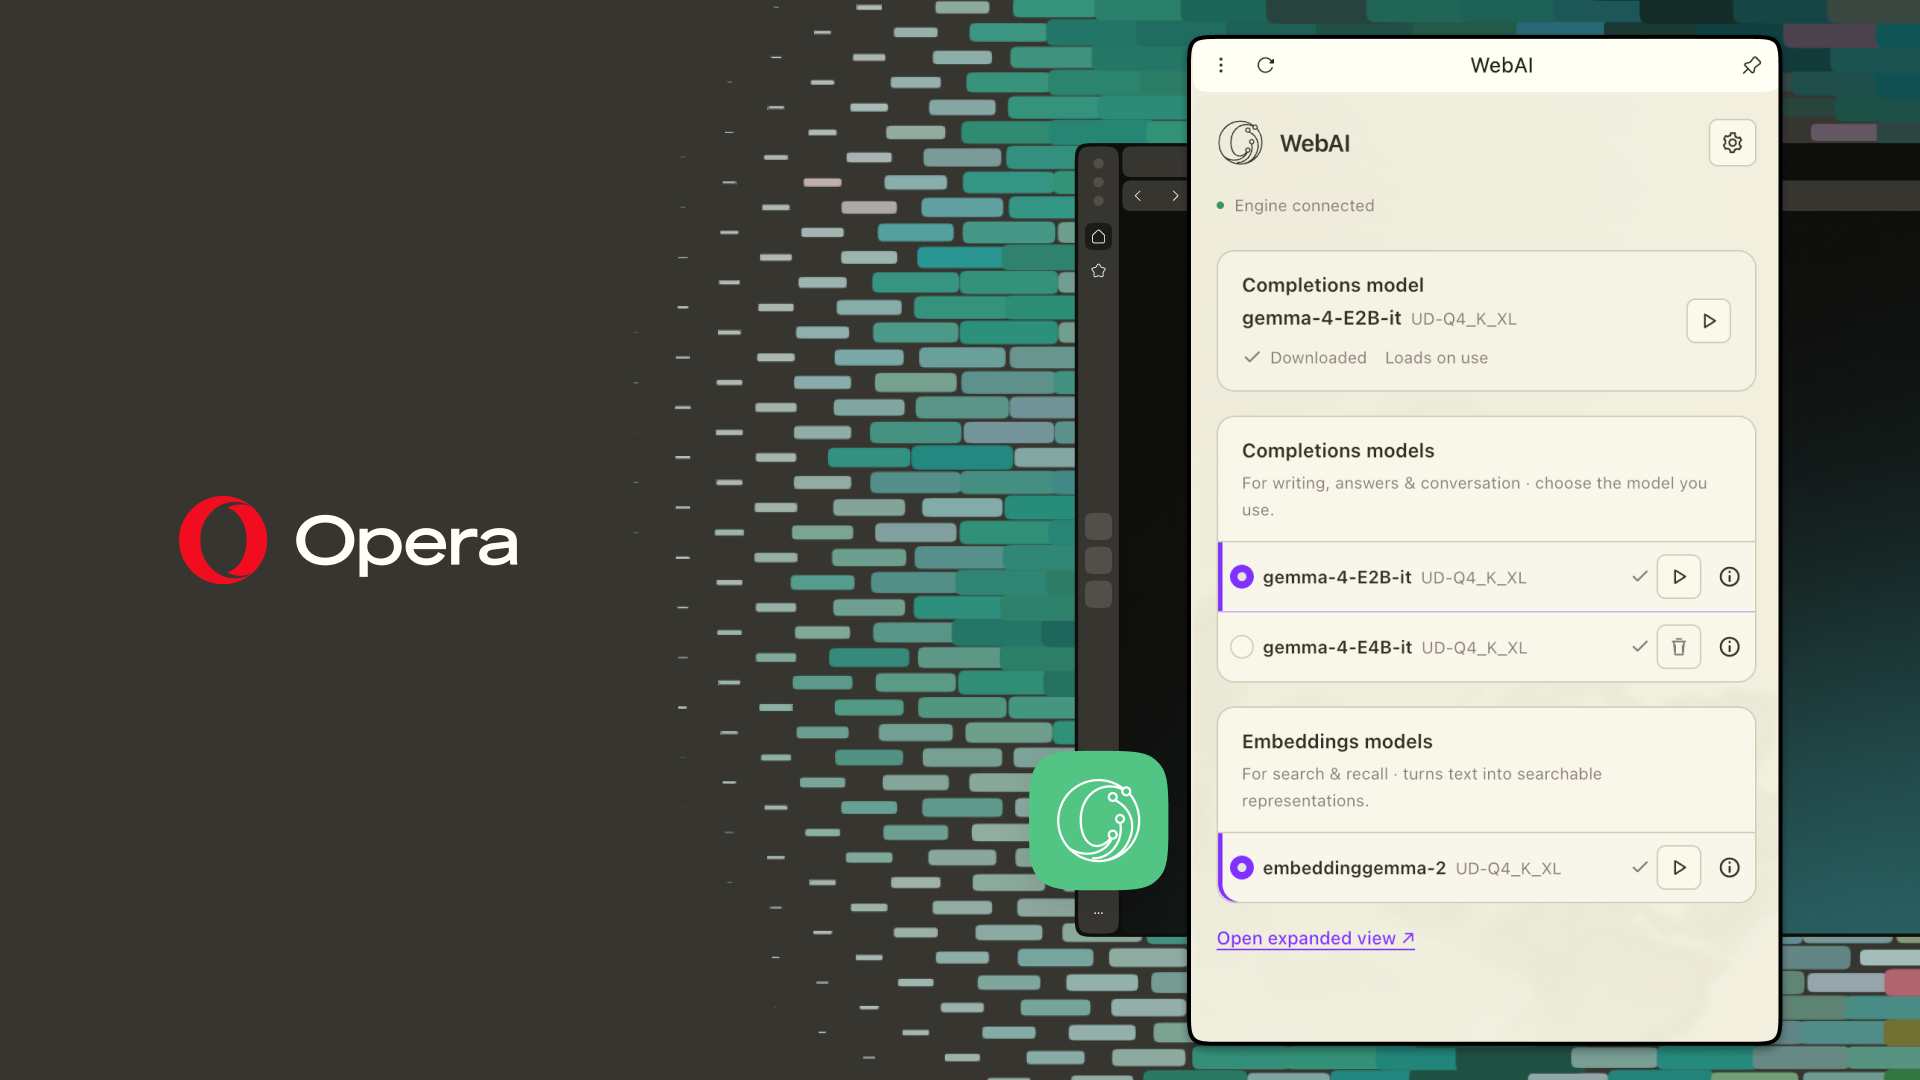
时间线回看,这不是 Opera 第一次碰本地模型:2024 年它曾是首个在开发者构建中提供本地模型接入的主流浏览器,当时通过 Ollama 框架提供约 150 个模型变体、单个占 2–10GB 存储(厂商自报)。本次发布把这项能力从开发者构建搬进了日常浏览器,官方表示后续会推出面向不同设备的更多开放模型与配套工具。同日还发布了 HTML-in-Canvas,允许开发者把可交互的网页嵌进 2D/3D 场景,演示项目 Webpage Bulldozer 与 Gamer Room 在浏览器中开箱即用。
部署视角:笔记本本身就是推理节点
放到私有化的语境里,WebAI 是一种「端侧化到极限」的形态:推理节点既不是机房里的卡,也不是自建的本地网关,而是用户手里的笔记本。这个选型的直接含义是不需要独立显卡——64 位 CPU 或 Apple 芯片的统存就够跑 Gemma 这一档的小模型,也不用再搭 Ollama/vLLM 服务层,浏览器就是运行时。成本账更简单:零按次计费、零订阅、数据零出设备。对「数据不出楼」的合规场景,这是投入最低、落地最快的形态——一次浏览器更新就完成了部署,资产盘点就是员工手里已有的设备。
企业试用时建议核对两件。其一,WebAI 仍是「提议中」的标准,API 面未定稿,扩展开发者要留迁移余地;其二,模型菜单目前只有 Gemma 与 Apple 设备端模型两个选项,中文与垂直域能力需要各自实测,官方没有给出这两类模型在浏览器场景下的任何基准数据——相关性能表述都按厂商自报理解,拿到手先在真实任务上回测一遍。
观察:数据中心不再是私有 AI 的唯一解,部署边界正在往终端用户那边再推一步;最轻部署形态的硬件选型题,悄悄变成了「员工手里已经有多少台设备」。
来源:Opera 官方新闻稿(2026-10-27)、TechCrunch、9to5Mac;能力清单与平台细节为厂商自报。