
2B多模态家族装进1GB:Liquid AI LFM3 私有化落地的硬件选型账
它发布了什么:六个模型,一个底座,全部开放权重
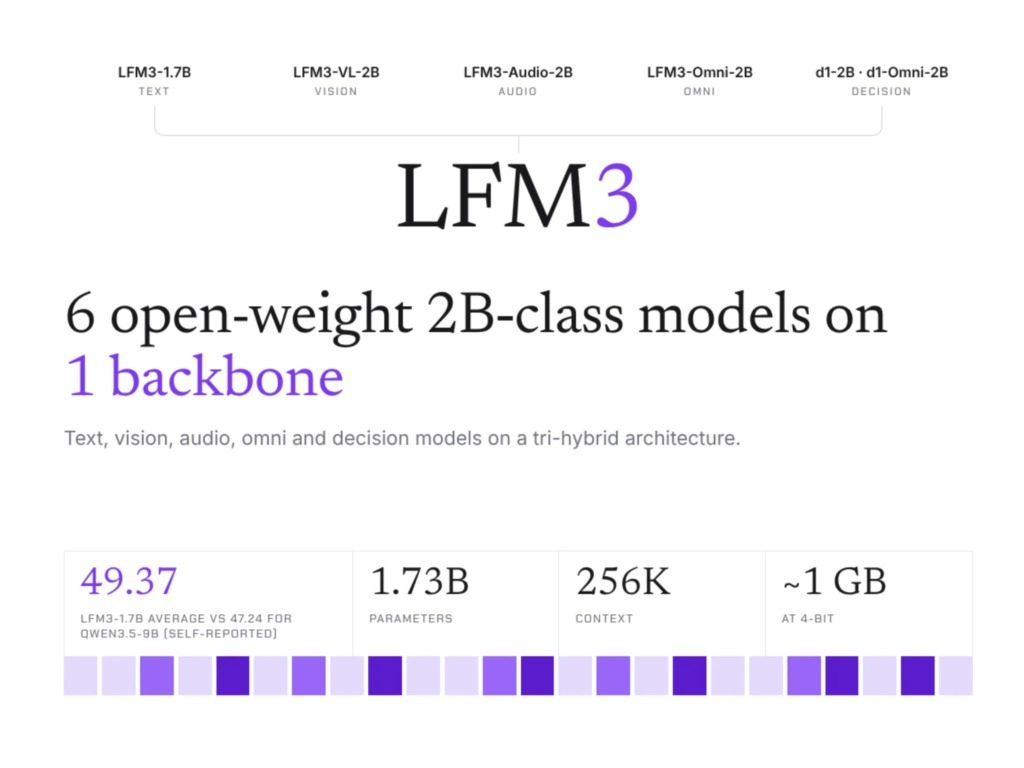
10月27日,Liquid AI 发布了新一代 Liquid Foundation Model LFM3。首批包含六款模型:文本模型 LFM3-1.7B(17.3亿参数、256K 上下文)、视觉语言模型 LFM3-VL-2B(LFM 系首次支持视频输入)、音频模型 LFM3-Audio-2B(18 种语言,支持语音对话与工具调用)、全模态模型 LFM3-Omni-2B(文本/图像/视频/音频输入,可同时输出文字与语音),以及两款"一次前向回答多道题"的决策模型 d1-2B 与 d1-Omni-2B。六款全部从同一个 LFM3-1.7B-Base 底座分叉而来,基础权重与后训练权重同步以 LFM Open License v1.0 开放,已在 Hugging Face 上架。按厂商披露:底座在 22 万亿 token 上预训练,其中最后 3.5 万亿为智能体任务为主的中间训练,同时把上下文窗口拉到 256K。
架构是照着硬件设计的,不只是照着算法
LFM3 底座采用三混合结构:24 层里 13 层是门控短卷积(卷积核从 3 加宽到 7)、5 层滑动窗口注意力(窗口 256 token)、6 层全局注意力。对私有化部署方真正值得注意的,是它的"硬件在环"架构搜索——调优对象从 LFM2 时代的一部手机加一台笔记本,扩展到 14 种设备与后端组合:三星 Galaxy S26 Ultra、一加 15 等手机,树莓派 5,Apple M4 Max、AMD Ryzen AI 笔记本,Arm 与 x86 云 CPU,GPU,以及高通 Hexagon NPU。也就是说,这套架构是照着真实终端调出来的。官方口径:六款模型 4-bit 量化后约 1GB 内存即可运行,并随包提供 GGUF、MLX、ONNX、FP8、NVFP4 等检查点,原生支持 llama.cpp、MLX、vLLM。
私有化落地账:三笔硬件账
第一笔,端侧:Liquid AI 基于 LFM3-VL-2B 微调的机器人 VLA 控制模型,在 Jetson AGX Orin 上生成八步动作序列耗时低于 50 毫秒(TensorRT FP16,厂商自报)。这意味着感知-控制闭环可以整条放进一块单板,不再依赖云端往返。第二笔,微调侧:官方为六款模型提供了 SFT、DPO、GRPO 微调教程,单卡即可完成,企业不需要为定制领域数据租卡池。第三笔,高吞吐服务侧:厂商自报单张 NVIDIA B300 在 1024 并发下每天可推 36 亿 token。想自建高 QPS 小多模态助手的企业,单卡配置就能做试运行线,不必一上来就是集群。首批落地伙伴包括 Ambarella、AMD、Arm、Intel(OpenVINO)、NVIDIA、高通(AI Hub/GenieX)、Vercel 等,奔驰与 Shopify 参与了发布前测试——海外主流芯片平台的部署通道一次铺齐。
观察
2B 级模型家族的意义不在跑分本身,而是把"多模态+智能体+决策"的能力,压进了"端侧运行+单卡微调"的价位带。对私有化部署客户来说,这是第一次可以按模态矩阵采购——视觉、音频、校准决策输出不再各买各的大模型,验收标准也从"能不能跑"变成"能不能塞进手机、机器人、屏幕这些端侧设备"。需要提示的风险:文中基准与吞吐数字多为厂商自报,国产算力平台上的实测数据仍是空白,采购前建议按自己的设备清单先做一轮实测。
来源:Liquid AI 官方博客(liquid.ai/blog/lfm3,2026年10月27日),交叉参考 NCIJ Network、Unite.ai、AI Weekly 等报道;基准与吞吐数字除特别注明外均为厂商自报。