
一次请求读完一本书:百度 MIT 开源 Unlimited OCR 2,私有化部署一张 80GB 卡起步
10月27日,百度把第二代长文档解析模型 Unlimited OCR 2 正式开源:3B 参数、MIT 许可,权重同步上架 Hugging Face、ModelScope、GitHub 与百度智能云。它瞄准的是「OCR-3.0 时代」的一个核心痛点:几百页、上千页的文档,怎么一次解析完,还让显存和时延不随文档变长而失控。对私有化部署的团队来说,这类模型的价值直接写在采购清单上——一张卡的预算,就能把整条文档数字化链路搬进内网。
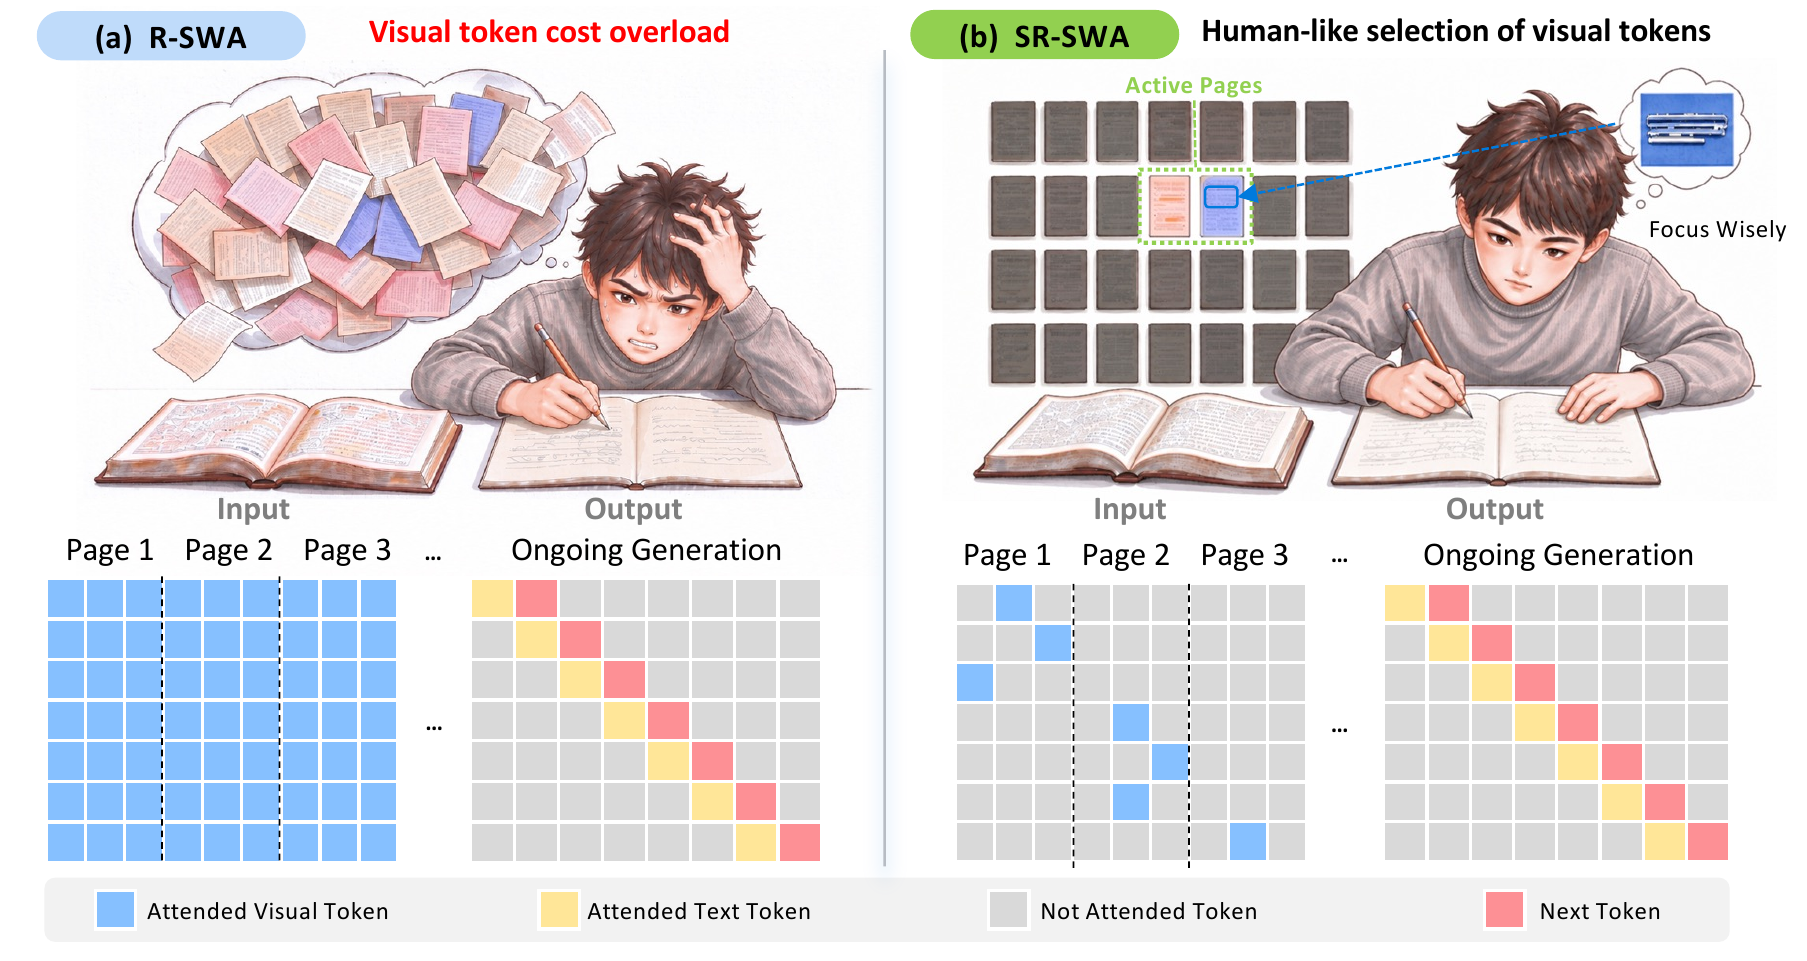
SR-SWA:把「无限上下文」装进有限窗口
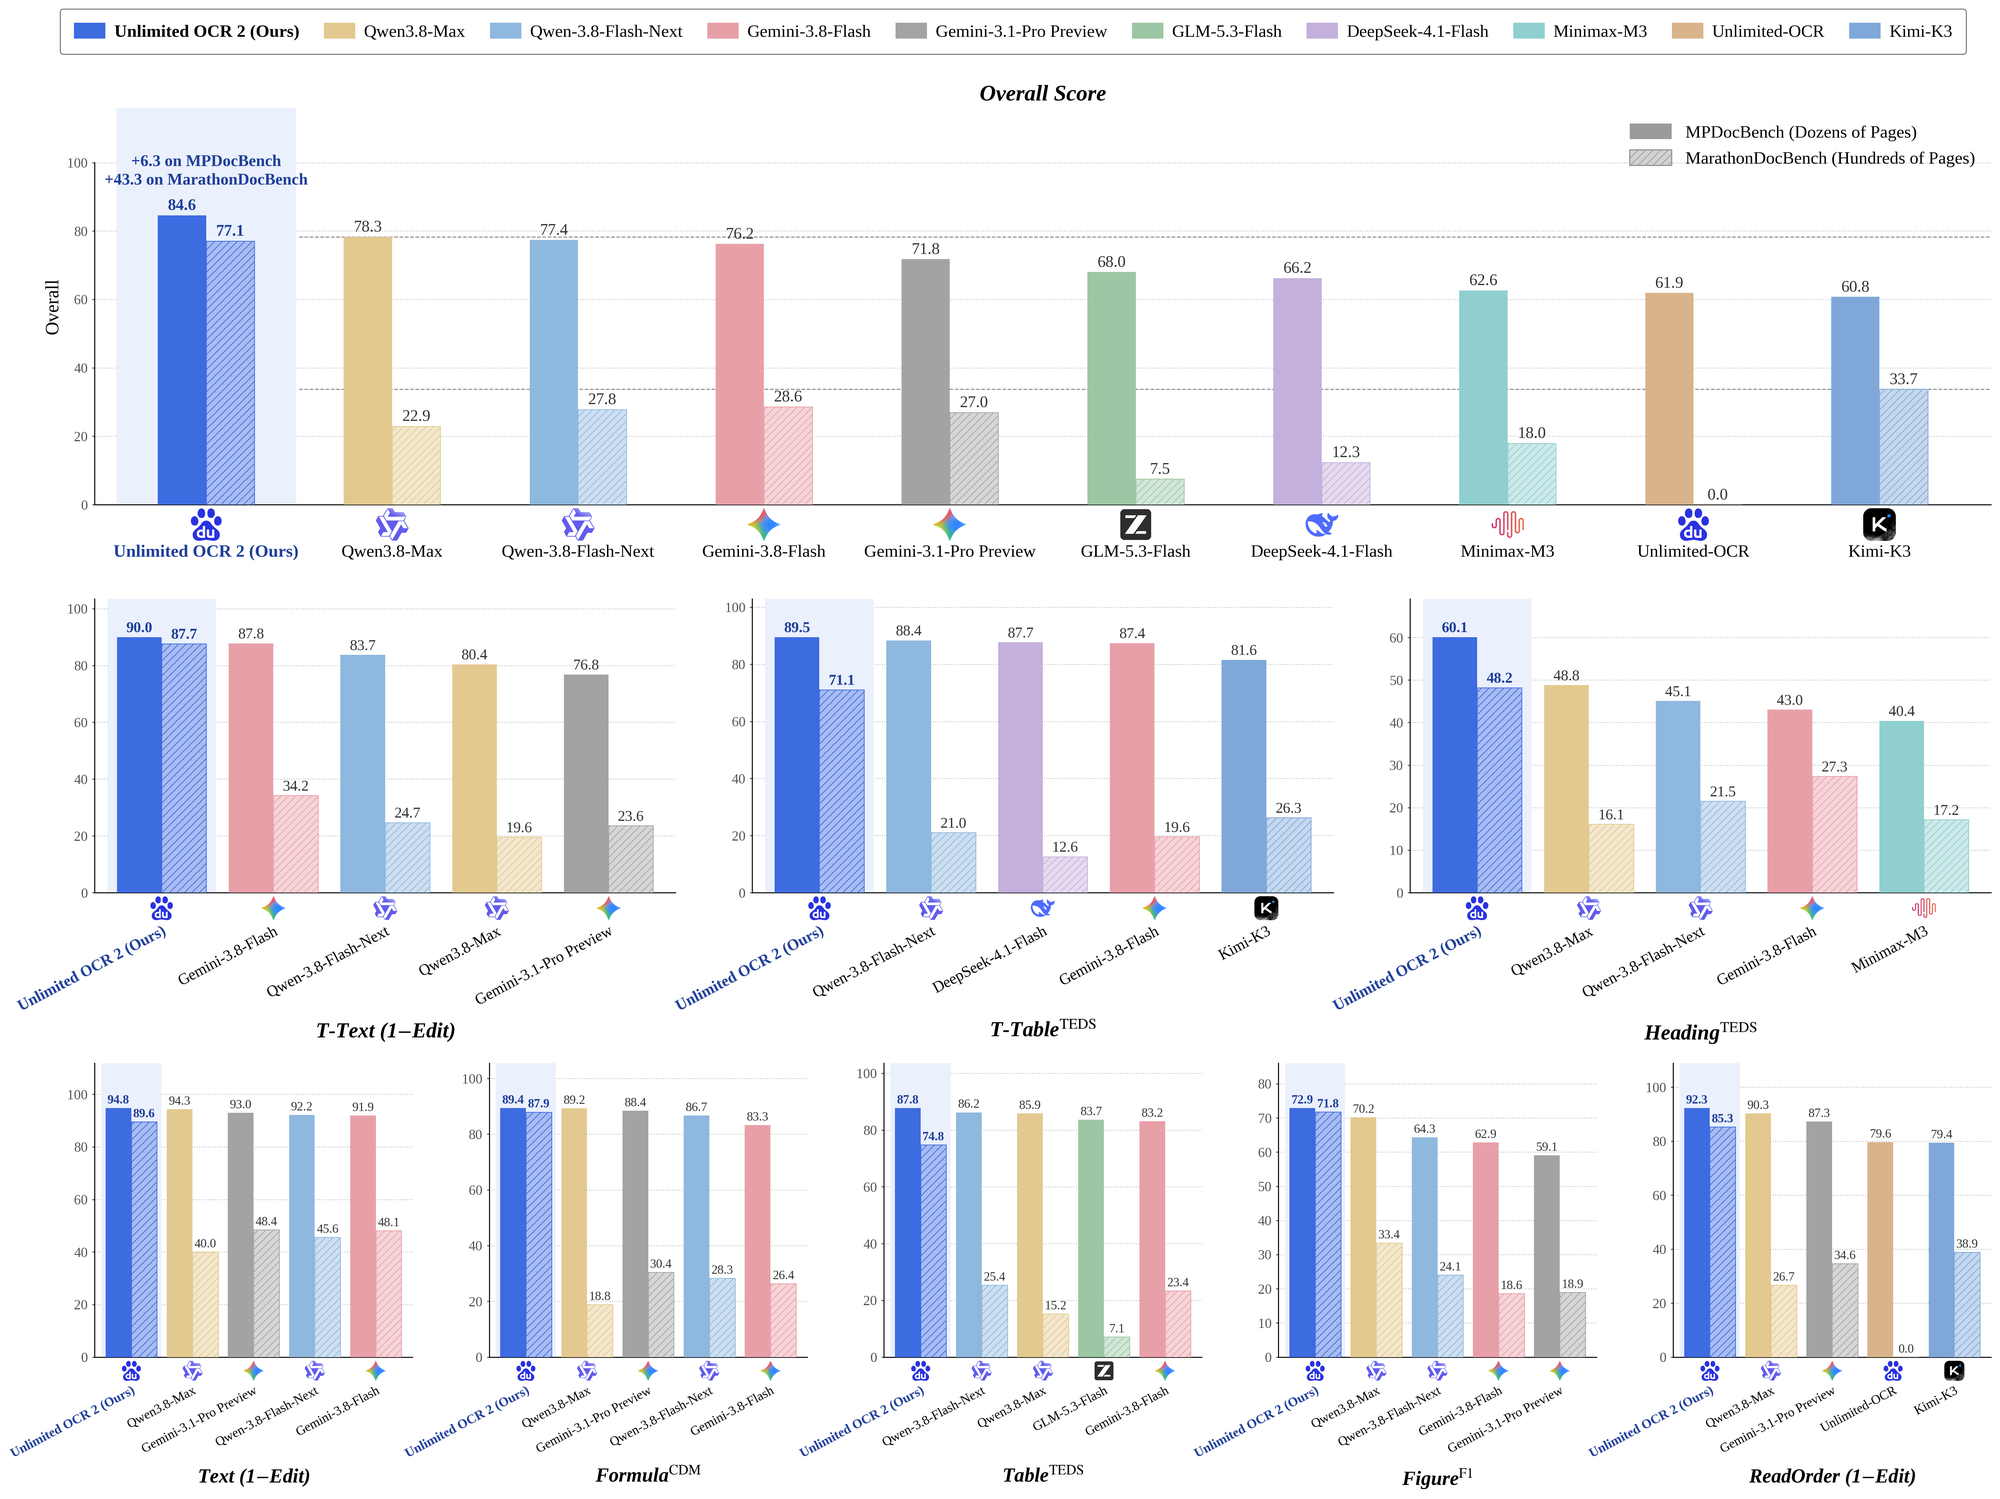
初代 Unlimited-OCR 已经能做到一次读几十页,2 代把目标推到了百页级。核心改动是 稀疏参考滑窗注意力(SR-SWA):把超长途的文本-视觉注意力交互压缩到一个固定大小的参考窗口(约 512 个 token),不再需要的 KV 缓存随用随释放。效果是解码每步的时延和内存占用几乎恒定——机器不会因为文档越读越长而越跑越慢,也彻底绕开了传统架构里注意力随长度平方级膨胀的瓶颈。百度同日放出新基准 MarathonDocBench(百页级),并声明模型在几十页(MPDocBench)与百页两个梯队上都拿到当前最优。另外这套注意力机制是通用的,论文里明说可以迁移到语音识别、翻译这类参考型任务。
硬件清单:一张 80GB 卡即可私有化起步
这是部署团队最关心的部分。3B 参数,按每参数 2 字节估算,BF16 权重在 6-7GB 量级——卡的预算大头不是权重,而是视觉 token 与 KV 缓存,官方模型卡明确验证环境是 NVIDIA A800 80GB,国内同规格 80GB 卡可以直接顶上去,不必追最新型号。部署通道现成两条:Transformers 原生加载用于快速验证;SGLang 是官方推荐的生产服务方案(装定制 wheel,PDF 转图用 PyMuPDF)。vLLM 社区支持 6 月底已跟上,ms-swift 微调链路也有,想针对自己文档做增强不是死路。MIT 许可意味着商用与二次修改完全放开,没有附加「商用授权」条款。
跑一笔账:单卡能顶多少页
从选型角度,Unlimited OCR 2 的卖点在「成本与文档长度脱钩」:机制上,解析一份 300 页的合同和一份 30 页的发票,不需要多配一张卡,变量只有解码时长。A800 80GB 单机单卡落地后,电费与折旧是固定的,吞吐上限由你自己的卡数决定,没有厂商侧的限速。百度云侧的异步接口 QPS 有上限(提交 2、结果 5),量一大就该换自托管。场景上,高频小文档(日结票据核验)适合排队批量化拉吞吐,低频厚文档(年报、完整合同、病历档案)正好是这套机制的主场。
企业视角:一张卡替换的是什么
百度云 API 同步上线:PDF 最大 500 页,个人实名 200 页、企业实名 1000 页免费额度——百度走的是「云 API + 开源自部署」双轨。对处理财务报表、法律文书、病历档案的团队,私有化的价值不只是省钱,而是数据不出内网;当解析量够大时,一张卡的折旧会明显低于按页付费的 API。量小的团队,先用免费额度验证解析质量再上卡,是更稳的路径。
落地前注意两点
① 基准榜上的 SOTA 数字为百度自测口径(榜单以图片形式发布,正文无逐项数字),建议拿自家文档做灰度验证;② 论文(arXiv 2606.23050)自己也承认:预填充阶段仍随页数线性增长,32K 上下文不是真正的「无限页」,路线图是 128K 上下文与「预填充池」。极厚 PDF 现阶段按文档分批解析更可靠。集成时留意:多页输入要按页序传给 infer_multi 接口,单页输出上限 20000 tokens(厂商示例自报口径)。
来源:百度开源仓库与模型卡(Hugging Face / GitHub / ModelScope,MIT)、arXiv 2606.23050、MarkTechPost、百度智能云 API 文档