
国产950芯片上市即适配:ForgeKernel四榜登顶,私有化算力成本能省一半吗
过去几年,私有化部署的行业共识是:先把模型选好,再找一块跑得动的卡。但真正拖住落地进度的,常常不是模型,而是模型与芯片之间那"最后一公里"——算子。同一个模型、同一块国产芯片,换一套更优的算子,吞吐和首字延迟可能差出好几倍。而高性能算子长期靠资深工程师逐一手写调优,周期长、门槛高。对新上市的国产芯片,配套算子库还在建设期,人工适配的那段空窗期,往往就是项目被拖最久的环节。四榜同时登顶:一次打通国产与英伟达两条路线
面壁智能 10 月 28 日披露,其自研的 AI 算子生成系统 ForgeKernel,在同一批次里同时登顶华为 CANNBench 的 950DT、950PR、A3 三块硬件榜,以及英伟达 SOL-ExecBench(FlashInfer-Bench 合集)。一套通用算子优化系统,同时把国产芯片和英伟达两条硬件路线都跑通——这件事本身,比任何单榜第一都更值得做私有化部署的团队留意。三个数字,目前都来自面壁官方自报
看 950PR:ForgeKernel 以总分 3736.44 排第一,领先第二名约 5.2%,基准加速比 1.886 倍,约为第二名(1.181 倍)的 1.6 倍。面壁据此估算,同等硬件投入下可用算力接近翻倍,企业的算力采购与部署成本可相应降低约一半。950DT 上总分 3903.96、领先第二名 37.1%,加速比 1.523 倍;A3 上总分 4338.67、领先第二名 7.1%。这三块华为国产新芯片榜的成绩,目前只有面壁官方通稿一家披露,属厂商自报,尚未见第三方复测。交叉认证:从"两榜第一"到"四榜登顶"
把时间轴拉开看,这事是渐进的。早在 10 月 22 日,第一财经等已报道 ForgeKernel 登顶 CANNBench A3 与英伟达 SOL-ExecBench 两个榜,基准加速比 1.835 倍、领先第二名约 25%,并且在 DeepSeek v4.1 Flash 的算子上,用 AI 从 0 迭代的方式超越了 DeepSeek 官方开源的英伟达版本。也就是说,A3 与 SOL 两榜有多家媒体互证;而本次新增的 950DT、950PR 两块华为新芯片榜,是 10 月 28 日面壁官方口径,属单源。验收前建议向面壁或华为要一份可复现的 benchmark 说明。对私有化选型,意味着什么
对做硬件选型的团队,核心变化是:采购国产卡,不能再只看卡面跑分,而要看"这块卡上,AI 能自动写出的算子,把性能顶到硬件极限的几成"。过去新国产芯片上市,从"能用"到"跑得快"之间有一整段人工适配空窗期;ForgeKernel 这类 AI 算子生成系统,把这段空窗期压到上市即适配。落到 ROI:若 950PR 的"算力接近翻倍、成本降约一半"经第三方复测成立,那同等推理预算下,国产卡的可用性上限被明显抬高——前提是这条账要在自己实际的工作负载上重算,别直接搬厂商投影。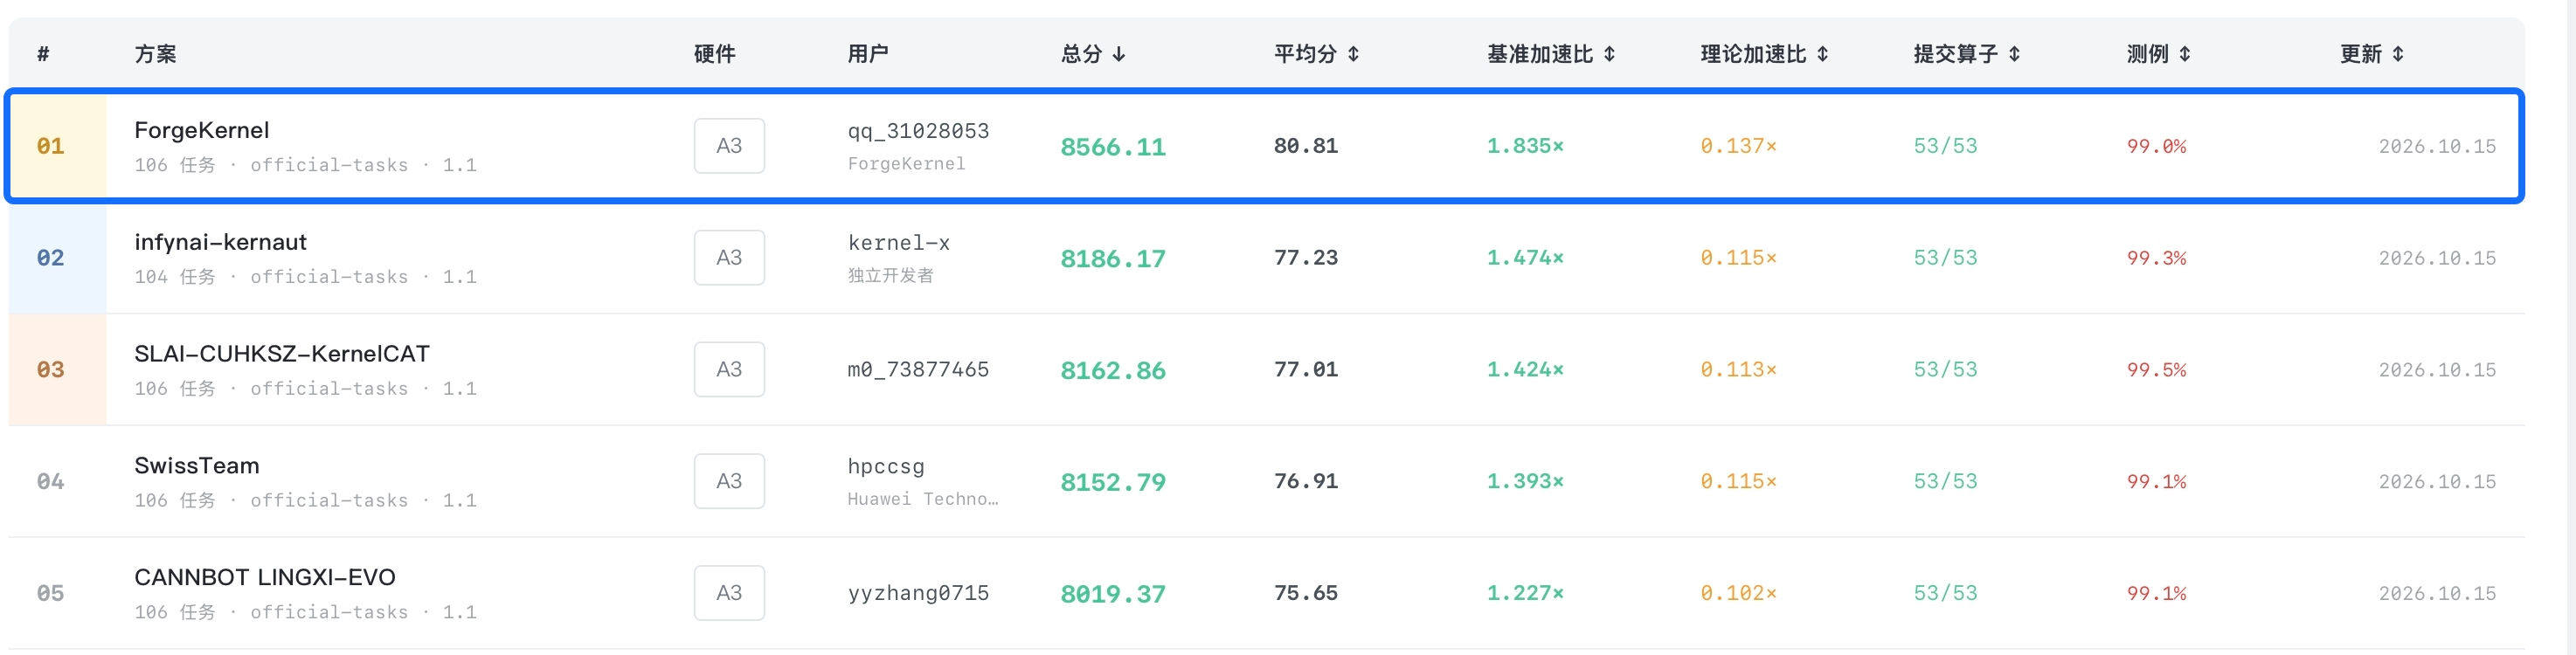
图:昇腾 CANNBench A3 硬件榜,ForgeKernel 居首(图源:第一财经)
一句话观察:国产算力的竞争,正从"造得出芯片"转向"芯片上市第一天就有可用算子"。谁先把 AI 算子这一步做进国产卡,谁就在私有化部署的采购谈判桌上多一张牌。来源:面壁智能官方通稿(同花顺财经,2026-10-28)、第一财经(2026-10-22)。950DT/950PR 加速比与成本为厂商自报,未经第三方复测。