
星火X2.6万卡集群跑通:国产算力选型,该盯的三个指标
10月22日,科大讯飞在第十届全球1024开发者节上发布端云一体模型星火X2.6:293B总参数、30B激活的MoE架构,百万Token上下文,全程在全国产算力上完成训练与推理。推理侧部署在飞星二号万卡集群上,这是国内首个"训推一体"且全栈跑在国产硬件上的通用大模型。
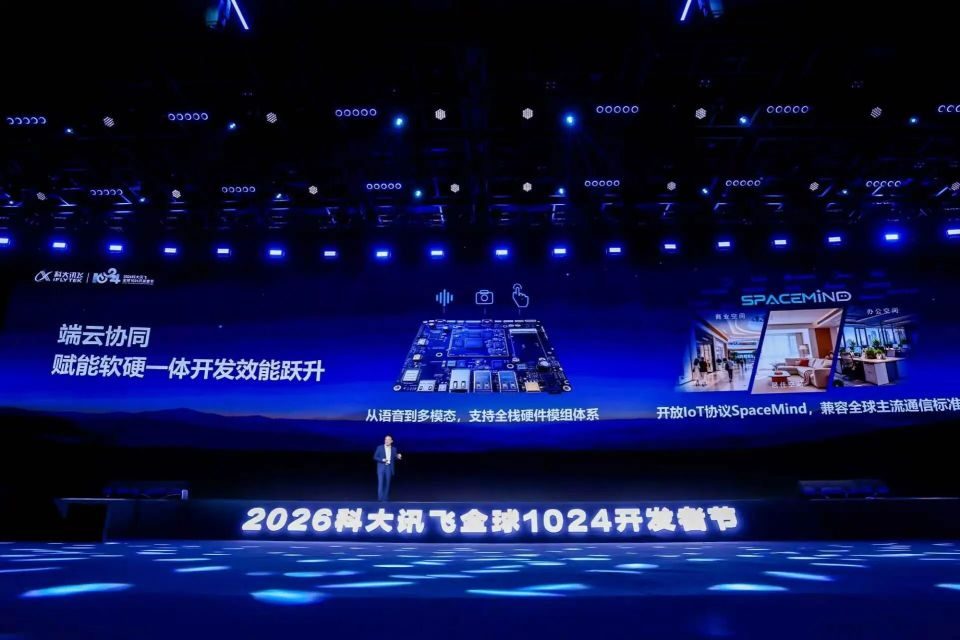
对企业做私有化部署的采购方来说,X2.6释放的信号不只是"国产卡也能跑了",而是选型逻辑需要重看。以下三个维度比跑分更值得关注。
指标一:盯内存带宽,别只看峰值算力
国产芯片在长上下文训练中的核心瓶颈不是TOPS数字,而是显存带宽。讯飞自研的长程任务动态并行训练技术,核心思路是按任务长度动态切分计算图,绕开固定并行策略的短板。飞星二号集群训练2000B规模、256K长度数据,耗时从4.5个月压缩至1.2个月,训练效率约提升4倍(厂商自报,尚无第三方复现)。
指标二:KVCache命中率决定推理成本曲线
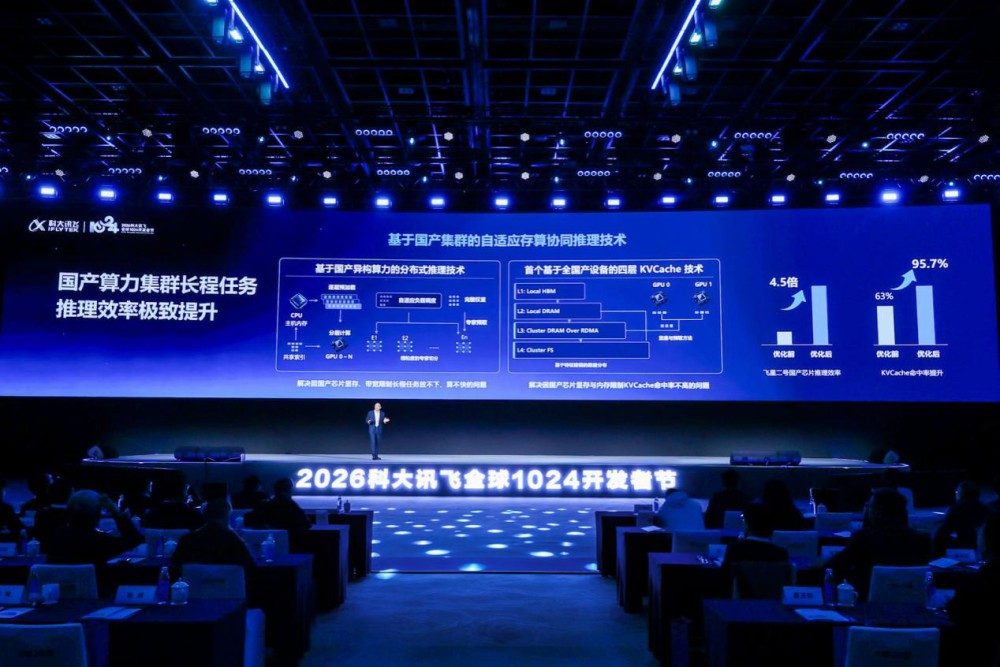
讯飞在国产异构集群上落地了业内首个四层KVCache架构:本地HBM、本地DRAM、集群RDMA内存、集群存储。官方数据:推理效率提升4.5倍,KVCache命中率从63%升至95.7%(厂商自报)。对采购方而言,这组数字直接决定同等规模国产集群能支撑多少并发推理请求——命中率每提升1个百分点,长上下文场景的单位Token推理成本就再降一截。
指标三:多平台适配,保留采购灵活性
X2.6不只跑在华为昇腾上,讯飞已同步适配寒武纪MLU590和中科海光BW1000,推动国产算力生态从"单点验证"走向"多平台协同"。多厂商适配的实际意义是:企业不必被锁死在单一芯片路线上,未来可按供货周期、性价比和软件栈成熟度灵活组合采购。
端侧部署门槛进一步降低
星火X2.6-4B是业界首个支持百万Token上下文的端侧模型,可在机器人、汽车智驾平台和AI PC上直接运行。上一代X2.5-4B开源以来(9月1日至今),下载量已突破256万次。4B参数是端侧落地的"黄金尺寸"——再大就超出终端硬件承载,再小则关键能力装不下。端云路由机制让简单任务留在本地处理,复杂任务经脱敏后上云,高频场景下Token消耗可节约约44%(厂商自报)。
选型前需注意的三个风险
第一,旗舰版293B权重未开源,当前开源的只有4B端侧版本;第二,官方未公布具体基准测试分数,仅称"达到业界领先系统的可比水平";第三,训练所用具体芯片型号与集群规模未披露,"万卡"指的是推理集群而非训练集群。建议在目标硬件上拿真实业务场景做POC验证,而非仅看跑分。
X2.6已上线讯飞开放平台,API限时6折:输入0.9元/百万Token,输出3.6元/百万Token,缓存命中0.08元/百万Token。支持专业安全防护与按场景自定义安全策略。
来源:全球时报 / 界面新闻(电厂)/ 新浪财经 / 智东西 / 科大讯飞开放平台