
首套 1024 卡昇腾 950 超节点点亮:600B 开源模型当天上国产算力,私有化三条验收线
1024 卡超节点点亮,与开源模型同日"Day-0"适配
10 月 15 日,国内算力圈发生了两件值得放在一起看的事:阶跃星辰开放了旗舰基座模型 Step 5 Preview 的模型权重,而华为首套 1024 卡昇腾 Atlas 950 SuperPoD 液冷超节点同步点亮;华为、沐曦、壁仞、摩尔线程随后都发文宣布对该模型的 Day-0 支持。据腾讯科技、IT之家报道,这是业界最大规模超节点产品的首次落地部署。
这件事对做私有化的意义,不在于"谁最快",而在于开源大模型的权重发布,不再需要等国产软件生态慢慢追平——适配周期被压缩到"当天"。
1024 卡超节点,对私有部署意味着什么
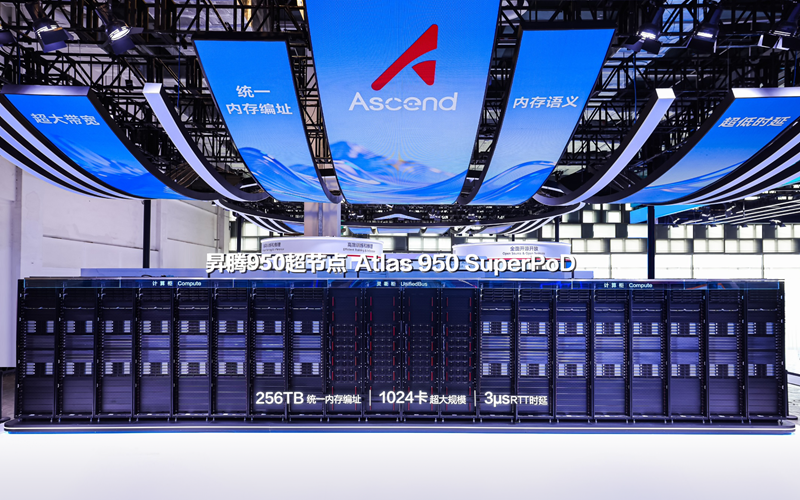
按华为官方规格页,Atlas 950 SuperPoD 基于灵衢高速互联架构,由 16 台计算柜加 4 台互联柜组成,最大支持 1024 张昇腾 950DT NPU 与 256 颗鲲鹏 950 CPU,片上内存最大 1024×96GB、带宽速率 4.0TB/s,算力为 1 EFLOPS FP8、2 EFLOPS FP4,具备 256TB 全局统一内存编址,卡间互联带宽达 TB 级、端到端时延低至 3 微秒,总互联带宽 1.72PB/s,全液冷散热、100kW 供电。上述数字经 IT时代网与华为官方规格页交叉核对,均属厂商口径。
对私有部署方,这套架构真正的价值是改变了开源大模型与硬件的关系。Step 5 Preview 总参数 600B、激活 27B,MoE 架构、1M 上下文,权重以 BF16 与 FP8 两种格式开放。粗算下来:FP8 权重约 600GB,BF16 约 1.2TB;单卡、8 卡装下权重之后,1M 长上下文的 KV cache 才是真正的压力来源。到了 1024 卡超节点,96TB 级片上内存池让权重与缓存都不再是瓶颈,瓶颈转移到吞吐、并发与通信效率。经济观察网援引华南某券商半导体分析师的说法:超节点能把通信损耗从 30%—40% 压到 10% 以内,算力利用率从 60%—70% 提到 90% 以上,万亿参数级模型训练周期从数月缩到数周——这是分析师观点,尚无独立复现。
开源侧:44 分与"1/8 成本",都要看限定条件
腾讯科技报道,Step 5 Preview 在 Artificial Analysis 综合指数上得 44 分,位居全球开源模型前三;API 价格输入 1 美元/百万 token、输出 2.7 美元/百万 token,厂商自报单任务平均成本约为 Claude Opus 5 的 1/8。注意这个"1/8"基于厂商自选的任务与配置,腾讯科技也指出该模型完成全套评测生成了大量输出 token,成本优势可能被更长的推理过程部分抵消。对私有化决策者,真正该问的不是"它便宜",而是"你的业务每月实际消耗多少 token、需要几张卡跑 Step 5 级模型"。
三条验收线,下单前先读
① 基准数字要独立复测。3 微秒 RTT、1.72PB/s 带宽、"性能持平海外先进算力"的表述都是厂商自报。采购时应要求厂商用你的真实模型(Step 5 Preview 或存量模型)跑长时混合负载并给出实测数据,写入验收条款后再签字。
② 超节点是门槛,不是终点。目前公开的都是千卡级面向大型数据中心,没有入门档。中小团队建议"购买超节点容量"与"继续用开源模型 API"两条线并行报价:月 token 消耗量没到能把硬件摊薄的量级时,API 路线的综合成本往往更低。
③ 成本账要用自己的 A/B 复测。"闭源的 1/8 成本"是方向性锚点,不是报价。同一任务并行跑闭源 API 与自托管开源模型 4 周,把硬件摊销、人力、GPU 利用率都算进单任务总成本,才能得到可决策的 TCO 数字。
来源:腾讯科技、IT之家、北京商报(经东方财富网)、华为昇腾官网、经济观察网;其中"1 EFLOPS / 256TB / 3μs / 1.72PB/s"等硬件数字与"1/8 成本"为厂商自报或引述分析师观点,未经独立复现。