
两类芯片共享一个端点:llm-d 1.0 混编机房的硬件选型账与四组生产数据
一种端点,两类芯片
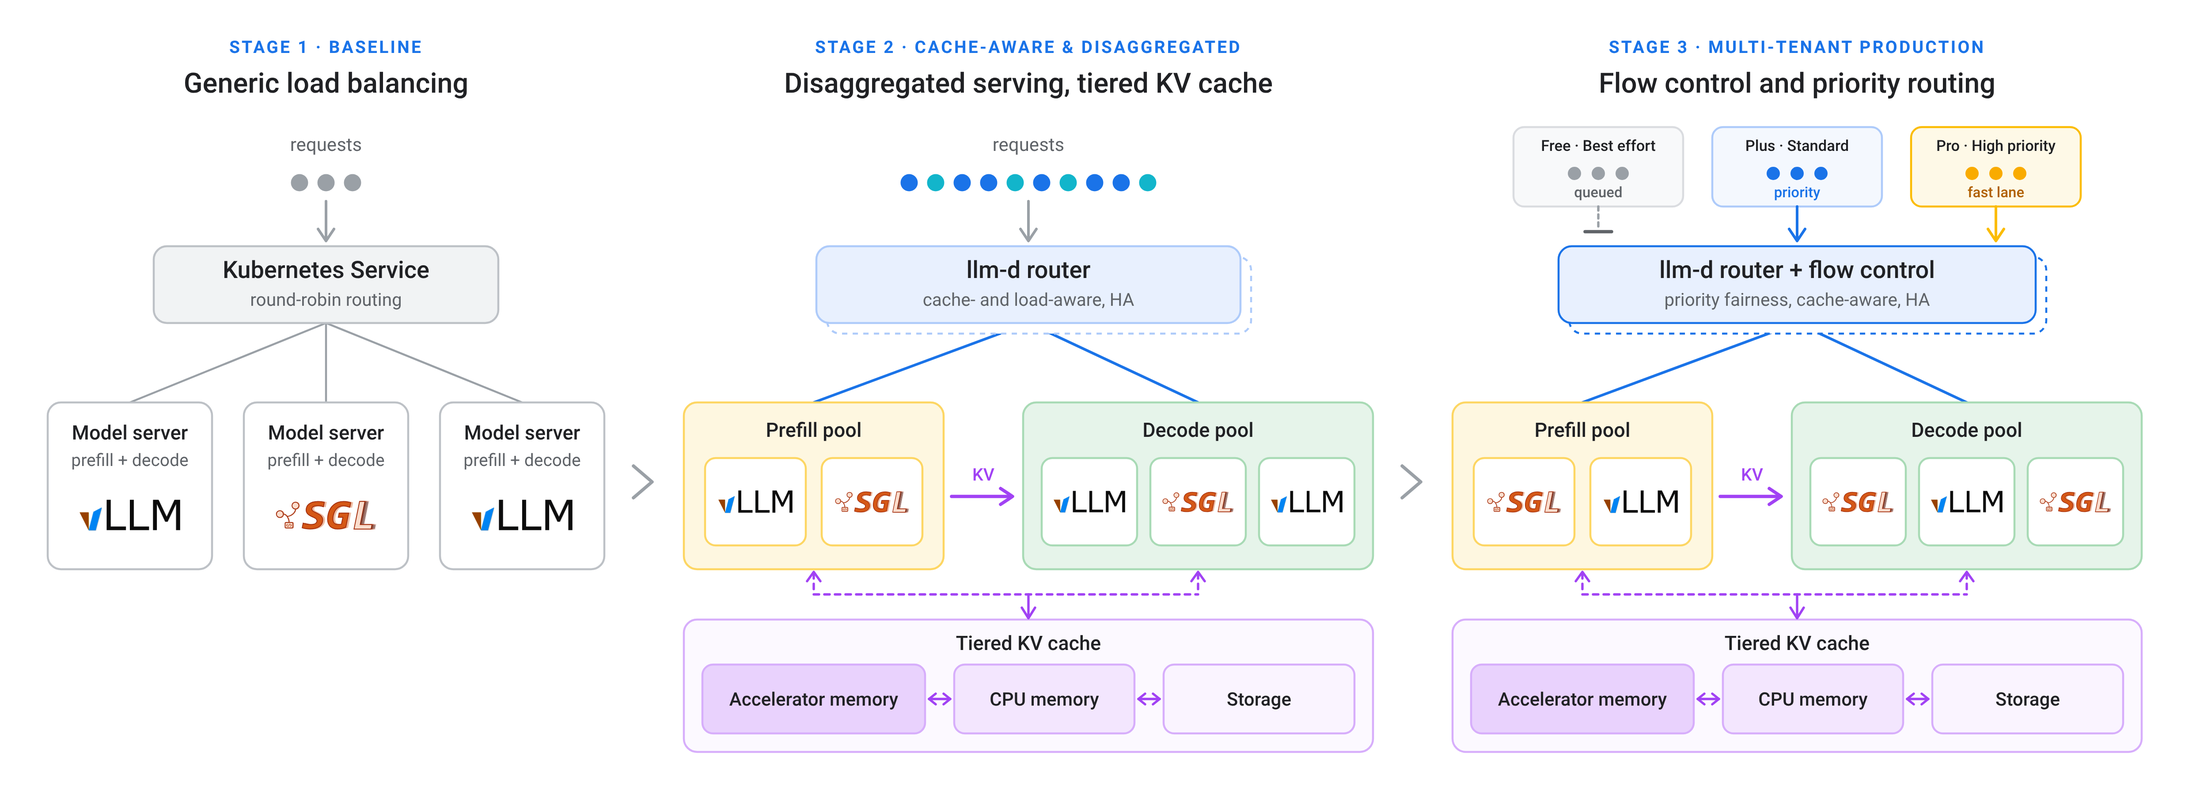
10月20日,分布式推理框架llm-d 1.0在 PyTorch 北美大会发布,现已纳入 CNCF 治理。项目由 Red Hat、IBM、Google Cloud、CoreWeave、NVIDIA 于 2025 年共同创立,AMD、Intel、Mistral、JetBrains 等加入共建,累计 500 多名贡献者、25 家以上组织。1.0 的重心不在单点性能,而在「Day 2 运维」:稳定的 v1 配置 API、多租户服务质量(优先级加公平性流控,突发流量不饿死交互请求)、路由器热备加滚动升级的零停服能力,以及会话感知的智能体路由。
对私有化部署方,最关键的一条是把不同代际、不同体系的加速器放在同一个端点后面:一个路由层、一个 KV 缓存索引、一套流控策略覆盖整个推理池,扩容或混入新芯片是平台层变更,不用改上层应用。新加入的 TorchTPU 让 TPU 在上游 vLLM/SGLang 里原生跑 PyTorch 模型,机房的 TPU 池可以直接并入 GPU 推理集群,而不是两套栈各管各的。
四组生产数据点
官方给出的四组生产数字,均为厂商自报,私有化立项前建议在自己的负载上复测:一是 TPU 7x 上的智能体编程负载,前缀感知路由加主机内存 KV 卸载,把中位 TTFT 砍掉 85% 以上,总吞吐提升 2.4 倍(相对原生 K8s Service);二是 Gemini 平台(原 Vertex AI)生产流量,前缀缓存命中率从 35% 提到 70%,编程智能体 TTFT 降 35% 以上,突发会话 P95 TTFT 降 50% 以上;三是 1.7 万节点多区域 MoE 部署,三集群吞吐 2.9 倍、成功率 99.9%、路由开销小于 1%;四是 A3 Mega 跑 70B 模型,KV 缓存三级卸载(HBM 到主机内存再到共享存储)让 TTFT 改善约 40%,5 万 token 提示的端到端时延降 30%,GPU 时数省近 60%。
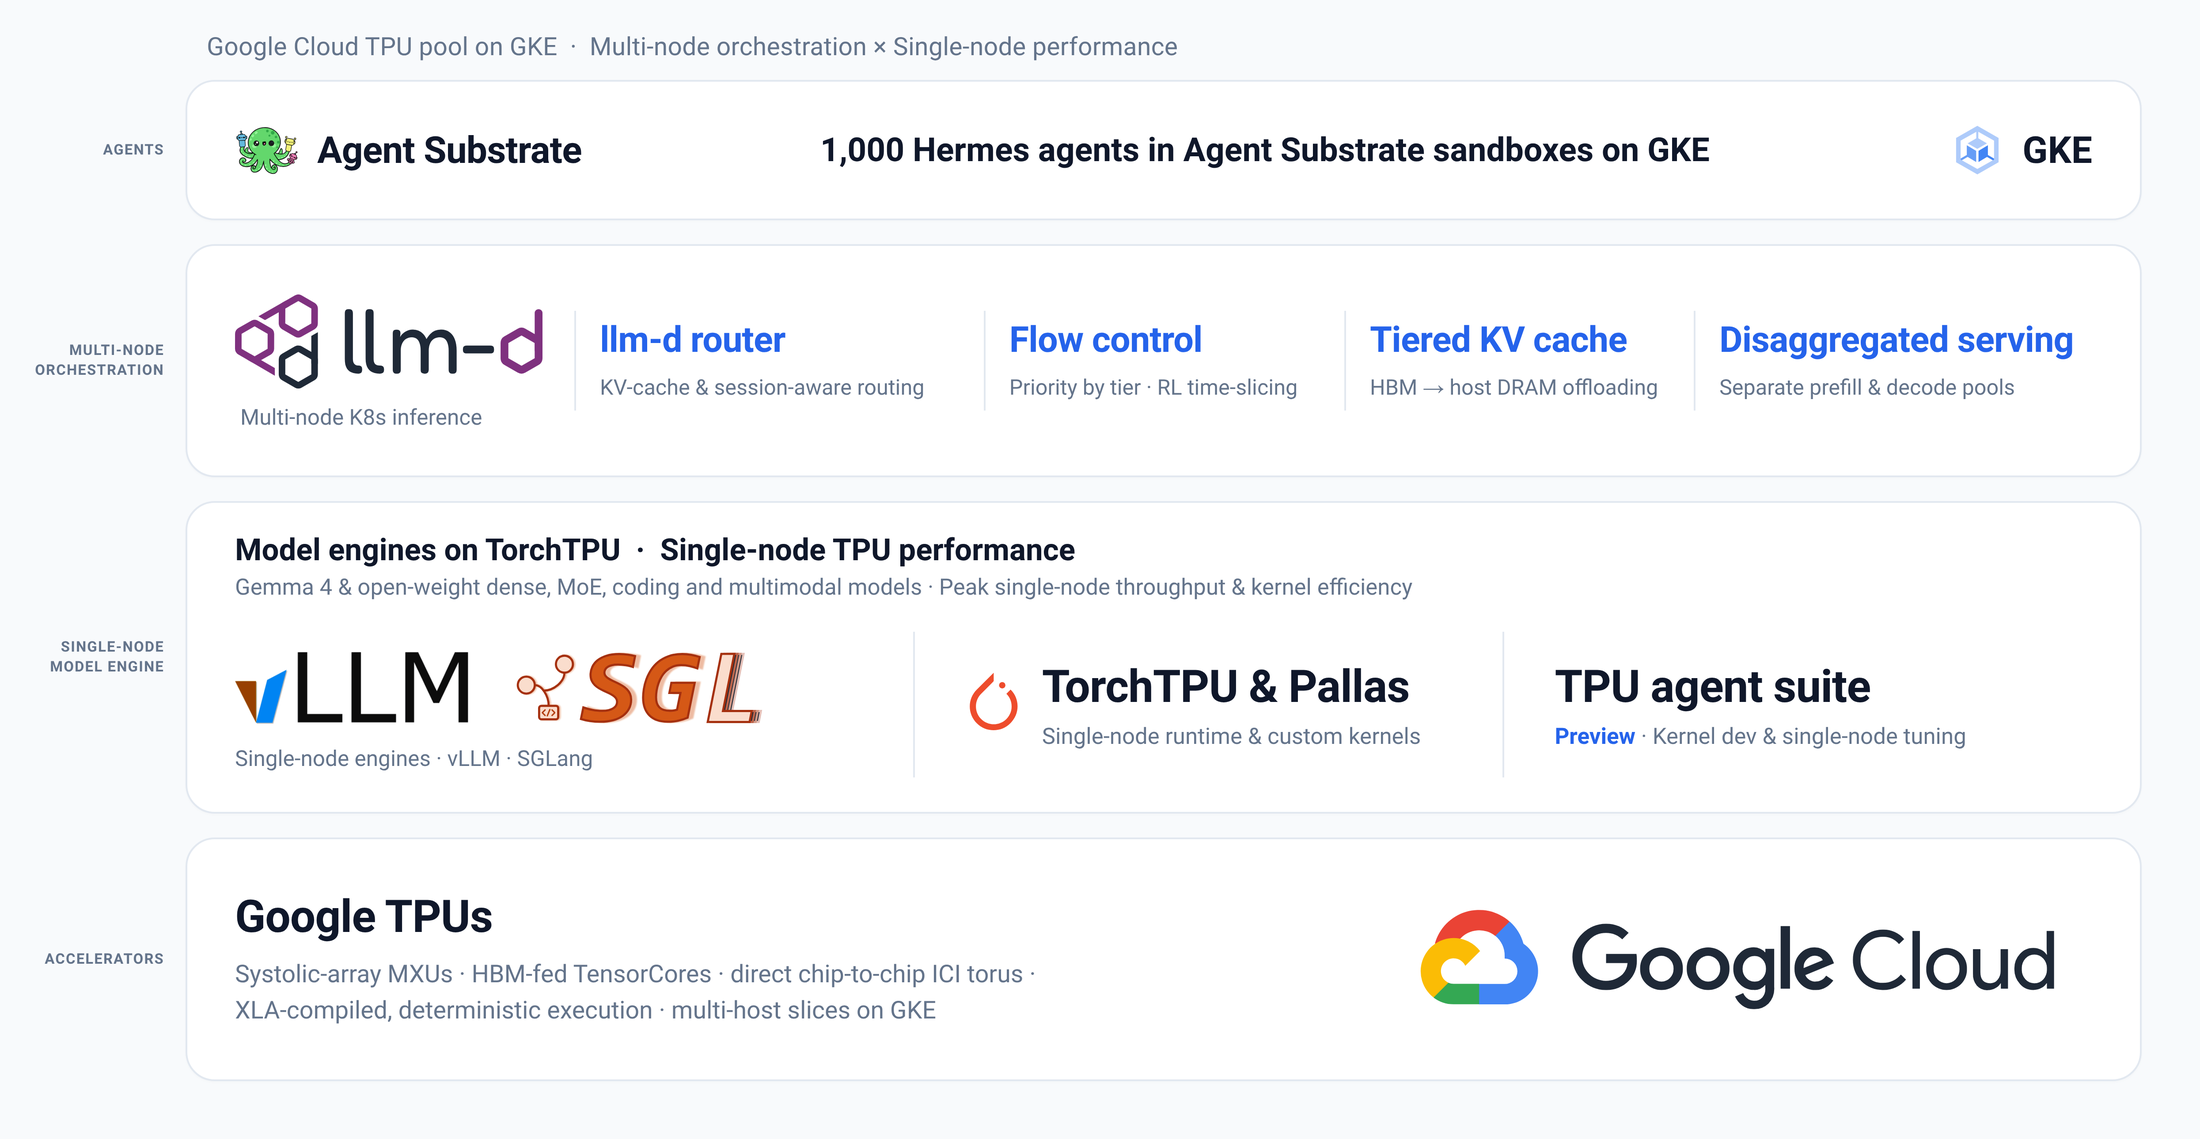
交叉参照两组:AWS 自报在 SageMaker HyperPod 上把 llm-d 与 NIXL 配对,输出吞吐较标准 vLLM 最高提升 70%;客户 ZenteiQ 自报 1000 块 TPU v6e 的日生成量从 14.7 亿 token 提到 59.7 亿,约 4 倍。不同厂商的口径差异,恰好说明这类数字要当方向性参考,而不是验收基线。
私有化选型三笔账
一、缓存分层账。上下文重的负载(长会话智能体、高前缀重复)把 KV 卸载从 HBM 一路加到主机内存、SSD 或共享存储。官方示例用 Google 托管 Lustre 做远端层,私有化对应自建 NFS/Ceph 或 SSD 池即可,直接决定长会话场景的重算成本。
二、专家并行的互联账。大 MoE 模型开宽专家并行时,耦合的并行组要落在同一互联域的加速器上(官方路径覆盖 H100/H200、B200、GB200 NVL72/GB300 机架内 NVLink)。国产算力侧,社区已为壁仞 BI-V150、沐曦 C500X 提供部署路径,采购国产卡时可在标书里加一条「Day-0 推理框架适配证明」。
三、零停服验收线。路由器热备加修订感知路由、PD 分离副本锁步升级、多租户优先级带 SLO——这三项 1.0 全部转正,验收时可以直接写进条款,而不是等运维事故再补课。
一句观察
推理框架正在产品化成「多云、多硅、引擎无关」的公共底座。私有化团队采购的不再是单卡或单引擎,而是带路由、缓存与 SLO 的端点;API 与自建的价差,正在被运维成熟度而非单点基准重新定价。
来源:Google Cloud Blog、llm-d 官方博客、IBM Research、Red Hat 新闻稿、AWS ML Blog(2026-10-20 前后);文中性能数据均为厂商自报。