
录音不出机房:Nemotron 3.5 Transcribe 单卡私有转写的档位表与成本账
它是什么:一个开放权重模型,管掉转写、归因与翻译
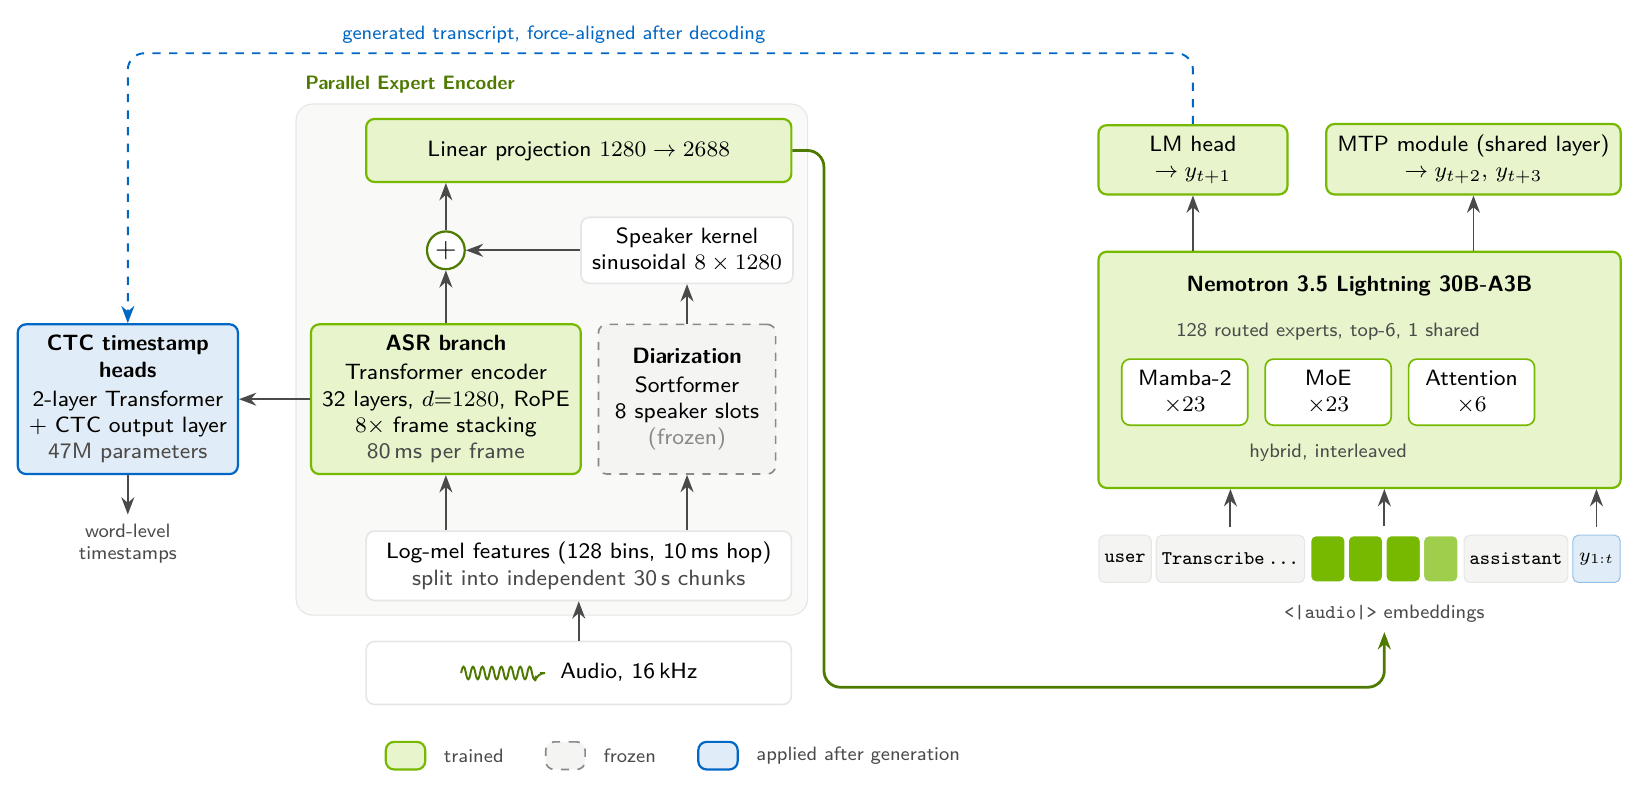
10 月 28 日,英伟达发布 Nemotron 3.5 Transcribe:开放权重的语音大模型(SALM),总参数 30B、每 token 激活约 4.3B(Mamba-Transformer 混合 MoE),支持 40 种语言、单段 1 小时录音与最多 8 位说话人。同一个模型完成逐字/书面转写、上下文转写、说话人归因、语音翻译与语种识别,转写风格靠自然语言指令切换,不用重训。权重以 OpenMDW-1.1 协议放出、允许商用,提供 BF16、FP8、NVFP4、GGUF 四档 checkpoint,随附 NeMo Speech 微调工具链与开放数据集 Granary v2(48 种语言)。
硬件档位:一张 80GB 卡跑满,不用多机
官方模型卡给出的部署档位很直白:1 张 H100 80GB 跑 BF16 版(vLLM 0.32.0 配方),30B 权重 BF16 约 60GB,80GB 卡刚好吃下并给 KV 缓存留了余量;想留出并发余量,就上 Blackwell 的 NVFP4(RTX PRO 6000 / B200 / GB300),权重体积再砍到三分之一。The Decoder 的交叉验证也点名:它「从最小的 DGX Spark 到数据中心整机都能在单张英伟达 GPU 上跑」。对私有化采购来说这是个好信号——转写这类音频负载的算力门槛比 816B 旗舰文本模型低一个量级,一整条会议记录管线可以闭环在一台机器里。
精度:榜单上「激活参数最小、成绩贴顶」
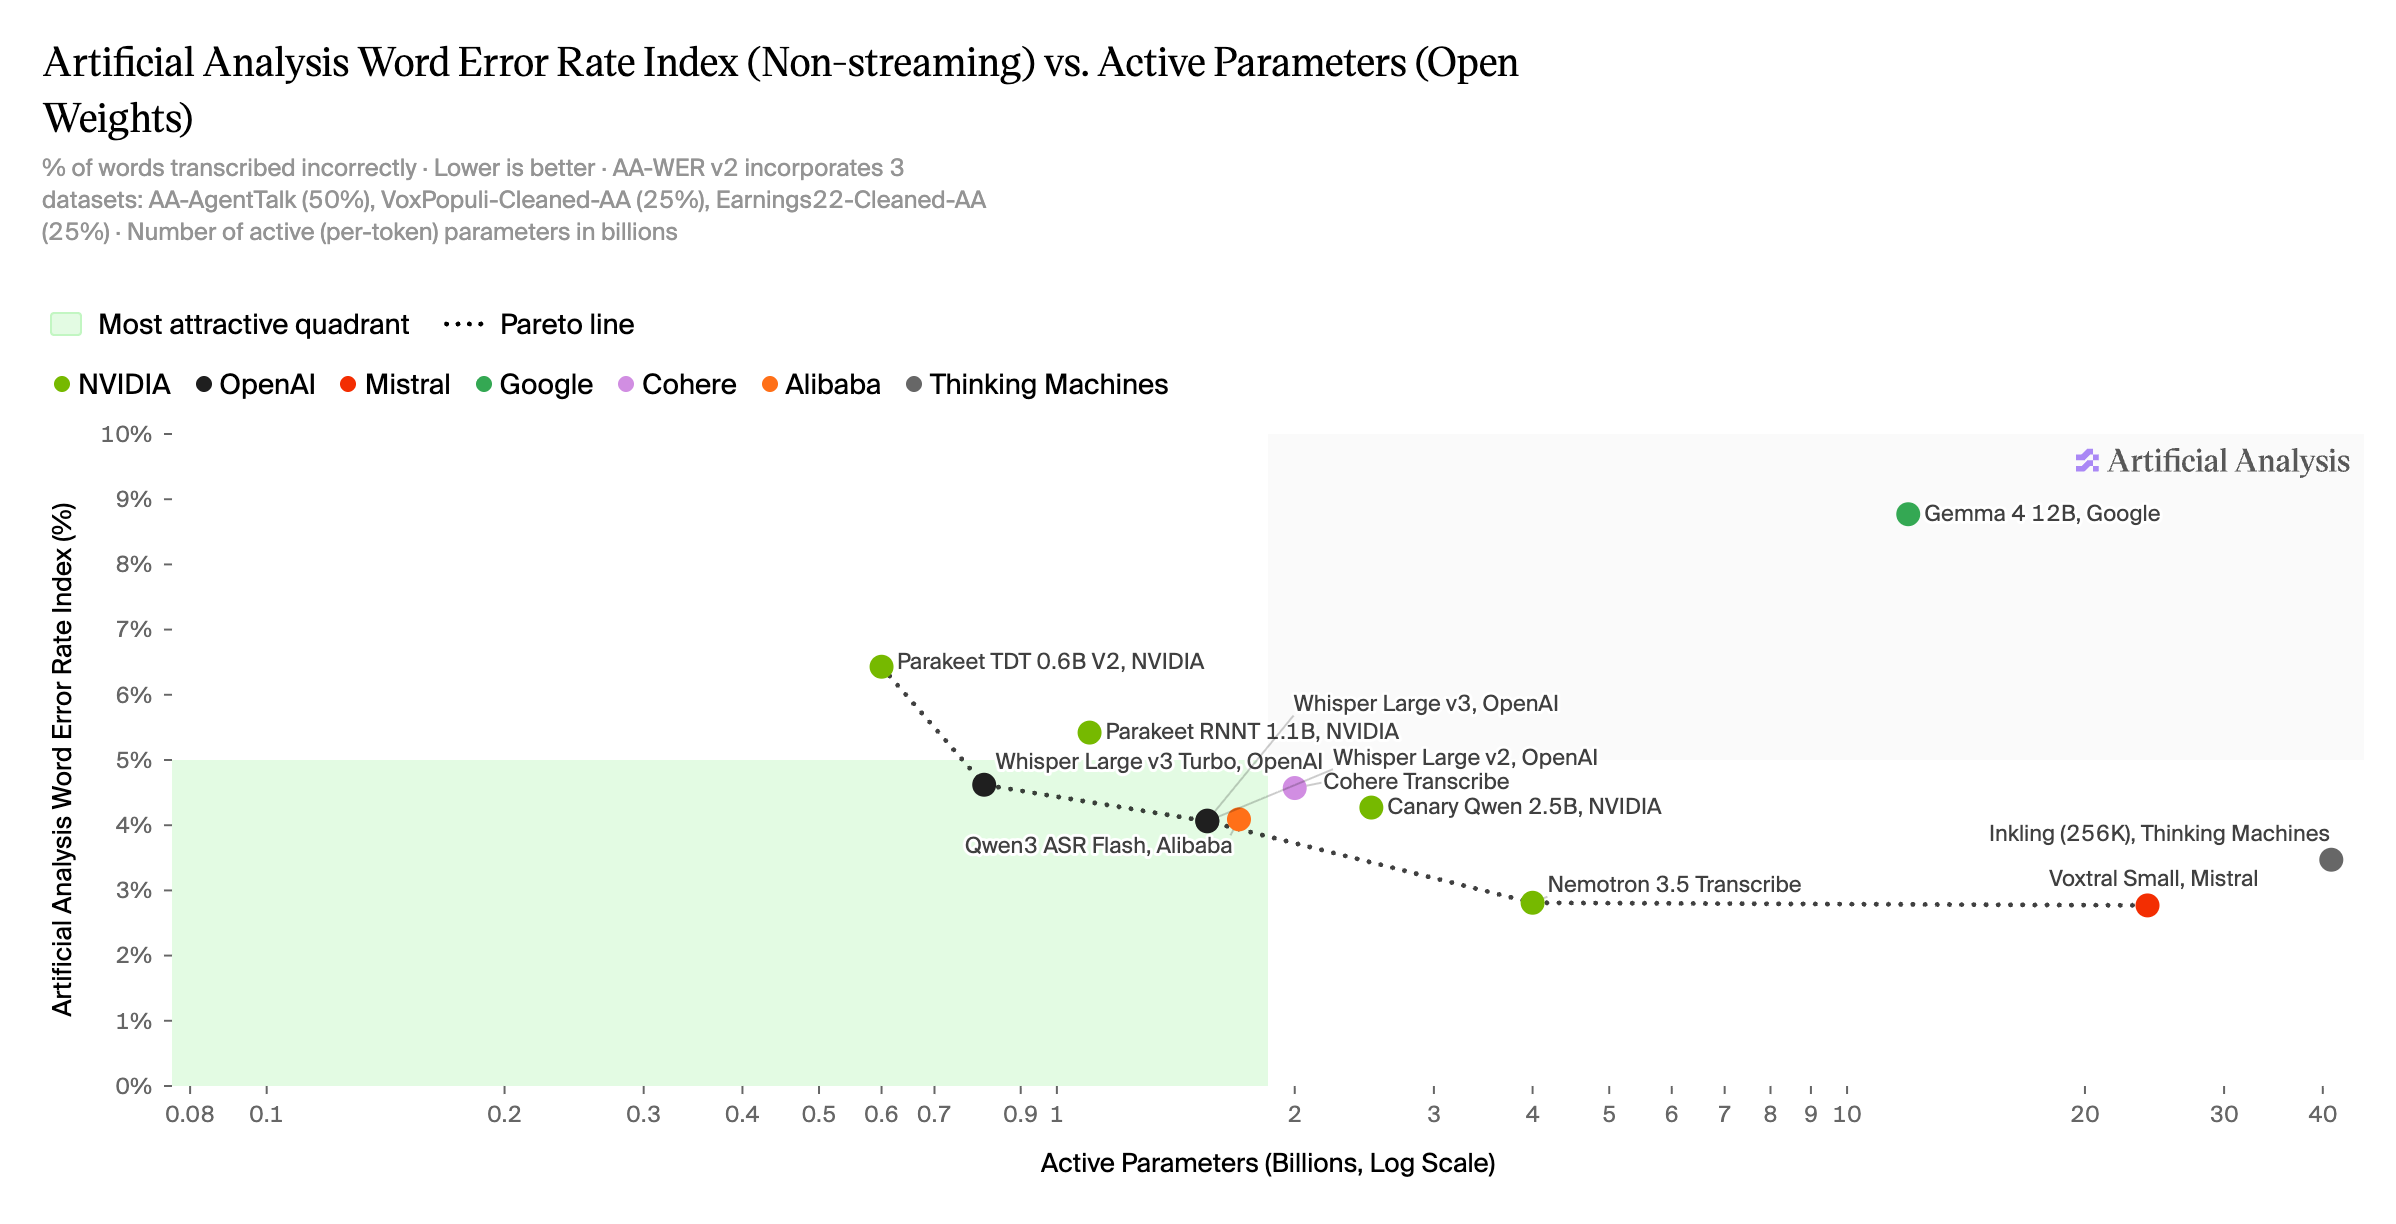
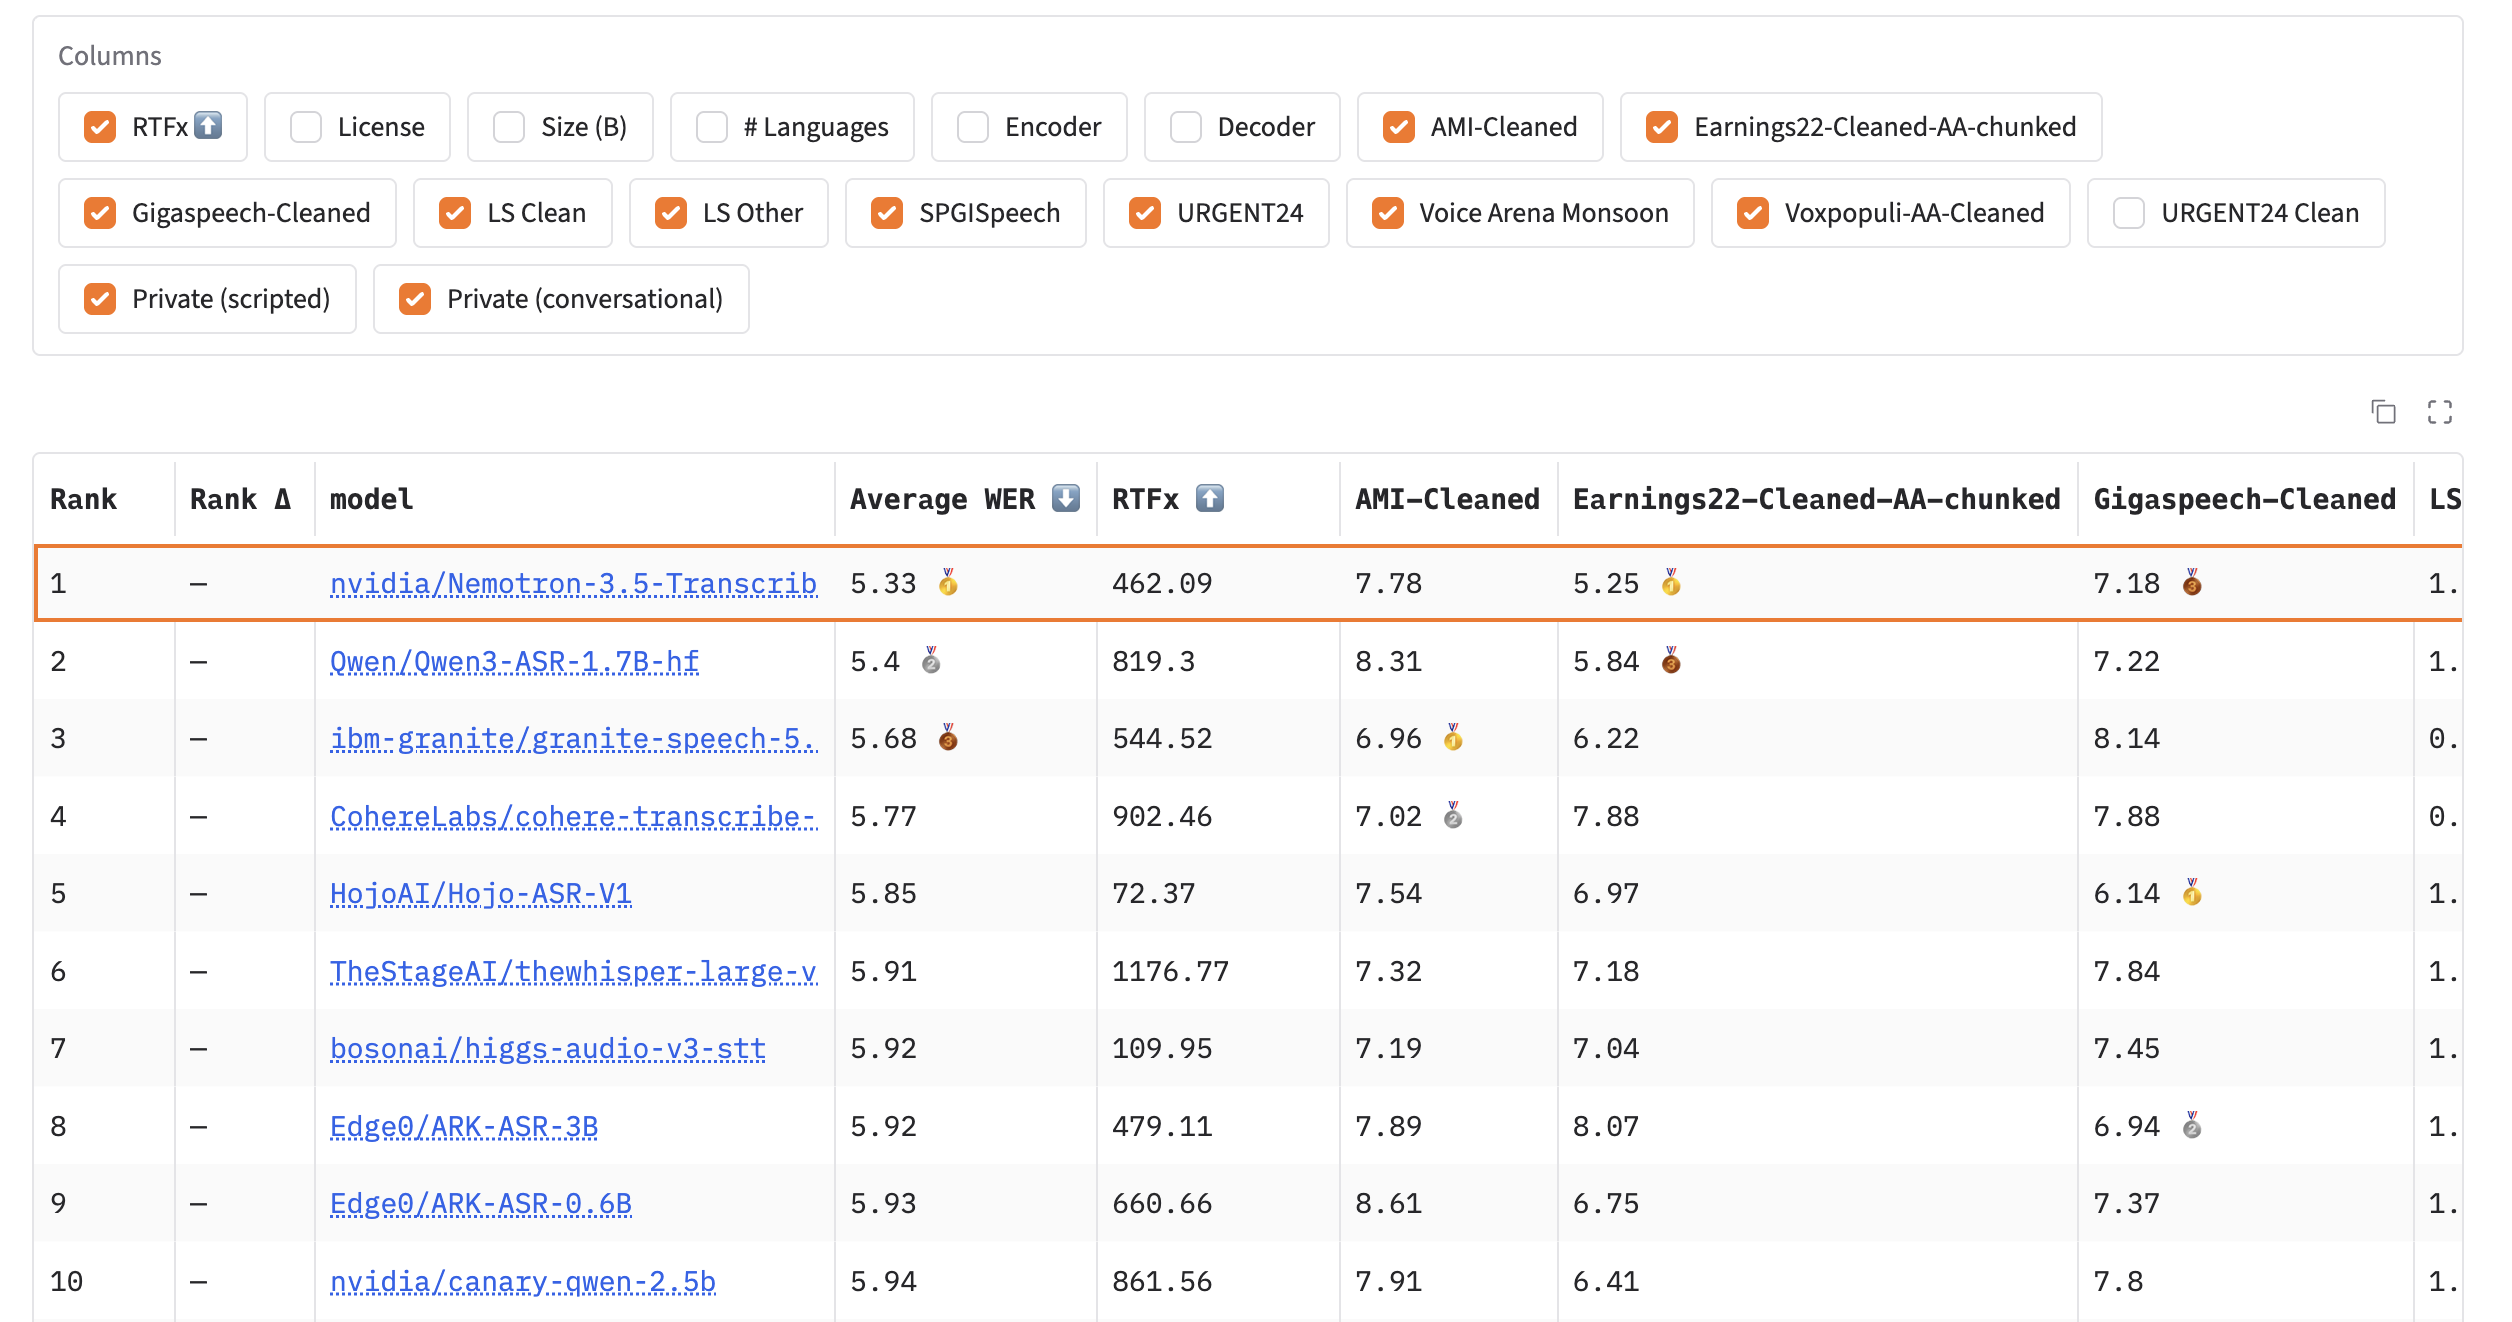
Hugging Face 英文 Open ASR 榜 9 个公开测试集平均 WER 4.71%、多语榜 4.62%,均为开放权重模型第一(最接近的 Qwen3-ASR-1.7B 为 4.94%/6.49%;以上为厂商自报口径,HF 榜单快照被 The Decoder 引用为 5.33%,口径略有出入但名次结论一致)。说话人归因是它拉开差距最大的位置:VoiceArena Diarization-Bench cpWER 32.4% 第一,漏词率 8.32%,而竞品中位数约 31%。选型视角看,它在「误差率 vs 激活参数」的帕累托前沿上位置很清楚:同样误差水平下,激活参数只有 Voxtral Small 的约六分之一——买省的不是数字,是它背后的推理账单。
成本账:一张卡每天能转写多少小时录音
官方 serving 数据(厂商自报):单张 RTX PRO 6000 Blackwell 上,NVFP4 checkpoint 加 DFlash2 投机解码,每秒处理 2,238 秒音频,即 100 小时音频不到 3 分钟跑完,30 秒的录音 0.13 秒回片(The Decoder 独立引用了「100 小时 3 分钟内」,两源互证)。把账反过来算:再大的呼叫中心,一天的录音量也远低于一张卡的日吞吐上限,真正的约束是并发请求排队而不是吞吐。这意味着私有化 ASR 把「按分钟计费」翻成了「一张卡的固定成本加电费」——录音越多,摊到每分钟的边际成本越逼近零,这正是录音不能离场的呼叫中心、医疗、会议纪要场景最想要的 ROI 形状。微调也便宜:官方数据称适配一个新语言、新领域或新任务在单卡上 0.5–2.3 GPU 小时(厂商自报);The Decoder 报的医疗场景实测,针对印度医疗说话人微调后错误率从 30.8% 降到 11.8%,全程约 14 GPU 小时、单张 GB300 完成。
采购前的三条风险提示
一、它是离线模型,处理录音文件而非实时流式 ASR,实时通话场景仍需另行选型;二、2,238 秒/秒是 NIM 优化后的实测值,NeMo Speech 当日随放的开源 vLLM 版本官方预期慢约 2 倍,吞吐规划要打折;三、音频问答能力只在英文上训练过,说话人标签是录音内编号而非真实身份识别,医疗等敏感场景建议保留抽检人审环节。
观察:开放权重 ASR 的「档位表」从多卡降到单卡。对录音不能离场的场景,问题已经不是「能不能私有化」,而是「买哪张卡、并发怎么排队」。
来源:NVIDIA Nemotron 官网与技术报告、Hugging Face 模型卡、The Decoder、TNW(2026-10-28)