
Kakao开源Kanana-2双Embedding模型:MRL四档向量维度,私有RAG检索成本的显性化
两款模型,一个底座,一次蒸馏
10月29日,Kakao在Hugging Face上线了Kanana-2-3b-embedding与Kanana-2-1.3b-embedding两款文本Embedding模型,用于语义搜索、检索增强生成(RAG)与个性化智能体的历史信息检索。两款模型均基于Kakao自研的Kanana-2小型语言模型(SLM)改造为双向注意力结构:3B版本直接继承SLM的语言理解能力,1.3B版本则通过知识蒸馏把大模型能力迁移到更小的规格。这是Kakao继7月开源4款SLM之后的又一次开放权重动作,模型采用Kanana开放许可,允许商用。
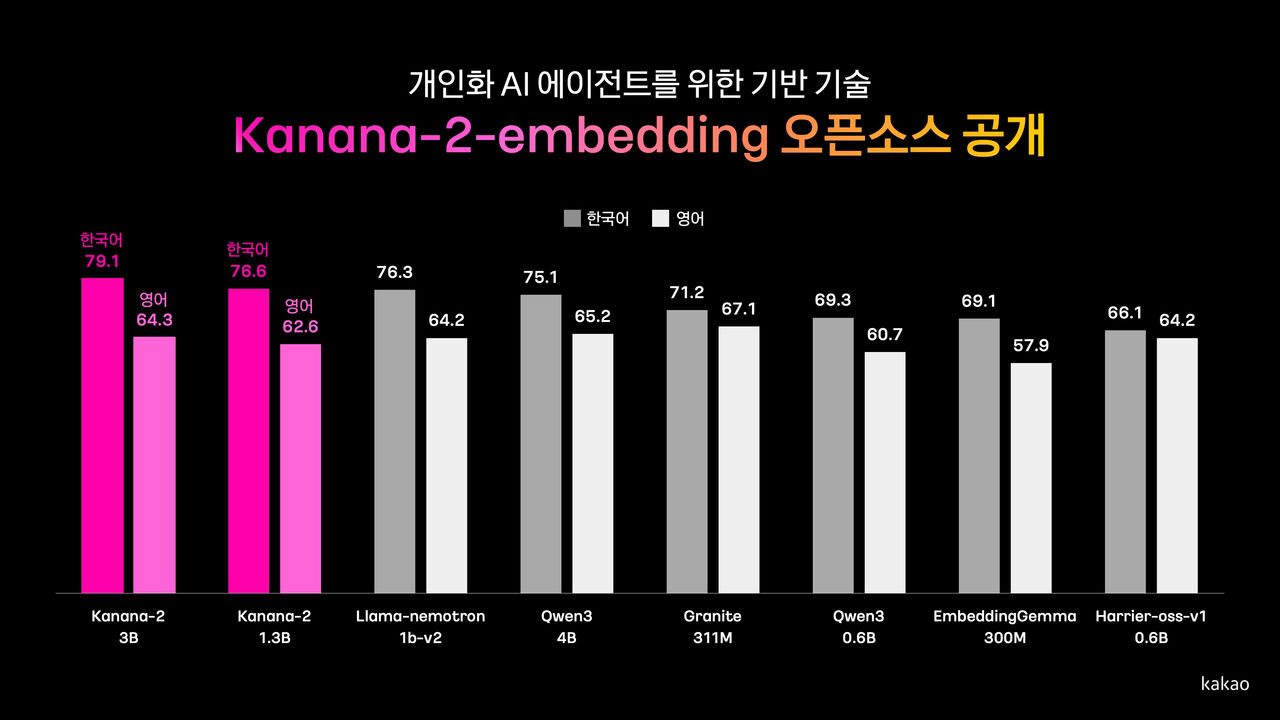
图为Kakao官方发布的性能对比图:Kanana-2 3B在韩语任务上得分领先,1.3B紧随其后;英语任务与Qwen3-Embedding-4B、Llama-Nemotron-Embed-1B-v2处于相近区间(厂商自报数据)。
MRL四档维度:存储与召回可分级取舍
两款模型都引入了MRL(Matryoshka Representation Learning)技术,向量维度可以在全量、512、256、128之间按需截断:3B版全量维度为2560,1.3B版为1280。按HF模型卡披露的数据(厂商自报),3B版在Ko-Retrieval韩语检索集上全量维度0.8211,截断到128维后为0.7488,召回损失约9%,而单条向量存储从10KB降到0.5KB——存储成本直接砍掉五分之四。这意味着部署方可以按业务对召回率的敏感度选择档位,而不必为全量维度的冗余买单。
基准表现:韩语占优,英语打平
在HF模型卡的基准对比中(厂商自报):3B版在nano-BEIR韩语集全量维度得0.6088,优于Llama-Nemotron-Embed-1B-v2的0.5471和EmbeddingGemma-300M的0.4564;英语MTEB v2全量维度0.6317,与Llama-Nemotron-Embed-1B-v2的0.6369基本持平。Kakao称其在韩语任务上优于同级别开源模型,英语任务表现相近,推理效率高于Qwen3-Embedding-4B(厂商自报)。
私有化部署与硬件选型视角
从私有化部署角度,Embedding模型的选型核心不是跑得多强,而是单位召回率的综合成本——推理成本加向量库存储成本。3B版BF16权重约6GB,单张8GB消费级GPU(如RTX 4060)或国产推理卡即可承载;1.3B版约2.6GB,甚至可在嵌入式设备或CPU上运行,适合边缘网关做本地语义检索。按1000万条语料估算,2560维全量向量库约需100GB存储空间,截断到256维后降至约10GB,配合MRL可让向量数据库(Milvus、Qdrant等)的内存占用下降一个数量级。模型已在vLLM(pooling模式)、sentence-transformers、transformers等主流框架验证,部署路径成熟。
许可与风险提示
Kanana开放许可允许商用,但属于厂商自定义许可,与MIT、Apache等标准开源许可不同,企业落地前需逐条阅读许可条款,确认再分发与商标使用限制。此外,该模型在韩语任务上优势明显,英语及中文多语言场景下并无公开基准背书,中文私有化RAG项目选型时建议以Qwen3-Embedding系列或BGE等中文特化模型为主,Kanana-2更适合作为韩语或双语业务的检索层。
观察:Embedding是RAG架构里最容易被忽视的成本项——模型本身不贵,但向量库的存储与查询成本随维度线性放大。Kakao这次把MRL维度档位做成显性选项,等于把检索效果与存储成本的交换曲线交给部署方自己定价,这对私有化场景的算力规划是个务实的信号。
来源:Kakao官方新闻室、Hugging Face模型卡、ChosunBiz、DigitalToday(2026-10-29)