
560B 只激活 25B:Ling-3.1-flash-1019 的私有化部署硬件账
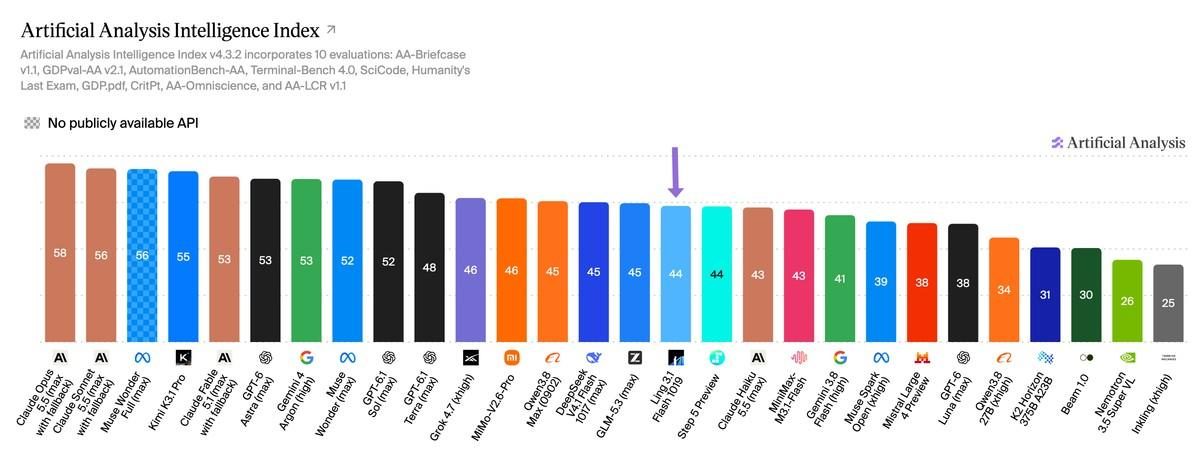
10月28日,蚂蚁集团旗下百灵大模型正式开源 Ling-3.1-flash-1019,并同步放出基础模型 Ling-3.1-flash-base(BF16 权重、MIT 许可)。1019 是面向 Personal Agent 场景的后训练版本:Artificial Analysis 智能指数 v4.3.2 得 44 分,较上一版提升 3 分,复杂知识工作与流程自动化子项涨幅明显。
决定账本的,是激活的 25B 而不是 560B
架构上 1019 延续混合线性 MoE 路线:总参约 560B,每个 Token 仅激活约 25B;512 个路由专家每 Token 只激活 8 个,外加 1 个共享专家,上下文最高 1M。注意力是 63 层 KDA 线性注意力配 9 层 Gated MLA(7:1 排布),线性部分把长序列的注意力开销压住,但 KV cache 仍随上下文线性增长——这是 1M 场景下内存预算的主要变量。这个结构直接决定硬件账怎么算:
算力轻、存储重。25B 激活意味着解码每步只需搬运少量权重,吞吐由 Hopper/Blackwell 解码优化决定;但 560B 总权重必须完整驻留。官方 Hugging Face 页面给出 BF16 与 F8_E4M3 混合精度两种形态,FP8 口径下权重 500GB 出头。
官方部署配方。SGLang 的 day-0 镜像已内置 NEXTN 投机解码与 Hopper 解码优化:8×H200 走 TP8+EP8,4×GB300 走 TP4+EP4;H800、H100、B200 也有验证过的配方。
量化省一半。十月中旬首代 3.1 开闸时,百灵就放出 MXFP4 路由专家 + block-FP8 稠密层的量化版:权重占用从约 534GB 压到 292GB,Hopper 机房部署由 8 卡降到 4 卡。NVIDIA 开发者社区也确认:FP8 形态至少要 8 卡切分才能驻留,单节点 4 卡需要等 4bit 社区量化版。
这 3 分涨在哪里
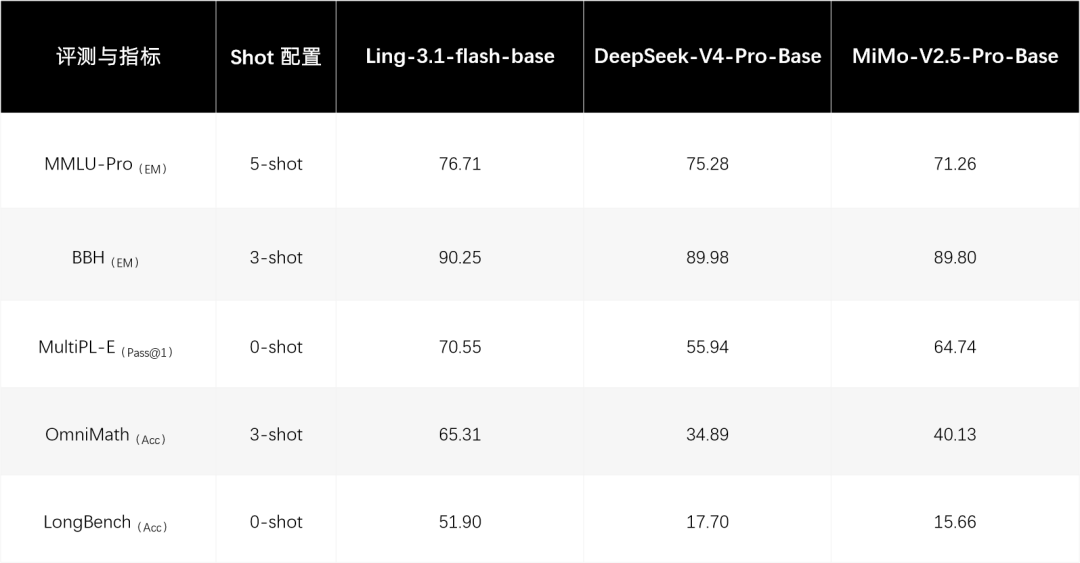
新旧版本逐项对比(百灵官方口径,与 Hugging Face 模型卡交叉一致):AA-Briefcase 从约 1400 Elo 升到 1524;AutomationBench-AA 从 62% 升到 68%;CritPt 从 18% 升到 26%;SciCode 从 54% 升到 57%。基础模型在 8 大领域 47 项 benchmark 上称 32 项领先 DeepSeek-V4-Pro-Base 与 MiMo-V2.5-Pro-Base(厂商自报,第三方复测暂缺)。
产品侧的出口是灵光 2.0:10 月 26 日升级为「能管事的个人 AI 助理」,靠跨会话记忆、长程任务调度和独立云主机让任务在用户离线后继续跑——1019 就是这套长程能力的底座。
先说钱。单 token 推理成本由 25B 激活参数决定,与 25B 稠密模型同量级;560B 的驻存成本买的是 1M 上下文与智能体能力。若已有 8×H200 或 4×GB300 机器,边际成本主要是电费与运维,摊到单任务远低于走 API 渠道;若专门采购,把「权重驻存 + 长上下文内存 + 智能体并发数」三项写进招标参数,比笼统按参数量招标更不容易踩坑。
选型判断:你的机房要几卡
GB300 / H200 档:4×GB300 可跑量化版且留有余量;8×H200 是官方推荐满配。1M 上下文的 KV cache 要单独做内存预算,可开 HiCache(Mooncake L3)把长上下文缓存卸到内存盘。
A100 档:4×A100 80GB 合计 320GB 显存,292GB 量化权重加 KV cache 几乎没有余量,且 A100 没有 FP8 硬件加速、官方配方未验证——除非第二个节点放权重,否则不建议。
结论。业务以短问答为主,124B 总参、激活 5.1B 的 Ling-3.0-flash 更划算;要跑多步骤长程工作流,1019 是当下开放权重货架里最省卡的选项之一。
部署后的验收清单
三条实测项。一是按官方建议 temperature=1.0、top_p=0.95、top_k=20 采样并打满 thinking 开关,跑一遍自己的长任务集;二是验证工具调用——vLLM 侧要配 tool-call-parser 与 reasoning-parser 的 ling3 参数,漏配会出现工具格式漂移;三是 1M 上下文打满测试,记录自家卡型上的 TTFT 与解码吞吐,再决定要不要上 HiCache(Mooncake L3)卸载。
来源:量子位、AIBase、腾讯新闻/智通财经、Hugging Face inclusionAI 模型卡、NVIDIA 开发者社区(关键数据经双源交叉验证,未复测项已标注厂商自报)