
行业新闻
汇聚全球顶尖的AI大模型及人工智能领域知识
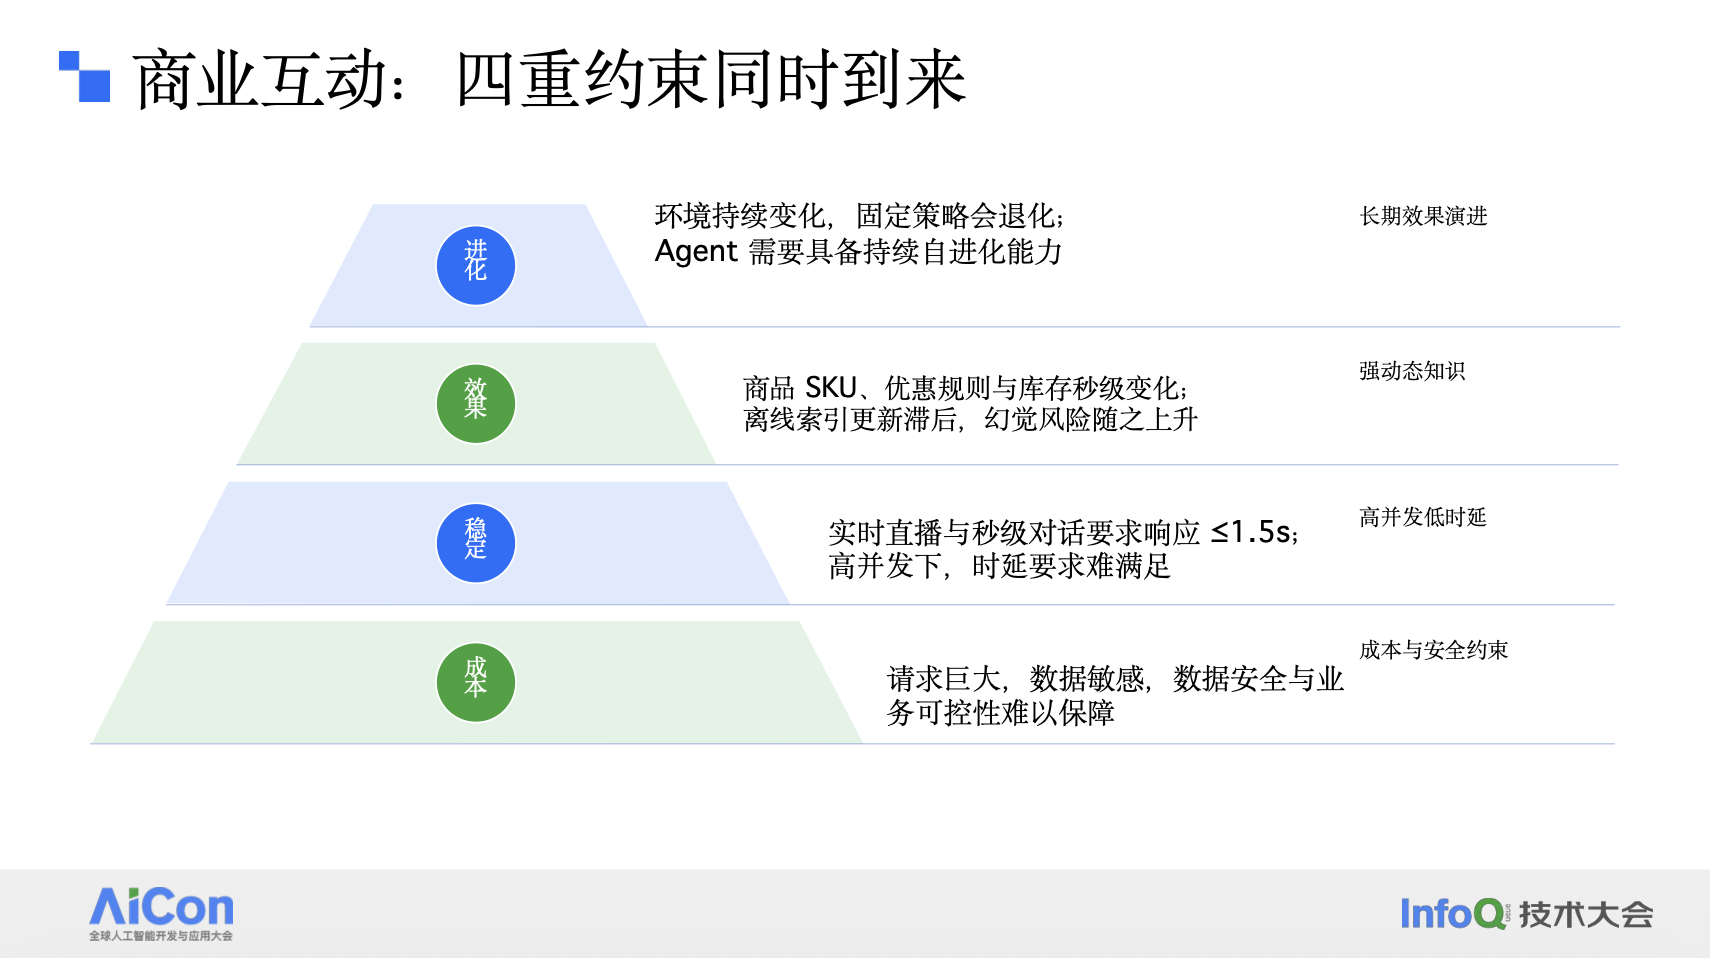
快手自研商业Agent:私有化部署控成本,224像素图像检索保障时延
快手专家分享商业Agent落地经验,强调在效果、时延、成本三角约束下,通过自研模型避免开源模型不稳定问题。构建动态知识库,采用224x224图像在线检索及VCoT对齐,结合分层奖励机制解决稀疏反馈,实现本地可控推理。
腾讯混元Hy Realtime开源权重落地:本地推理优化降本,支持工具调用
腾讯混元发布实时语音模型 Hy Realtime,具备唱歌与工具调用能力,已在元宝及客服上线,近期开放 API,下一步强化双工交互与记忆功能。
Edera推出对象能力模型,从虚拟机监控器层隔离AI智能体敏感凭证
Edera发布对象能力受限权限模型,旨在解决自主AI智能体与敏感凭证隔离难题。该架构通过虚拟机监控器层实施细粒度控制,将操作权限与底层凭证分离,确保AI编码助手等负载在不持有静态密钥的情况下执行特权操作。结合MCP服务器限制,该技术有效遏制了提示注入导致的横向移动风险,初步功能已随Project Lunchbox计划推出。
Anthropic 拟募 904 亿美元,英伟达认购 100 亿强化算力底座
Anthropic 拟通过 IPO 募资最高 644 亿美元,叠加 260 亿美元私募配售,合计融资最高 904 亿美元。英伟达计划认购其中 100 亿美元,深化战略协作。公司目标估值 1.4 万亿美元,营收运行率已达 810 亿美元,资金将支撑私有化部署与本地推理能力扩展。
谷歌 LiteRT Tensor API 落地,C++ 实现端侧模型跨硬件低成本推理
谷歌推出轻量级 LiteRT Tensor API,允许开发者用 C++ 直接构建端侧 ML 模型。该 API 支持 CPU、GPU 和 NPU 运行,通过零拷贝缓冲区互操作和直接权重导入提升性能。实测显示其推理成本低于传统方案,且兼容 AI 编码智能体自动化优化,大幅降低本地部署门槛。
腾讯 GFlow 游戏 Agent 方案:开放权重本地化部署如何平衡创意与算力
腾讯王文瑾于 2026 AICon 大会分享 GFlow 多智能体架构。通过分层采样、模拟回放验证玩法与叙事。强调开放权重本地部署可降低推理成本,提升复杂任务可控性与产物可验证性。
Docker发布智能体安全指南:以隔离与治理降低本地推理风险
Docker 发布指南指出 AI 智能体在有限监督下面临提示词注入、工具滥用等五大风险。公司主张通过一次性微虚拟机隔离和 AI 治理框架限制权限,防止智能体过度自主导致的数据窃取或系统破坏,强调隔离是快速有效的防御起点。
SparkAudio 1.0 上线,国产算力支撑开放 API 降低语音推理门槛
科大讯飞宣布 SparkAudio 1.0 语音基座大模型在开放平台上线 API 服务。该模型支持 99 种语言和 202 种方言,具备音频问答与情感分析能力。通过全国产算力训练,它为行业提供自主可控的语音智能底座,优化了传统级联方案的延迟与信息丢失问题。
MiniMax开源H3-Image,原生4K生图仅两毛,本地推理成本新低
MiniMax开源多模态生图模型H3-Image,支持原生4K(16MP)分辨率,生成速度10-20秒。该模型具备CAD拆解等逻辑能力,API价格仅为竞品50%-70%,首周五折,极大降低企业私有化部署与本地推理的算力与成本门槛。
谷歌Gemini Decision 1开放权重,本地推理成本降低近5倍
谷歌发布Gemini Decision 1模型及API,专为快速决策设计。该模型支持单次处理1000个问题,支持256K Token多模态输入,每百万输入Token成本仅0.10美元,较Gemini 3.5 Flash-Lite低近5倍,具备极高的本地部署与硬件算力效率。
华为云CloudRobo世界模型亮相,昇腾原生架构强化本地推理能力
华为云宣布CloudRobo具身世界模型发布会将于11月16日线上直播,发布业内首款昇腾原生世界模型CloudRobo-WM1.2。该平台基于华为行业AI梦工厂,专注降低AI应用门槛,不涉足机器人本体研发,致力于构建连接本体的智能生态。
Runway 开放 Praxis-1 权重,本地推理成本低 51 倍快 15.6 倍
Runway 推出机器人模型 Praxis-1,采用 Apache 2.0 开放权重。其基于 270 亿参数视频模型构建,支持 RTX 5090 本地运行。实测比 GPT-6 Astra 快 15.6 倍,成本仅为其 1/51,旨在降低机器人训练数据采集与推理部署成本。
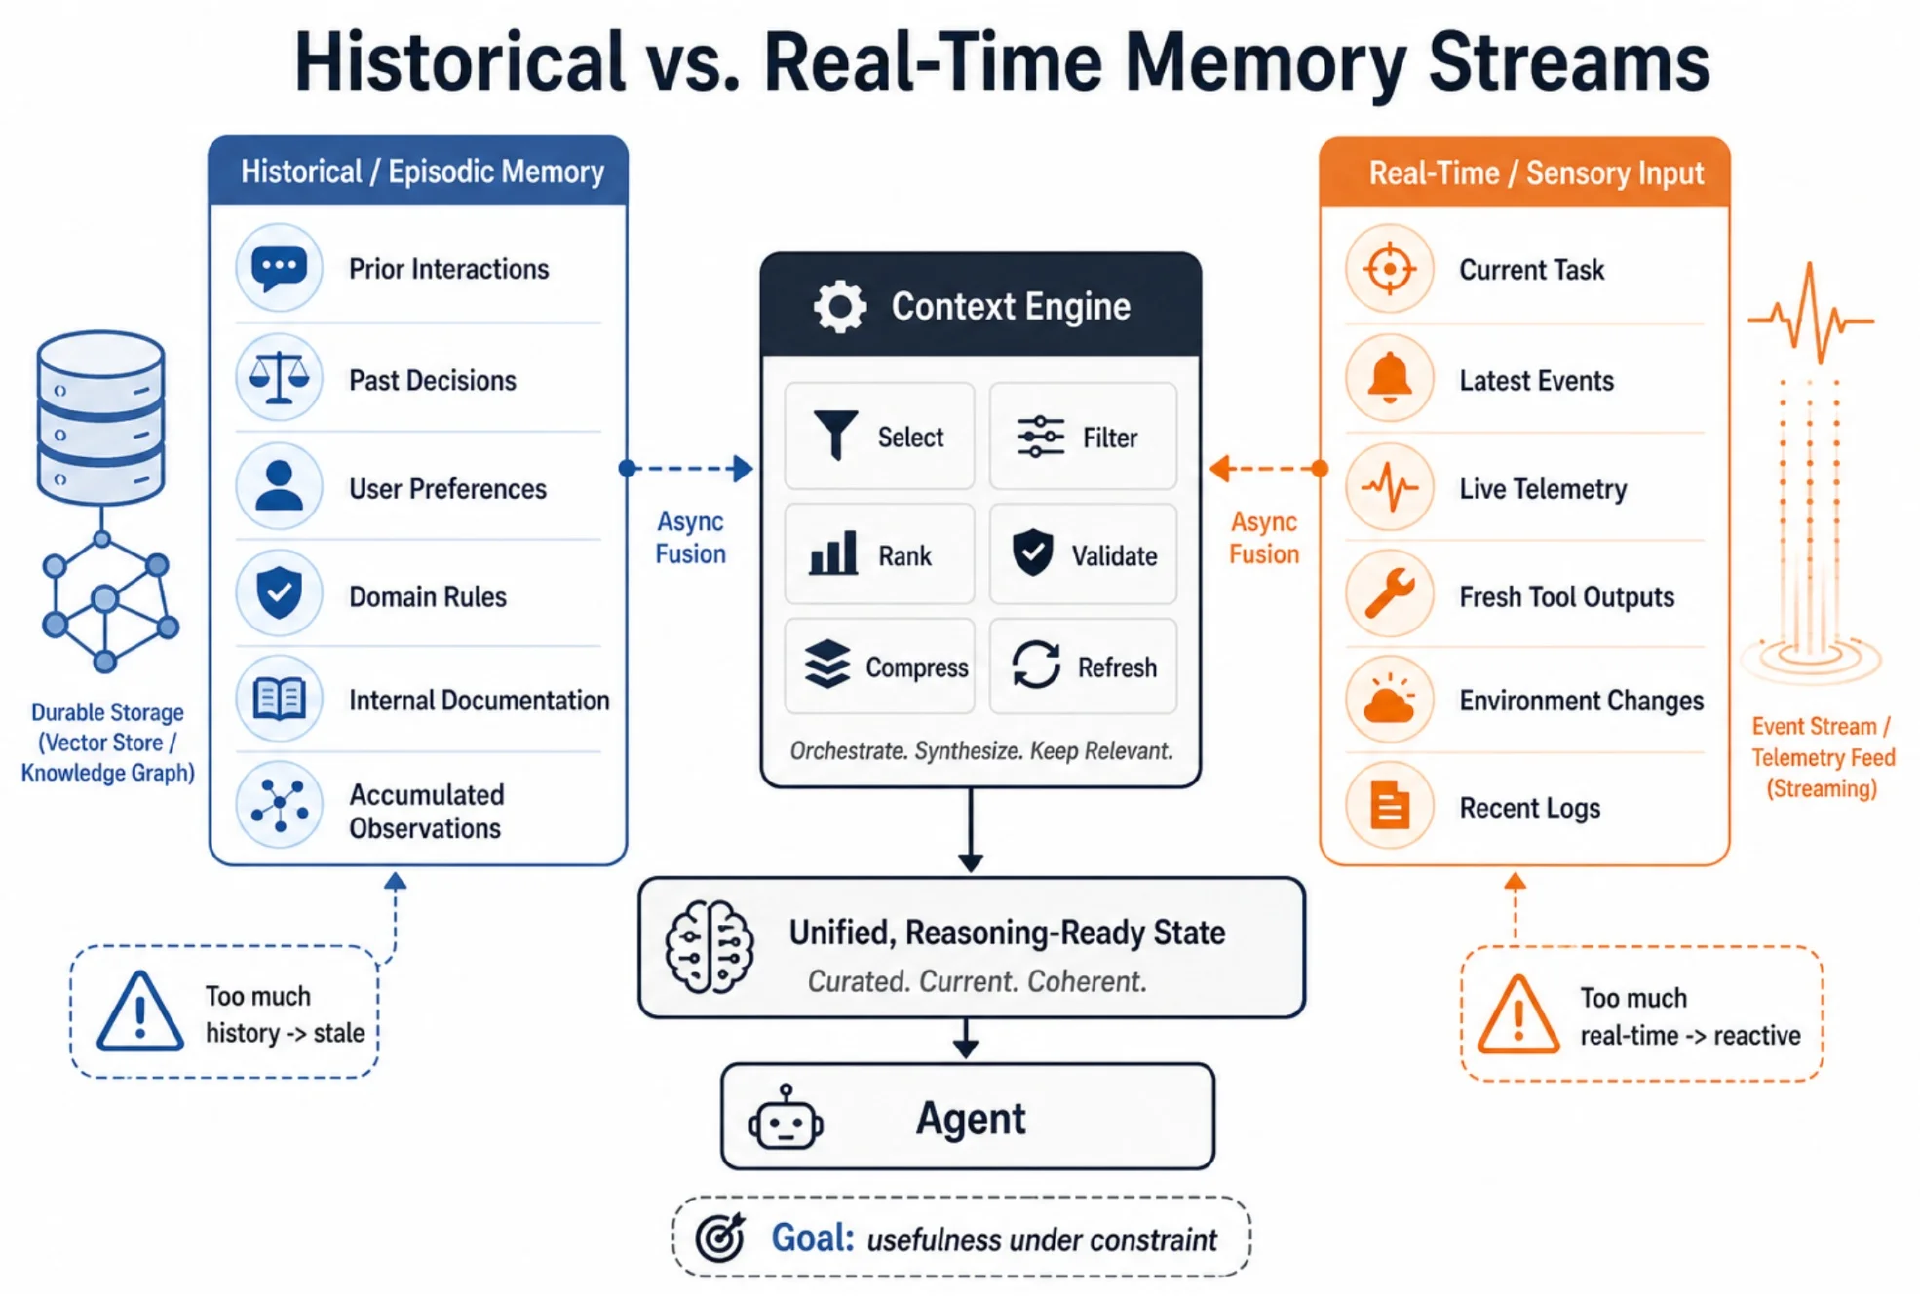
架构革新:通过上下文引擎优化本地推理与降低智能体算力成本
文章指出智能体架构瓶颈已从数据检索转向记忆与知识的动态管理。提出“上下文引擎”作为控制平面,通过选择、注入、压缩和刷新四阶段生命周期管理数据。该范式旨在解决幻觉根源,优化本地推理效率,并通过将原始数据提炼为结构化知识,显著降低大模型在部署中的算力消耗。
Fractile 获政府注资完成 7.2 亿美元融资,聚焦低成本本地推理硬件
英国 AI 芯片初创企业 Fractile 宣布完成超过 7.2 亿美元的 C 轮融资,估值达 70 亿美元。英国政府主权基金及谷歌风投等参与投资。该企业致力于开发无需权衡吞吐、模型尺寸与上下文的硬件,旨在降低推理成本,实现更高效的本地计算能力。
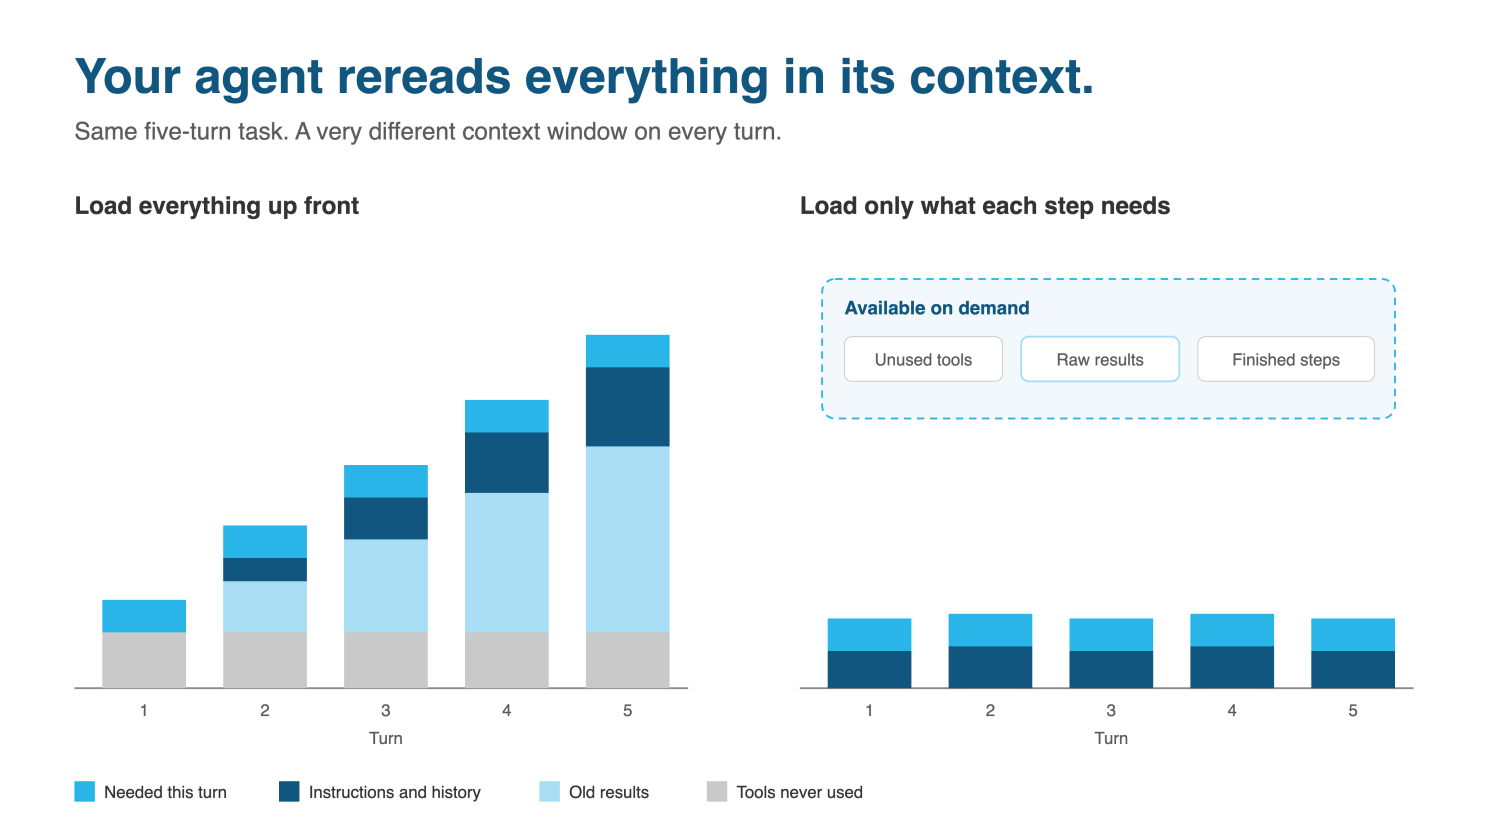
Snowflake CoCo 降低 33% 推理成本,本地化部署智能体框架优化上下文开销
Snowflake AI Research 推出 CoCo 框架,通过按需加载工具、并行执行及输出压缩技术解决上下文膨胀问题。在内部测试中,使用 Sonnet 5 的 CoCo 任务通过率 86%,单次成本从 0.446 美元降至 0.298 美元。结合语义视图可确保业务逻辑准确,为本地化部署 Agent 提供高效低成本方案。
GitHub重塑流程:Agent驱动PR激增,本地推理与算力架构面临新挑战
GitHub负责人Parikh指出,传统Pull Request流程正被Agent重写。数据显示,平台上Agent起草的PR比例半年内从17%升至40%。GitHub正通过Copilot Fusion等工具优化模型选择,平衡推理成本与速度,并计划在2027年初完成Azure多区域迁移,以支撑Agent时代的基础设施需求。
AWS 推出 Agent 实战课,聚焦本地推理成本治理与质量评估
亚马逊云科技推出“Agent 速造局”4×1实战课,针对Agent从Demo到生产环境中的质量验收、安全防护及成本治理难题提供解决方案。课程强调Evaluation-First理念,通过连续4周、每周1期、每期1小时的培训,帮助开发者在模型升级和调用量增长时控制Token成本,确保Agent稳定可靠。
DEEPX 2nm DX-M2 芯片本地推理超 10B 模型功耗仅 5W
韩国 DEEPX 宣布其 DX-M2 芯片获 CES 2027 人工智能创新奖。该芯片基于三星 2nm 工艺,集成 80TOPs NPU,支持 128bit LPDDR5X-9600 内存,可在 5W 低功耗下本地运行超 10B 参数 LLM/VLM 模型,预计 2027 年初面世。
2026 世界计算大会启动:聚焦算力基础设施与具身智能产业趋势
湖南省政府新闻办宣布 2026 世界计算大会将于 11 月 19 日至 21 日在长沙举行。本届大会首设太空计算论坛,设置 21 场主题活动,预计 80 余家企业参展,集中展示具身智能、脑机接口及算力产业链创新产品。
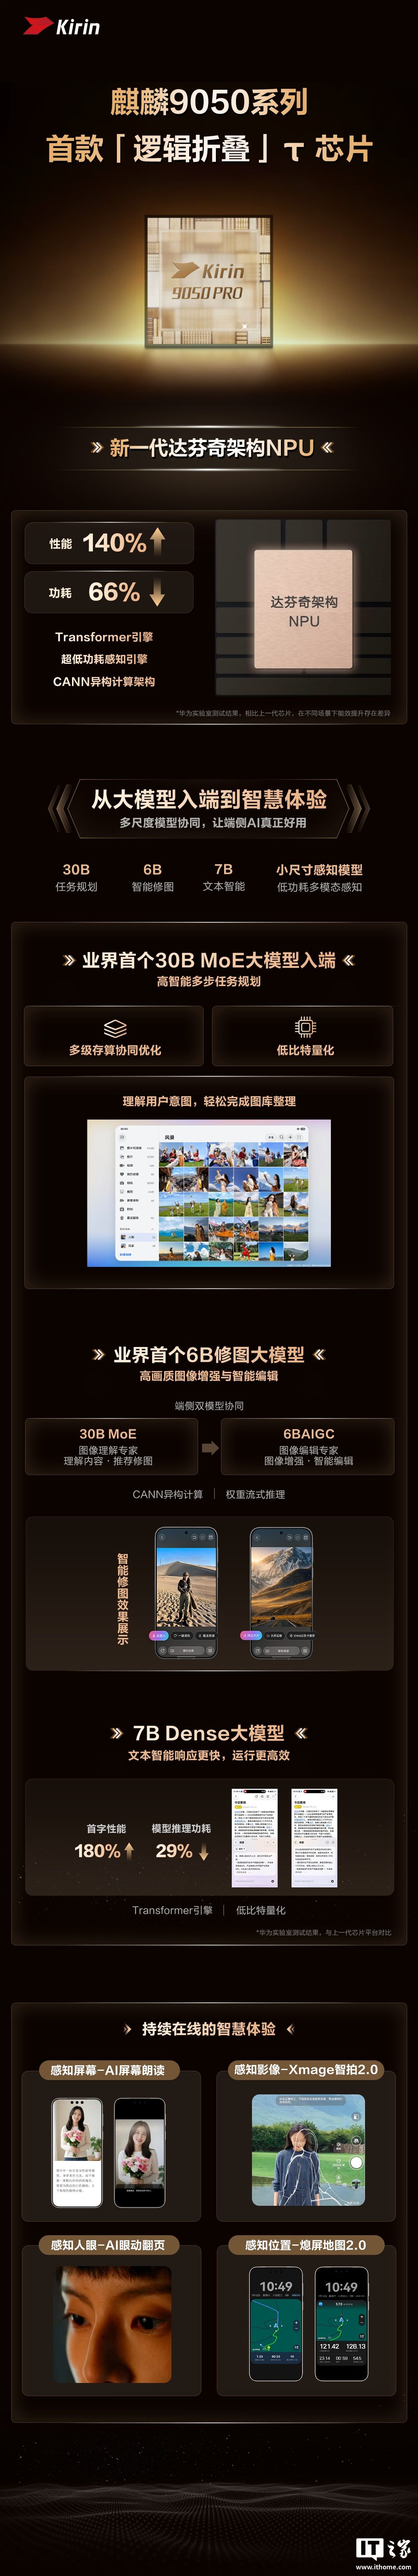
麒麟9050首跑30B MoE:达芬奇NPU升级,本地推理成本与算力双优化
华为官宣麒麟9050系列首款逻辑折叠芯片,搭载新一代达芬奇NPU,支持30B MoE模型端侧运行。性能提升140%,功耗降66%,支持低比特量化与多级存算协同,实现无需联网的本地推理,覆盖屏幕、影像及眼动交互等多场景。