
Snowflake CoCo 降低 33% 推理成本,本地化部署智能体框架优化上下文开销
上下文膨胀成为智能体主要瓶颈
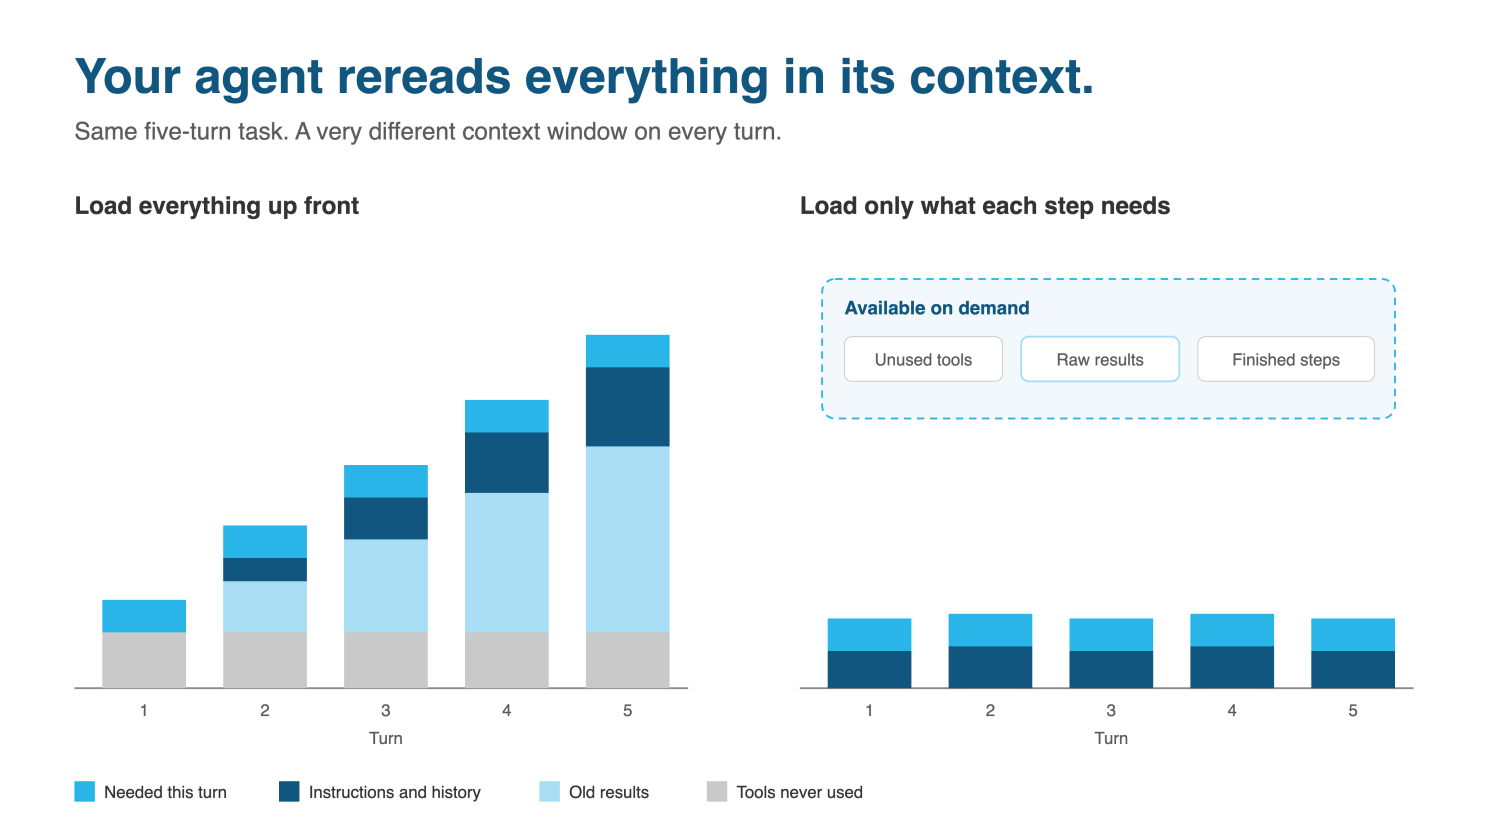
在 2026 年企业级应用趋势中,智能体面临的核心挑战并非信息缺失,而是被信息淹没。所谓的上下文膨胀指每一轮交互中工具定义、查询结果及对话历史不断累积,即使早期信息已无关,Agent 仍可能在后续步骤中反复携带,导致 token 消耗激增并干扰聚焦关键信息。Snowflake AI Research 指出,单纯扩大上下文窗口无法根治此问题,管理信息进入与保留机制才是关键。
CoCo 框架重构工具调用逻辑
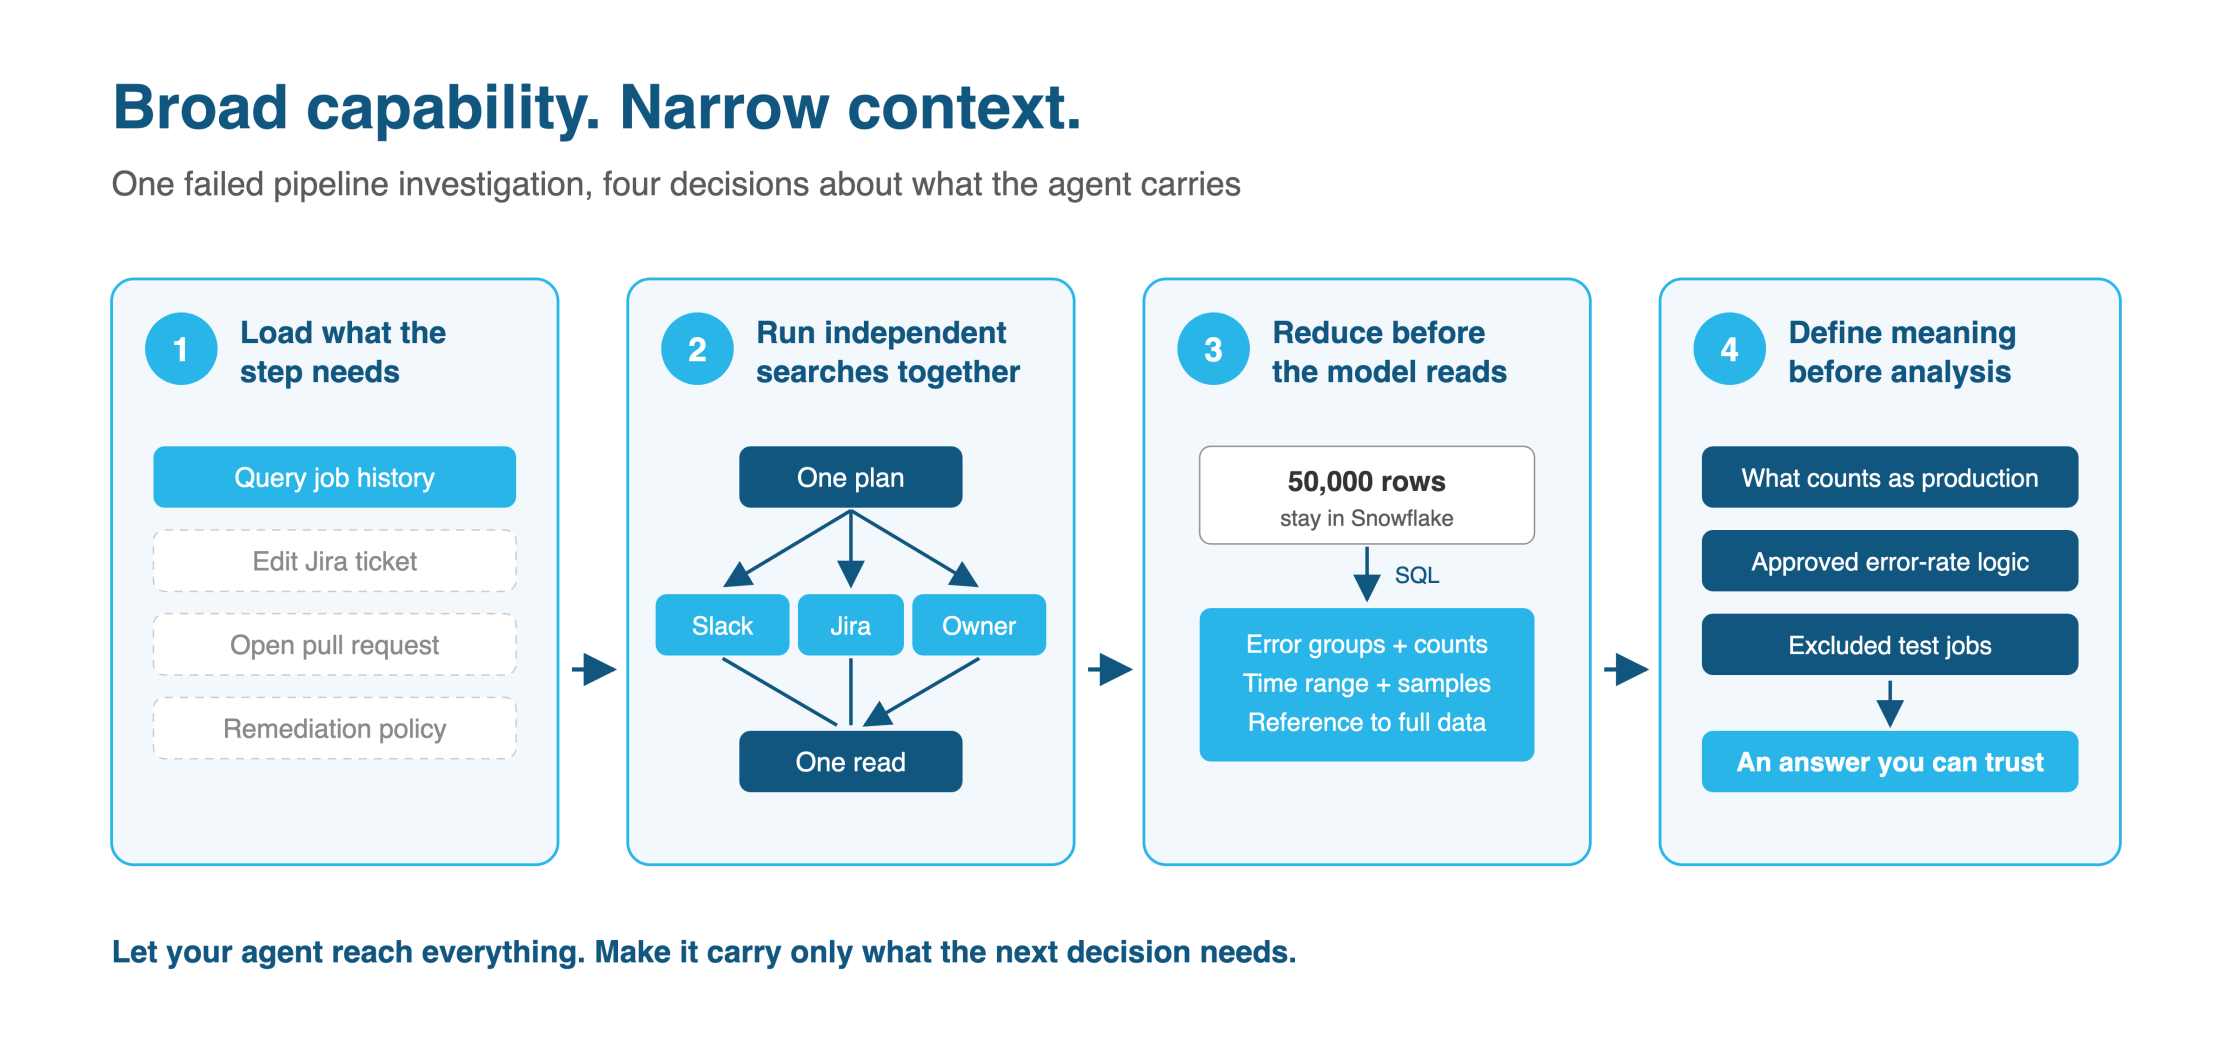
Snowflake 在 CoCo 和 CoWork 中探索了新的效率优化路径,重点在于构建智能管理上下文的运行框架(Harness)。CoCo 不再让模型处理所有环节,而是负责协调工具发现、独立操作执行及结果进入上下文的方式。其核心在于按需加载工具,即使 Agent 可访问数十种工具,也仅在任务需要时动态引入相关定义,避免初始上下文空间被无用工具占据。这一机制对于处理多种任务的通用 Agent 尤为重要,例如在调查数据管道故障时,仅加载 Snowflake 查询和 Slack 搜索工具,排除无关组件。
并行执行与输出压缩降低开销
为减少不必要的交互轮次,CoCo 将相互独立的工具调用合并为统一调度,收集结果后一并返回模型处理,同时严格保证依赖操作的执行顺序。此外,针对查询返回数万行数据的情况,CoCo 采用压缩工具输出及管理大规模结果的方法,让 Agent 优先处理汇总后的错误信息、次数及代表性案例,仅在必要时访问底层原始数据。这些技术共同作用,使模型注意力集中在当前任务所需信息上,避免在整个对话过程中反复携带完整原始输出。
内部基准测试显示成本显著下降
在 Snowflake AI Research 的内部 SQL 修复基准测试中,使用 Sonnet 5 的 CoCo 在三次重复试验中取得了 86% 的通过率,而使用 Opus 5 的 Claude Code 通过率为 72%。更具吸引力的是成本表现,CoCo 每次试验的报告成本降低了 33%,从 0.446 美元降至 0.298 美元。虽然这些结果仅适用于特定配置和工作负载,但它们揭示了重要趋势:衡量 Agent 效率时需结合任务完成情况,而不仅仅是 token 使用量。对于关注推理成本的团队而言,这种通过架构优化降低单位任务支出的模式具有参考价值。
语义视图确保业务逻辑准确性
高效的 Harness 解决的是“如何高效工作”的问题,但未必保证答案正确。Agent 可能生成语法正确的 SQL,却因缺乏业务知识而得出错误结论。例如,它可能不清楚哪些工作负载属于生产环境,或不懂企业内部对错误率的具体定义。语义视图(Semantic Views)用于描述数据在业务层面的含义,包括指标、维度及关系。Snowflake Semantic View Autopilot 可利用现有数据、查询历史及 BI 资产自动生成语义视图,团队随后在 Semantic Studio 中审核完善。这与 Harness 相辅相成:前者确保 Agent 拥有正确的上下文,后者确保 Agent 高效利用这些上下文。
本地化部署的效率与成本视角
从本地推理和硬件算力角度看,CoCo 的优化策略通过减少无效轮次和降低数据负载,直接减少了模型处理的总 token 数。这意味着在私有化部署环境中,同样的算力资源可以支撑更高频次的 Agent 任务,或者同等任务量下所需算力显著降低。虽然原文数据基于云环境测试,但其底层逻辑——通过架构优化提升单位算力产出效率——对本地化部署具有普遍意义。企业若旨在降低长期运行成本,结合智能上下文管理与语义治理,将是提升 Agent 系统性价比的关键路径。
来源:InfoQ