
架构革新:通过上下文引擎优化本地推理与降低智能体算力成本
架构瓶颈转移:从检索到状态管理
随着行业从聊天机器人向自主智能体演进,核心难点已不再是单纯的数据检索,而是决策智能体“知道什么”、“何时知道”以及“记住多久”。这种动态判断机制构成了记忆与知识的基础。例如,在执行简单任务时,系统无需加载无关的历史记忆,这要求架构具备精准的状态控制能力。错误或缺失的上下文会极大增加模型幻觉的概率,因此建立可信的外围系统至关重要。
上下文引擎:作为控制平面的核心
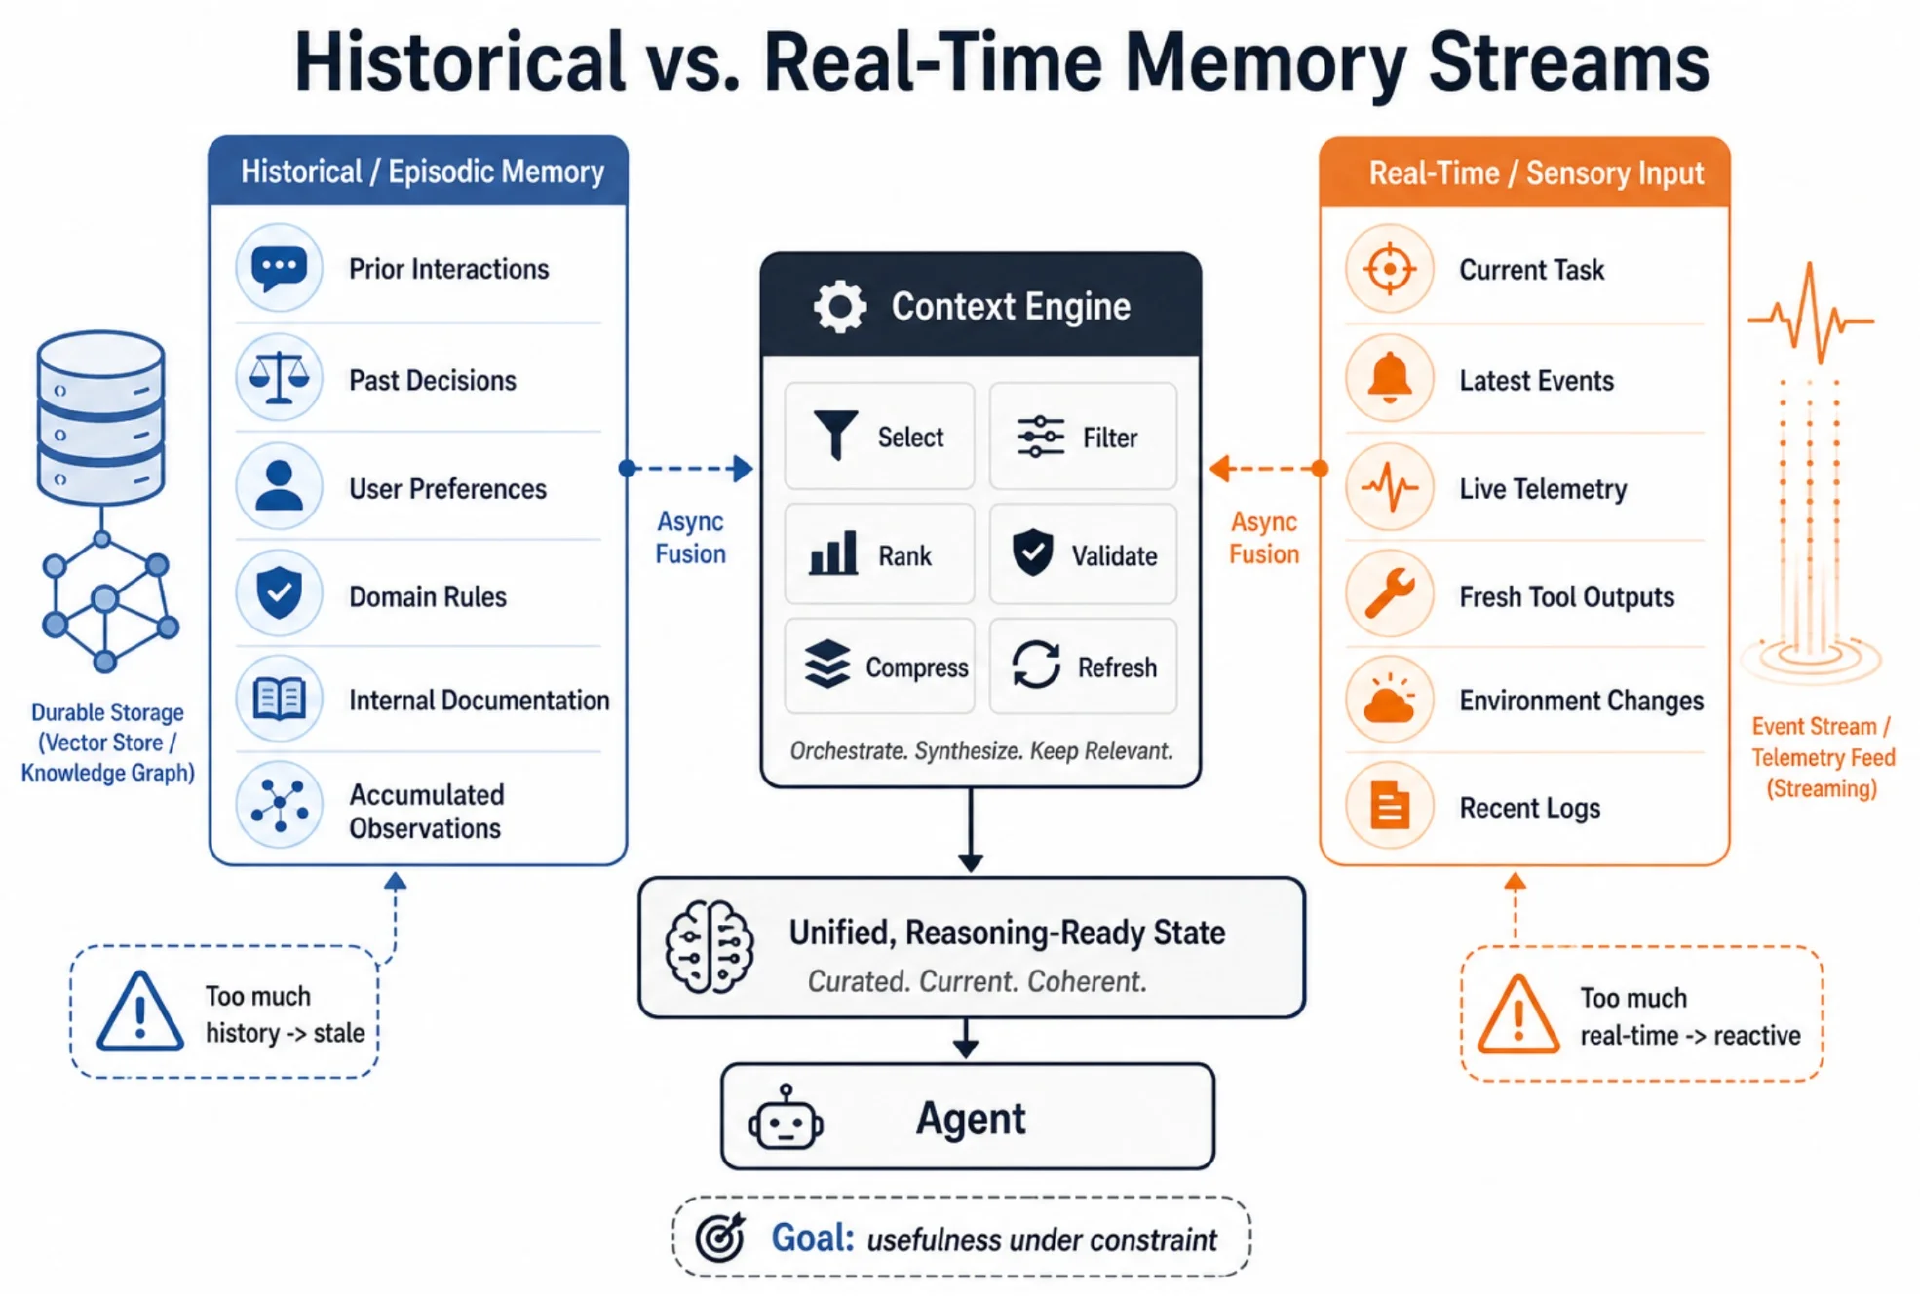
我们提出“上下文即控制平面”的架构范式,将组织、行为和情境数据作为集中治理层,而非硬编码进应用或微服务。上下文引擎充当了关键的编排器,负责在信息抵达大模型推理端点前,对其进行选择、过滤、排序、结构化和安全保护。它从知识库中提取信息,归类到记忆层,并实时决定智能体的上下文状态。这一机制标志着从简单的提示词工程向系统工程的深层转变,旨在通过构建确定性状态机来约束概率性模型,确保输入经过身份认证、逻辑校验及PII剥离,从而在本地推理环境中保障安全性。
历史记忆与实时输入的异步融合
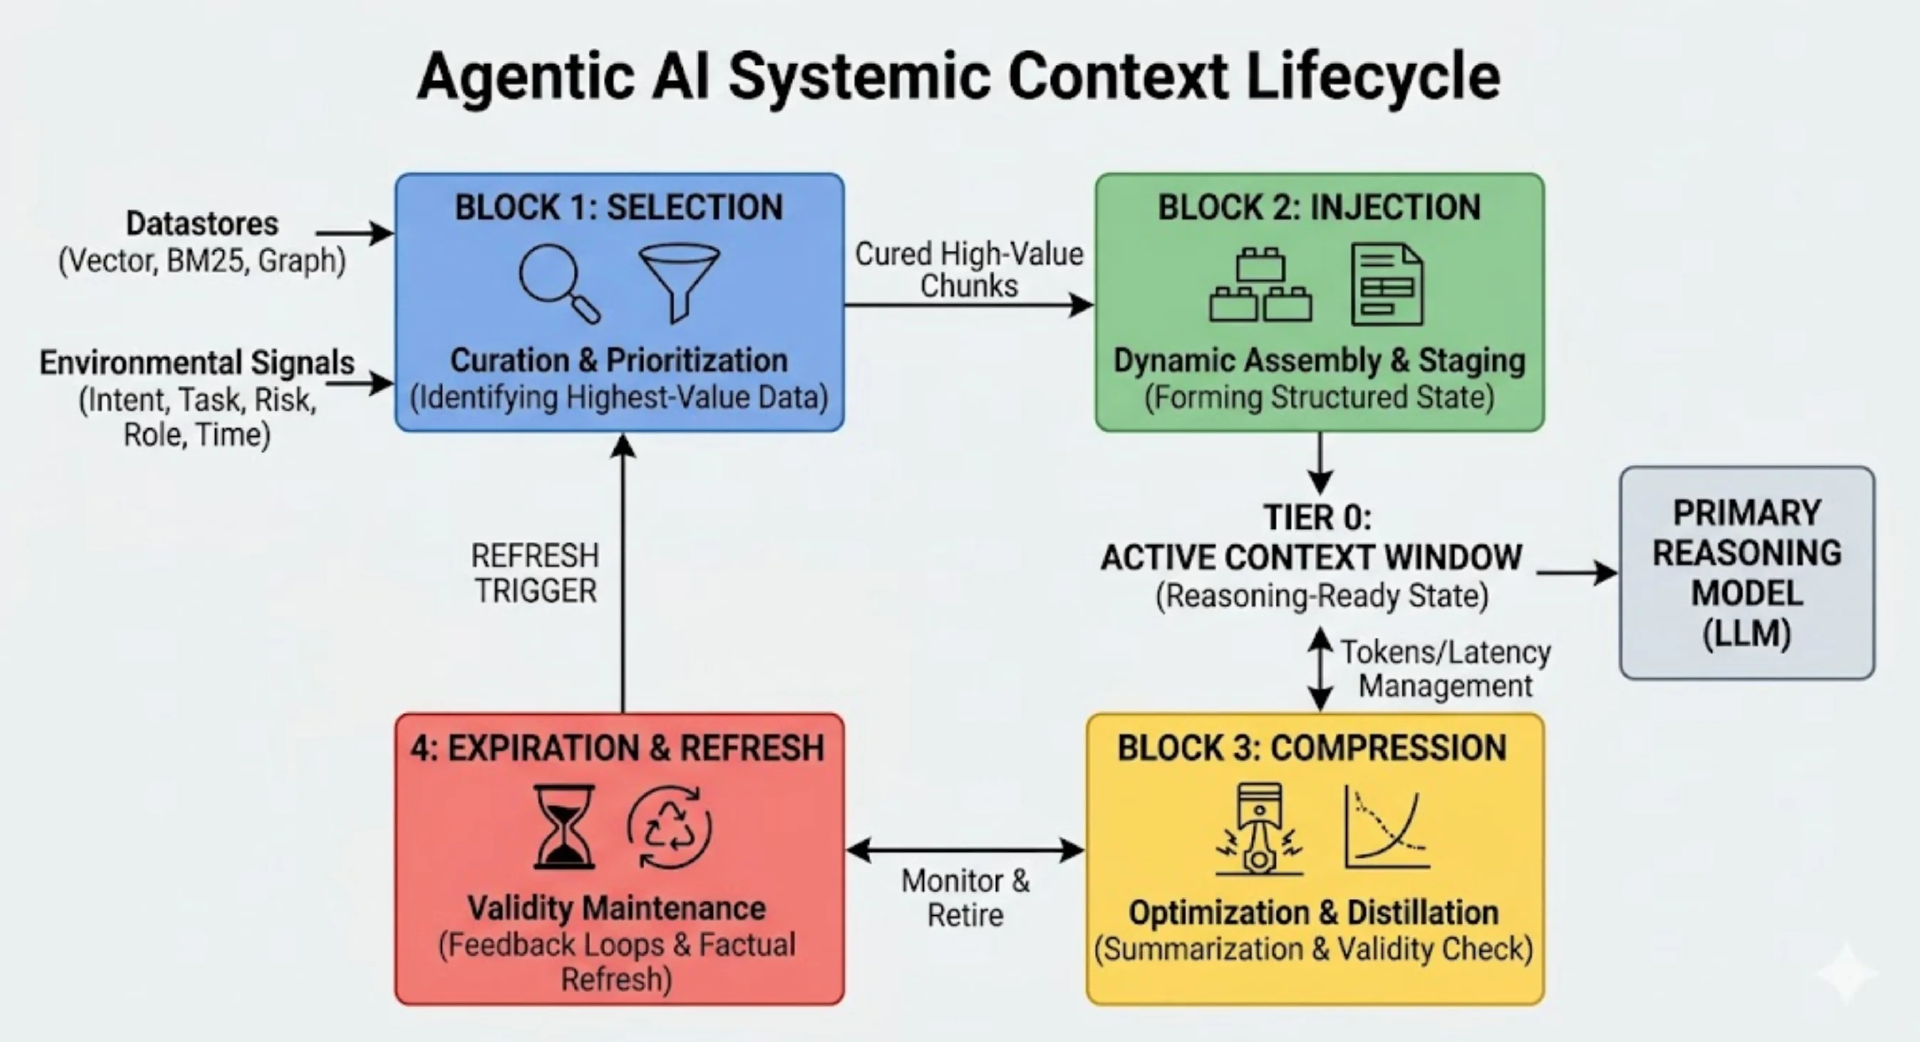
健壮的架构必须平衡长期“情景记忆”与即时“感知输入”。历史记忆包含过往交互、用户偏好和领域规则,赋予系统连续性;而实时输入涵盖当前任务、最新事件和遥测数据,确保智能体立足于当下。向量数据库擅长检索历史性语义事实,但无法满足亚秒级的实时上下文需求。以DevOps智能体为例,它既需要从向量库检索架构手册,也需要接入最近五秒的错误日志流。架构必须异步融合这些批量与流式数据源,避免智能体因过度依赖历史而滞后,或因仅关注实时信号而健忘。这种平衡是在有限上下文窗口和资源约束下,保证信息有用性的关键优化目标。
知识提炼:拒绝“SELECT *”式检索
常见的架构错误是将检索视为充分条件,等同于SQL中的“SELECT *”,盲目认为信息越多越好。标准RAG管道往往注入大量原始、碎片化且重叠的数据块,导致模型耗费算力在噪声中寻找有效信号,极易因关键信息被淹没而失败。真正的知识提炼应聚焦于累积洞见,通过后台工作进程或机器学习管道,将原始数据转化为结构化知识图谱或精简摘要。例如,针对大型数据库,可构建每12小时将一百万条数据条目汇总成一条的管道,确保模型接收的是经过合成的知识体,而非混乱的意识流。这种预处理显著提升了推理效率,降低了处理无效数据的资源浪费。
生命周期管理与定制化部署优势
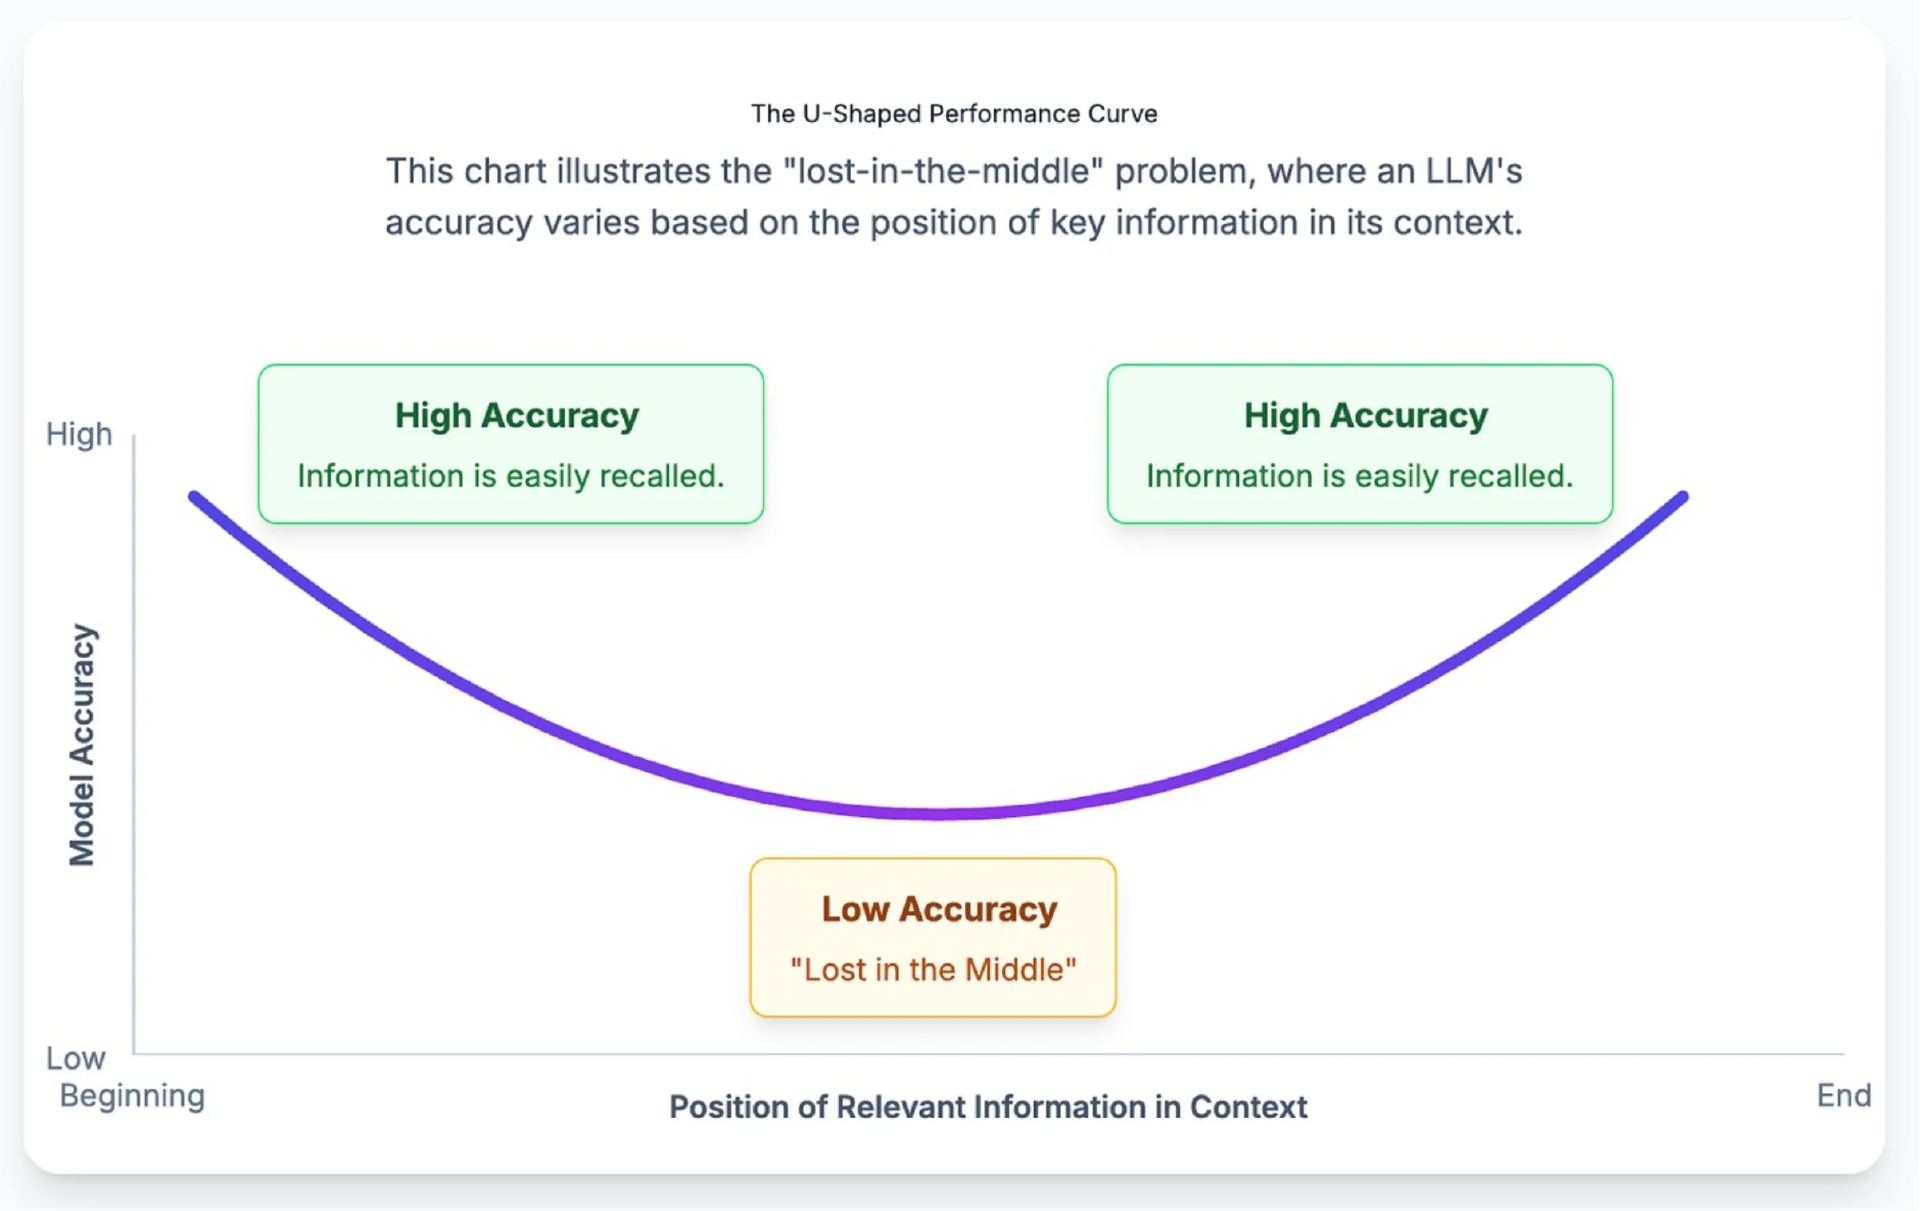
上下文应被视为一个连续的生命周期,包含选择、注入、压缩和过期刷新四个阶段。在选择阶段,采用混合搜索算法,结合稠密语义搜索、稀疏关键词搜索(如BM25)及知识图谱遍历,以识别高风险或可操作的数据点。在注入阶段,通过语义模板化确保数据格式匹配用户意图,信息的排布方式直接影响模型推理。在压缩阶段,利用更小、更快的模型或确定性算法总结对话历史,以满足Token上限约束。这种定制化且生命周期的管理方式,使企业能够基于自身业务领域设计专属上下文逻辑,避免“一刀切”的通用方案。通过系统化控制推理成本根源,该架构为私有化部署提供了更稳健、低成本且低幻觉的本地推理基础,确保了智能体系统在长期运行中的可靠性与经济性。
来源:InfoQ