
麒麟9050首跑30B MoE:达芬奇NPU升级,本地推理成本与算力双优化
逻辑折叠技术首次落地端侧
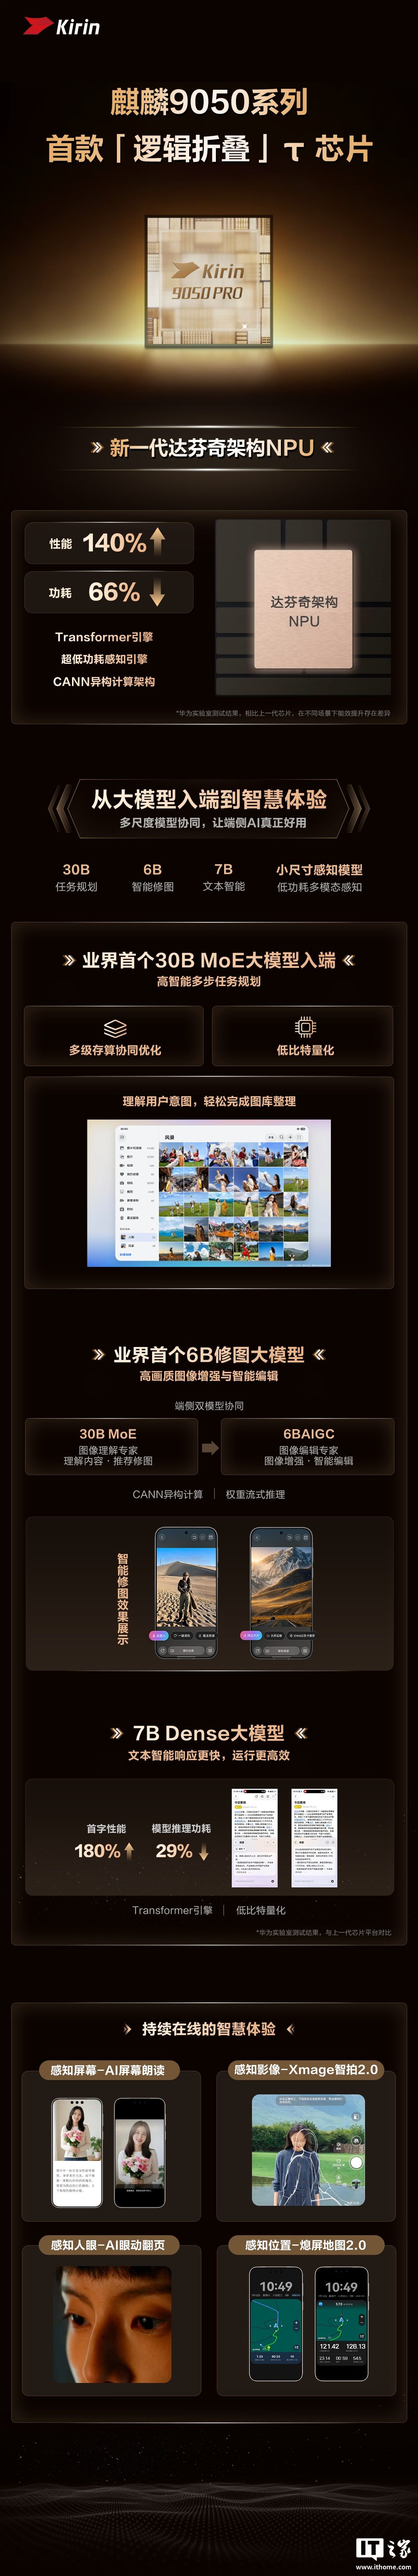
华为麒麟官方近日发布消息称,其首款采用「逻辑折叠」技术的τ芯片——麒麟9050系列正式官宣搭载新一代达芬奇架构NPU。该芯片最大亮点在于支持30B参数量的MoE大模型在端侧本地运行,彻底摆脱对云端计算的依赖,实现无需联网、无需等待云端响应的即时推理体验。这一技术路径不仅改变了传统大模型依赖服务器集群的部署模式,更将智能终端的算力边界推向新的高度,为后续私有化部署与离线应用提供了底层硬件支撑。
能效比优化重塑本地算力
新一代达芬奇架构NPU在核心性能指标上实现了显著突破,整体性能提升140%,同时将功耗降低66%。这种能效比的优化意味着在相同硬件功耗下,终端设备能够支撑更复杂的模型推理任务,从而大幅降低单位推理成本。对于注重隐私与响应速度的用户而言,本地化推理带来的算力效率提升,使得高频交互场景下的设备续航压力得到缓解,硬件与算力的协同优化正在重新定义端侧智能的性能天花板。
30B MoE模型端侧运行细节
此次落地的30B MoE大模型是业界首个进入终端侧的大规模混合专家模型。为适应移动端资源限制,该模型采用了多级存算协同优化技术与低比特量化方案。这些技术手段有效压缩了模型体积并提升了计算效率,使30B参数量的模型能够在端侧硬件中流畅运行。从开放权重到本地推理,这种技术迁移不仅降低了数据隐私泄露风险,更通过优化量化策略,让高阶AI能力得以在消费级硬件上实现闭环,证明了大模型小型化与端侧部署的可行性。
CANN架构赋能异构计算
底层架构方面,新NPU支持Transformer引擎、超低功耗感知引擎以及CANN异构计算架构。CANN作为华为自研的异构计算架构,能够高效调度不同计算单元,确保复杂AI任务的高效执行。异构计算的引入使得感知、决策与控制类任务可以并行处理,进一步释放了硬件潜能。这种架构级的优化,不仅提升了单一模型的运行效率,更为未来多模型协同、多任务并发的复杂场景奠定了坚实基础,使得终端设备具备更强的通用智能处理能力。

交互场景与未来演进方向
在具体功能应用上,新NPU将支持感知屏幕-AI屏幕朗读、感知影像-Xmage智拍2.0、感知人眼-AI眼动翻页及感知位置-熄屏地图2.0等场景。这些功能直接依赖本地算力实时处理,极大提升了交互的流畅度与隐私安全性。回顾华为在2026年10月举行的麒麟媒体沟通会,相关高管曾指出该系列将开启未来10年新征程,并设定了2031年实现P核频率突破5GHz的目标。当前30B模型入端仅是起点,随着硬件算力持续迭代,端侧AI将从单一功能走向系统级智能代理,推动硬件与算力在终端生态中的深度重构。
来源:IT之家