
TokenSpeed 重构架构,本地推理引擎优化 Agentic 延迟与算力
Agentic 负载下的推理困境
传统 Chat 场景的推理引擎在 Agent 工作中面临结构性失效。Agent 负载由多轮短请求构成,前缀上下文长达几十 K,而单次输出仅几百 token。这种模式导致传统吞吐优化目标失效,KV Cache 利用率不足,且用户对延迟极度敏感。TokenSpeed 指出,必须重新审视缓存复用策略与调度机制,在延迟约束下追求每用户 TPS 不低于 70 的吞吐量。
在性能对比中,TokenSpeed 在 batch size 等于 1 的最小延迟场景下,端到端延迟比 TensorRT-LLM 快 9%。在每用户 100 TPS 的典型工作点,每个 GPU 吞吐高出 11%。缓存复用率是成本关键,DeepSeek 的复用率据称超 99%,而多数系统仅 70% 到 80%。测试显示,TokenSpeed 在上下文从 128K 扩展到 1M 时,解码吞吐率仅下降 16%,验证了其在长上下文下的高效性。
硬件特性与架构耦合
模型架构与硬件特性耦合加深,MOE 成为主流但优化难度高。以 Kimi K3 为例,其 896 个专家采用 Latent MOE 技术,激活专家比例提升至 16%,但路由通信复杂度增加。Blackwell 引入 Tensor Memory 等新特性,若引擎无法充分利用,硬件优势无法释放。TokenSpeed 在 Kernel 层针对 Blackwell 做深度优化,并考虑 AMD CDNA 架构特性,确保硬件潜力挖掘。
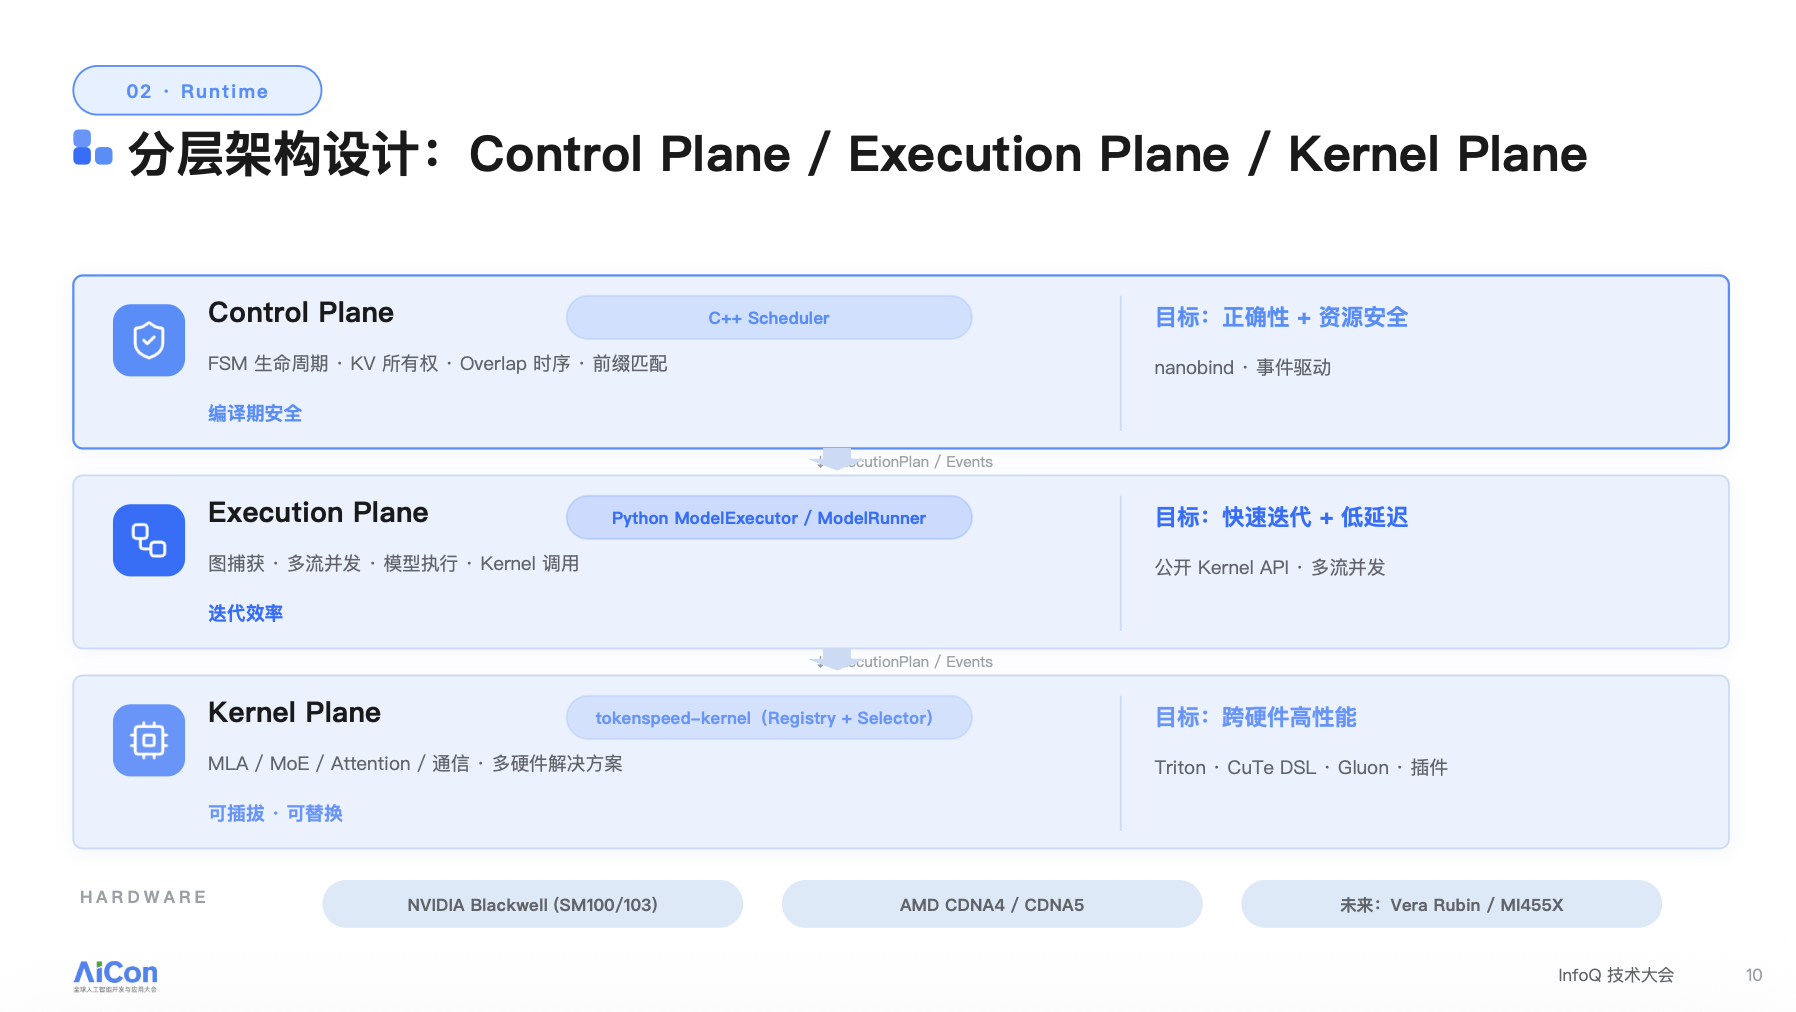
Runtime 与 Kernel 协同设计至关重要。调度器与底层算子需系统性解耦,避免性能瓶颈与 Bubble 问题。TokenSpeed 将调度、执行和算子重构,形成清晰模块边界。控制面用 C++ 编写,Runtime 用 Python,Kernel 独立为子包,这种设计让 NVIDIA 和 AMD 专家可针对硬件深度优化,无需理解调度内部逻辑,提升了私有化部署中不同硬件的适配效率。
自动并行编译系统
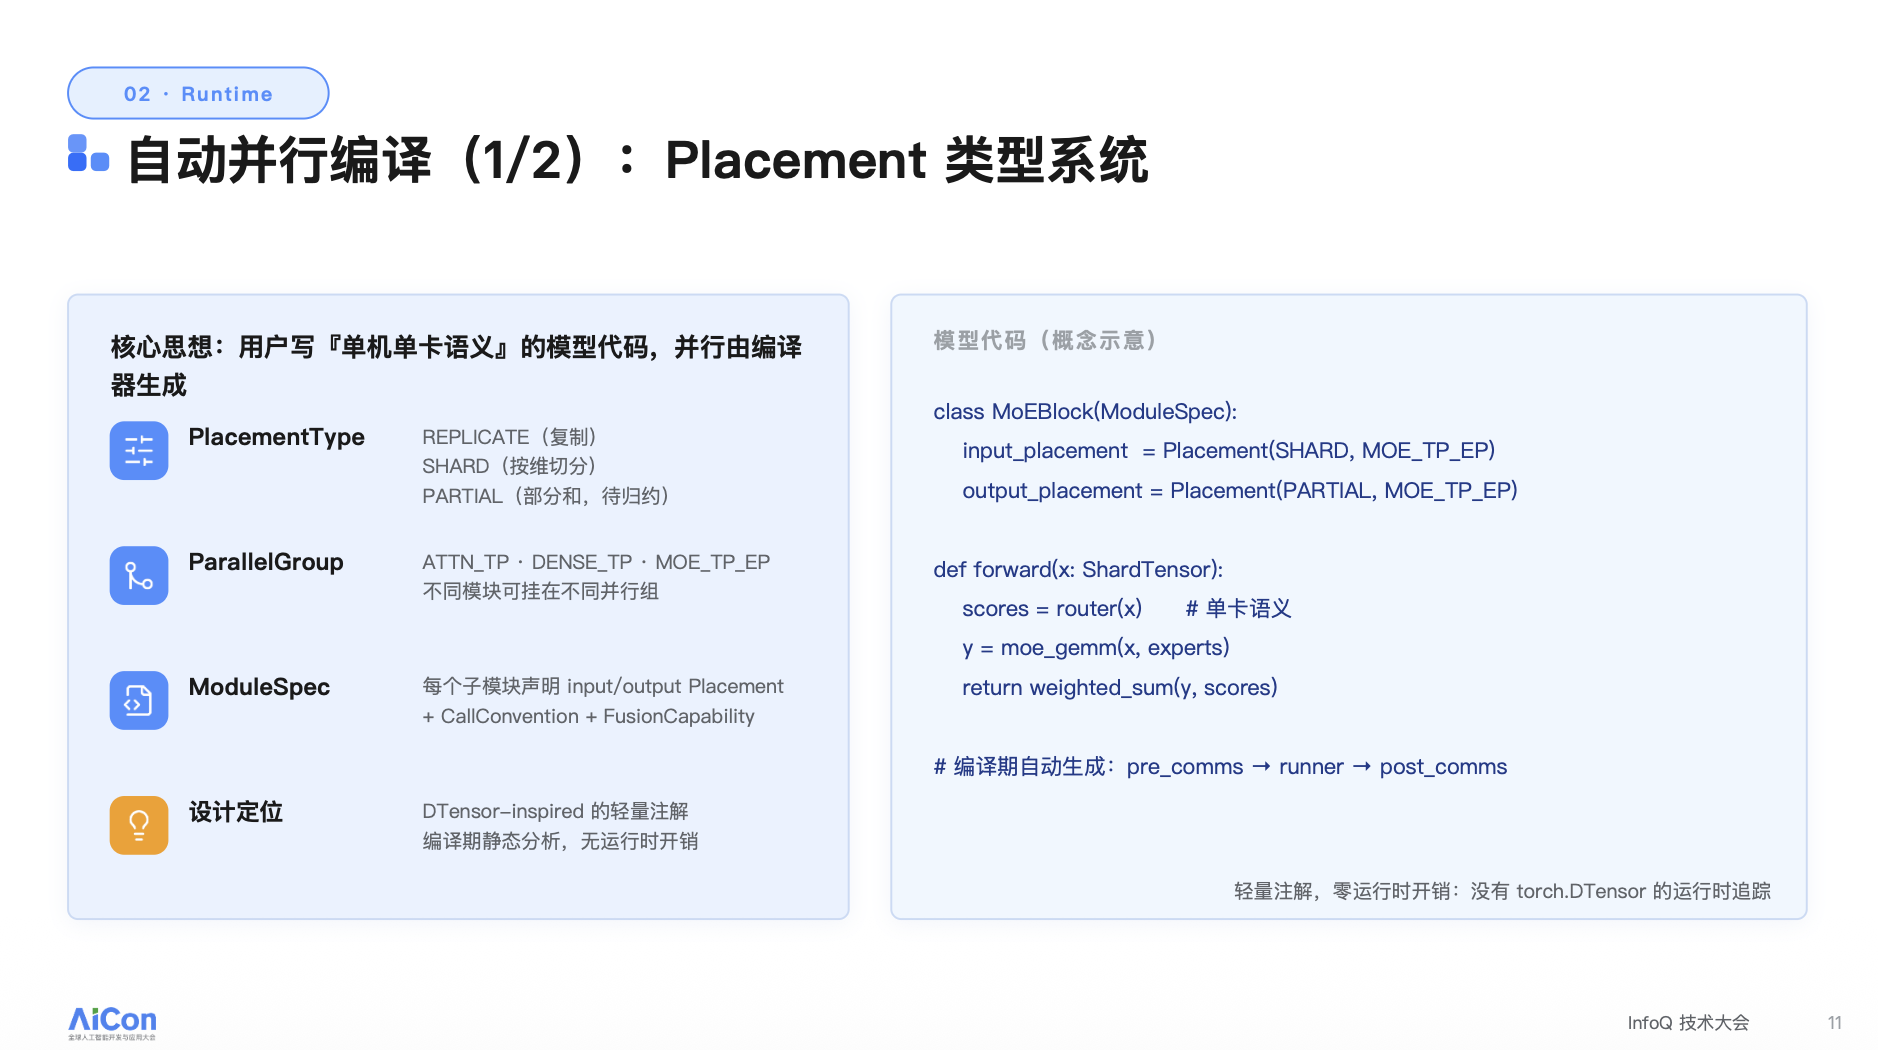
TokenSpeed 将并行切分逻辑从模型适配中抽离,建立独立 Placement 系统。开发者只需声明模块边界与并行属性(replicate、shard、partial),系统自动处理切分通信。当相邻模块 Placement 不一致时,自动插入 all-reduce、all-gather 等原语。输出统一的 compiled_decoder_layer 执行计划,分为 prefill 对齐、算子执行、通信输出三阶段。这种自动化不仅降低维护成本,还通过类型系统支持算子 fusion,减少 kernel launch 开销。
状态机驱动的资源管理
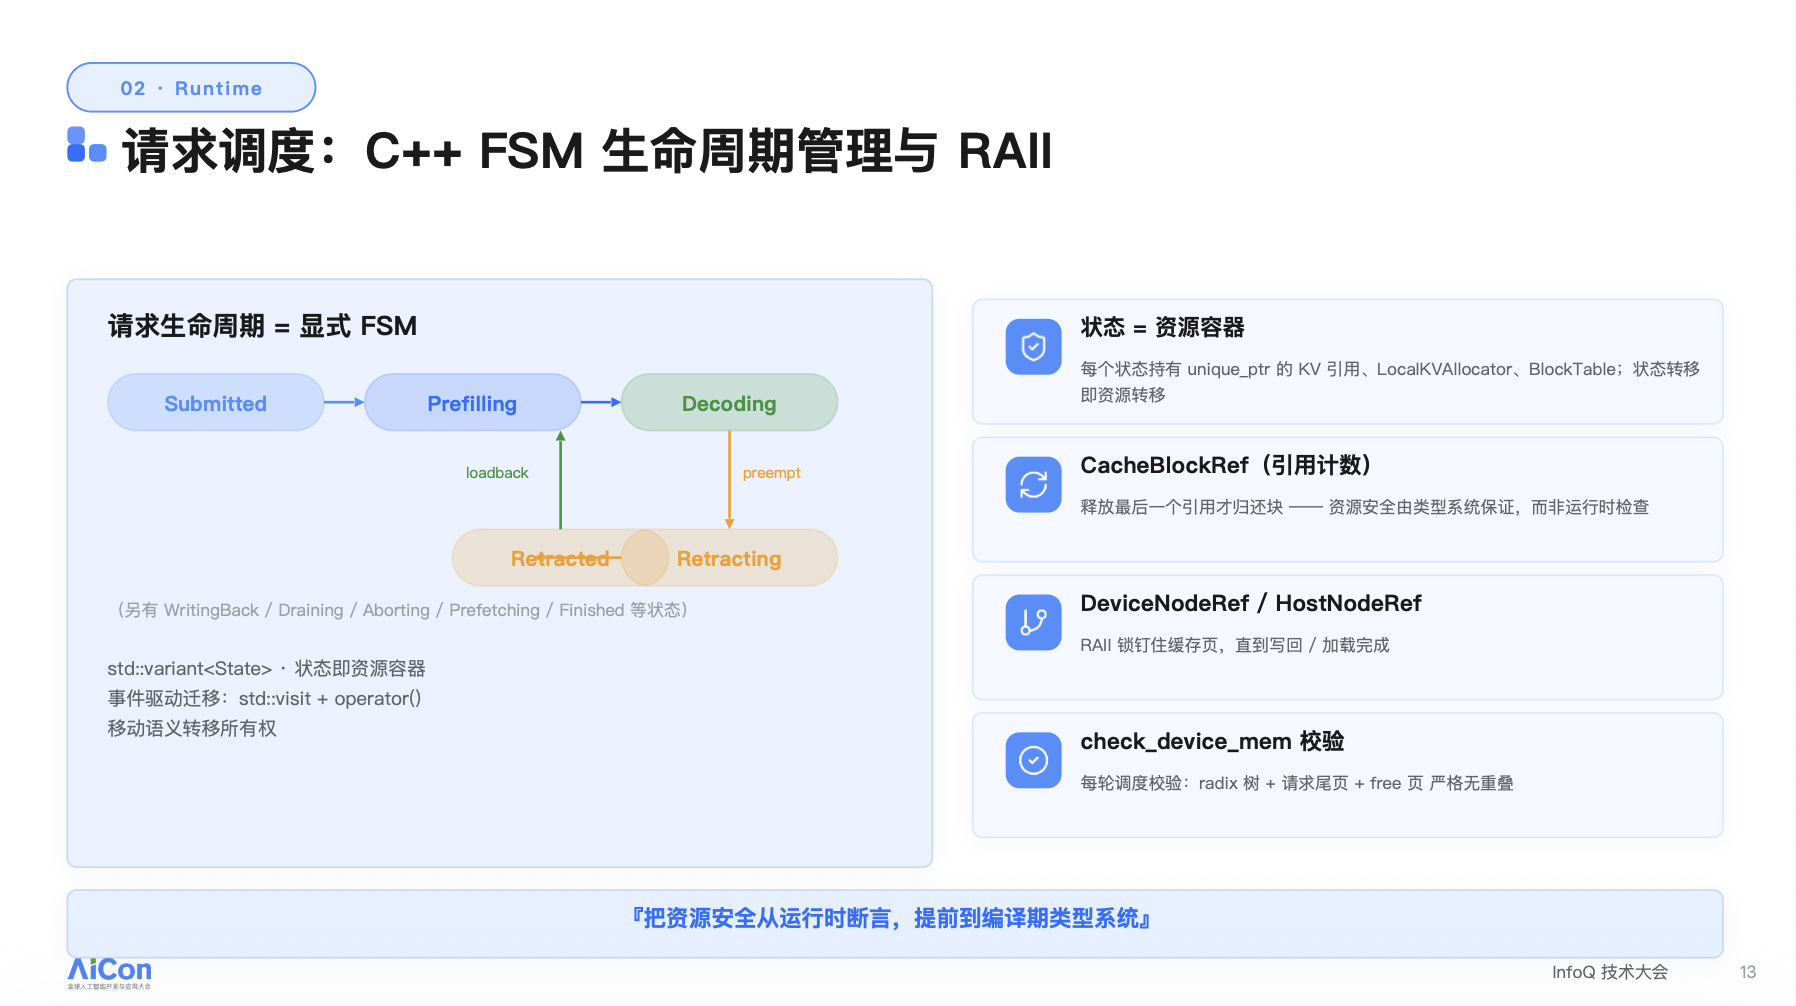
控制面核心是覆盖请求全生命周期的状态机,状态包括 submitted、prefilling、decoding、retracting/timeout、finished。每个状态持有 KV 页、SSM/MLA slot 等资源引用。状态迁移通过事件驱动,资源所有权通过 C++ unique_ptr move 语义传递。资源采用 RAII 方式管理,确保在操作完成前不被提前释放。这种设计将资源管理错误提前至编译期检查,显著降低并发调度中的竞态与泄漏问题。
本地推理成本优势
基于上述架构与优化,TokenSpeed 在本地推理场景下展现出显著的成本控制能力。通过高缓存复用率减少 prefill 计算开销,结合自动并行编译降低多卡部署的适配复杂度。对于采用开放权重模型进行私有化部署的企业,该引擎能有效平衡延迟与算力利用率,特别是在长上下文 Agent 任务中,通过精准的资源调度与硬件适配,大幅降低单位推理成本,提升本地算力平台的实际产出效能。
来源:InfoQ