
腾讯MaaS升级本地推理治理,私有化部署助力Agent降本增效
模型供给丰富化驱动统一调度需求
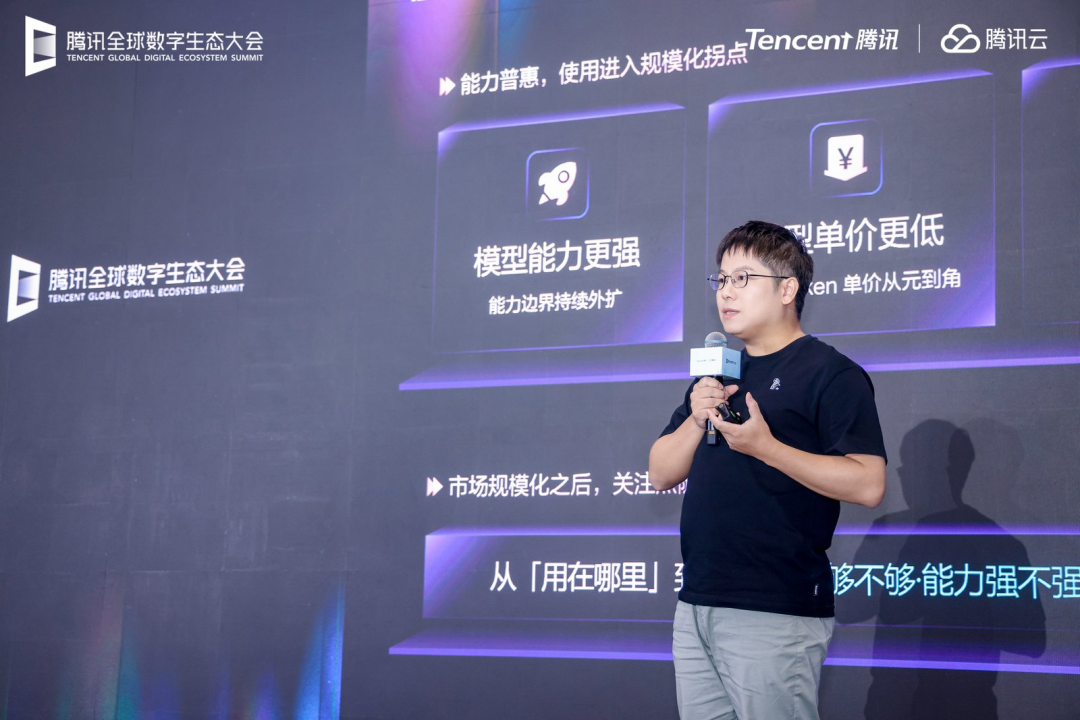
随着模型能力向超长上下文和复杂任务规划拓展,企业面临的挑战从单纯接入模型转变为对多种模型的持续比较与调度。腾讯云在2026年10月30日全球数字生态大会上指出,模型正以泛办公场景为代表加速渗透。为了应对这一变化,TokenHub平台将多模型接入、调用调度和企业治理纳入统一体系,旨在让模型选择、用量控制与服务治理协同运作。
统一入口与分级服务策略
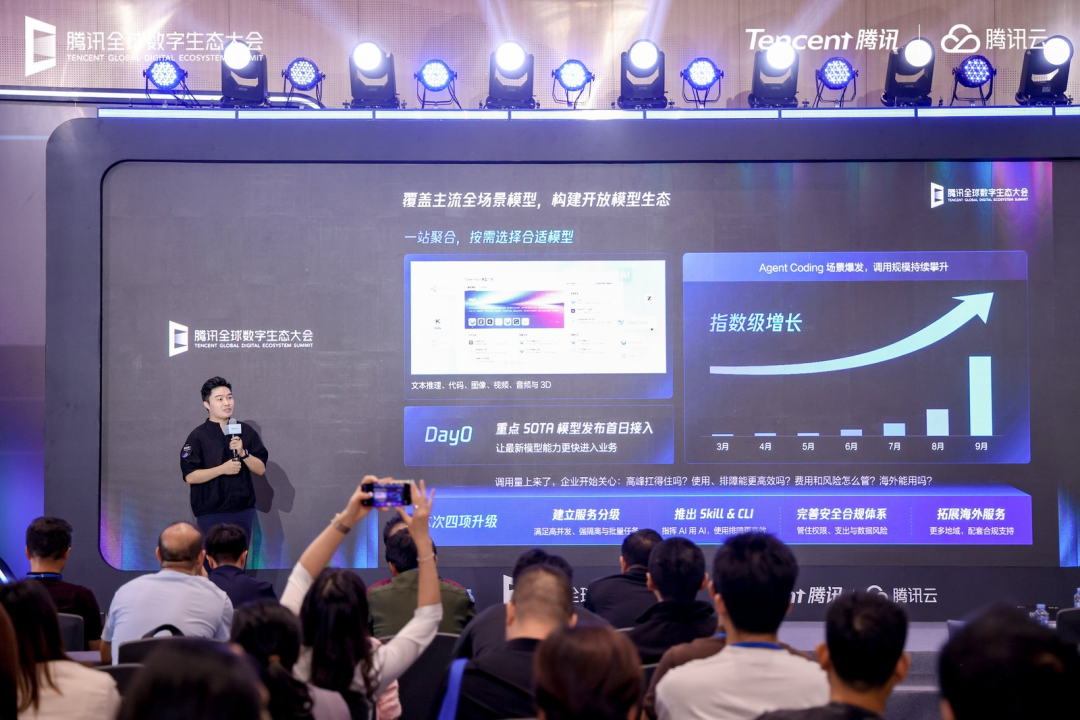
TokenHub接入混元及多家厂商模型,覆盖文本、代码、图像、视频等场景,重点模型支持Day 0接入。平台通过统一API Key兼容主流协议,减少应用适配成本。针对不同负载需求,服务被细分为多种形态:流量高峰场景可通过按月预留TPM保障吞吐;敏感业务如金融风控可使用独立物理集群运行的模型单元;时延要求宽松的批量任务则适合离线推理。这种分级机制使资源分配更贴合实际业务负载。
成本治理与任务级归因
当调用规模扩大,成本与权限管理成为核心痛点。TokenHub支持按模型授权、额度限制及分账核算,通过Request ID实现调用记录检索与异常排查。对于研发团队,平台提供Token Plan企业版订阅及Saving Plan月度承诺优惠。更进一步,平台探索将Token用量归因到具体任务,结合部门、应用和工作内容分析,帮助企业判断模型调用带来的实际价值,从而实现精细化的预算管理。
安全边界与合规化部署
安全治理涵盖基础设施、数据内容与调用合规等多个环节。基础设施侧提供私网访问、算力隔离及AICC可信运行架构;数据侧实施输入输出检测与内容防护。针对敏感业务,LLM-WAF可作为增值服务检测提示注入,并支持推理日志零数据留存(ZDR)配置,确保业务正文不用于平台训练。此外,新加坡和美国硅谷地域已上线,法兰克福计划于2026年第四季度上线,以满足跨区域运营企业的数据合规需求。
推理效率优化与硬件适配
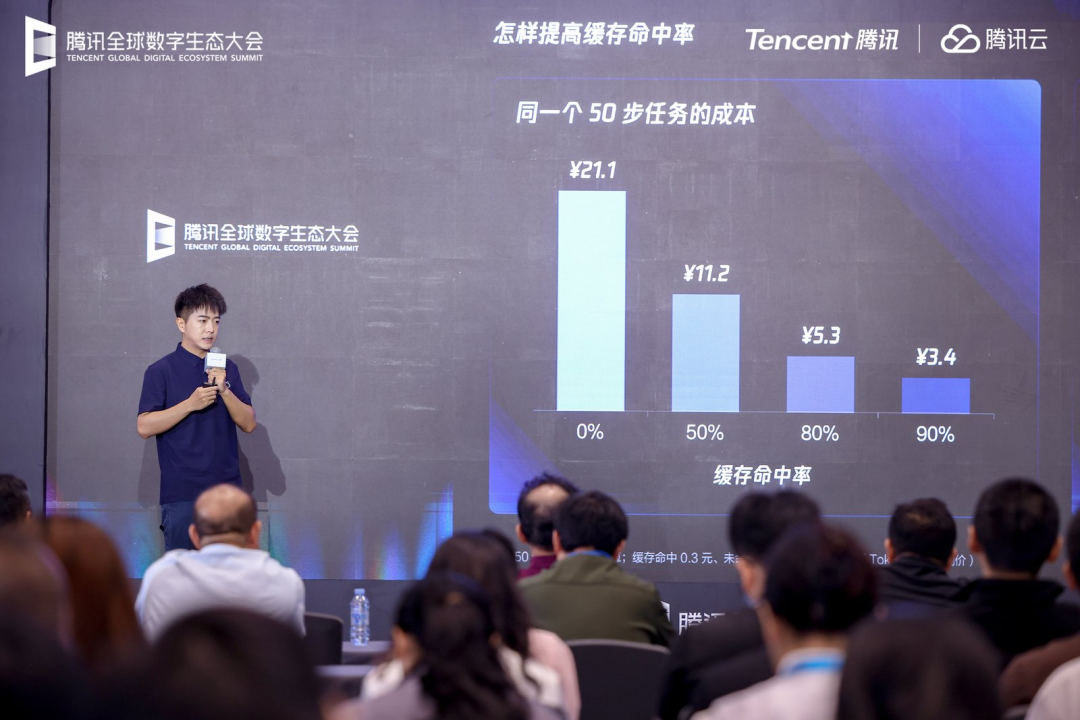
长任务场景下,反复读取上下文导致输入Token占比高达99.4%。WorkBuddy团队通过固定提示词结构和前缀缓存复用,将缓存命中率提升至90%时,单任务估算成本可从约21.06元降至约3.36元。同时,TI-ONE训推平台通过优化数据通路、算子及并行通信,适配不同芯片。在特定国产芯片测试中,Hy4 preview单卡推理吞吐较初始版本提升5倍,体现了软件栈与硬件适配对推理效率的关键影响。
任务交付视角下的平台价值
模型服务最终需嵌入业务流程以交付结果。一次用户请求平均触发约7.2次模型调用,复杂任务超过50步并不罕见。通过约八成简单步骤交给轻量模型,单任务成本可降低约57%。平台与应用侧策略共同支撑长任务的效率与稳定性,使企业能够以可控成本实现任务持续推进。这种从调用到交付的闭环,标志着MaaS服务进入生产化阶段。
来源:InfoQ