
Meta 重回开源,24GB 单卡跑本地智能体:Muse Glimmer 30B 发布
比 Llama 更开放的许可证:Apache 2.0,无附加条件
Meta 今天开源了 30B 参数稠密模型 Muse Glimmer,权重已上架 Hugging Face,采用 Apache 2.0 许可。对私有化部署团队来说,这是 Llama 时代之后 Meta 第一次把旗舰级模型完整交给社区:没有 7 亿月活的商用门槛,没有修改与分发的限制,法务部门可以直接放行。Meta 同时预告下一代旗舰 Muse Spark 1.2 的权重也将很快开放——如果兑现,美国头部实验室里第一个开放权重的前沿模型就落地了。一个采购细节:开放的是权重,训练数据和训练代码并未发布。
24GB 单卡:30B 智能体怎么塞进开发者机器
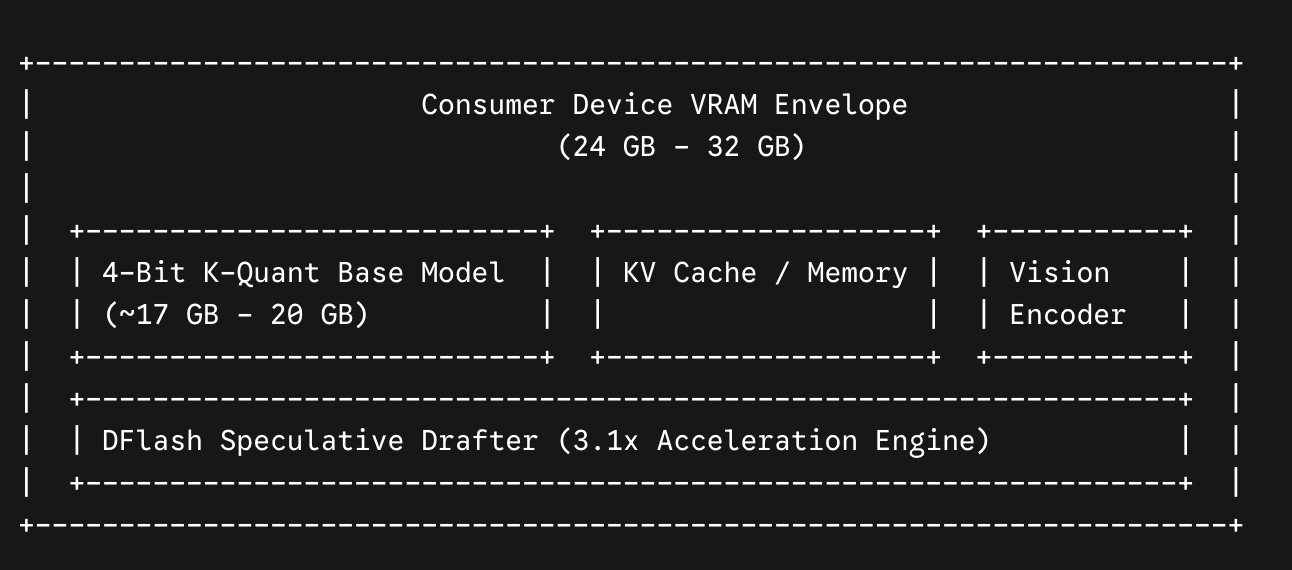
全精度权重需要 55GB 以上显存,消费级单卡碰不到。Meta 给出两档 4-bit 量化:K-Quant-17GB 把语言模型权重压到 20GB 以内,连上 KV 缓存、1.8B 参数的视觉感知编码器和 DFlash 投机解码辅助模型,完整栈装进 24GB 显存,RTX 3090、RTX 4090 即可运行;K-Quant-Dynamic 瞄准 RTX 5090 的 32GB。Mac 侧用统一内存顶显存,M4 Max、M5 Max 的 32GB 以上 MacBook Pro 或 Mac Studio 能跑全栈。Meta 自测(厂商自报数据):15 项基准上 32GB 版平均精度损失 0.2%,24GB 版 1%。8GB、16GB 的轻薄本没有入场券,64GB 全精度版属于数据中心 GPU 或顶配 Mac Studio 的层级。
智能体时延账:DFlash 投机解码 3.1 倍加速
智能体场景里一次用户请求会触发多轮模型调用和工具执行,每一步的时延都在复利。Meta 配套的 DFlash drafter 模型一次提议 16 个 token、主模型并行校验,输出不变但速度大幅提升:RTX 5090 上从 74.9 提到 233.4 token/秒(3.1 倍),Apple M5 Max 从 26.6 提到 50.2(1.8 倍),M4 Max 从 23.7 提到 37.8(1.5 倍)。NVIDIA 同日放出部署配方:单卡 Blackwell Ultra 在 BF16/NVFP4 精度下号称 2 万 token/秒吞吐(NVIDIA 自报数据),并给出 SGLang、vLLM 推理配方、一键 NIM 容器和 LoRA 微调支持,部署链路一直延伸到 Jetson 边缘设备——机器人和工业现场这类断网环境是本地推理的刚需场景。
训练路线与生态:从旗舰蒸馏,工具链一键就位
模型由 Meta 更大的旗舰 Muse Spark 蒸馏而来:预训练用 logit 蒸馏,中期训练集中在长上下文、智能体密集的数据上,后训练混用监督微调、在线蒸馏与强化学习。生态本周起陆续铺开:Ollama、LM Studio、vLLM、SGLang、llama.cpp、MLX、ExecuTorch 均有支持,Unsloth 做本地运行时,微调走 PyTorch TorchTitan,Meta 还在与 AMD、Arm、戴尔、英特尔、英伟达做跨设备优化。
基准表现:工具调用强,终端操作仍逊一筹
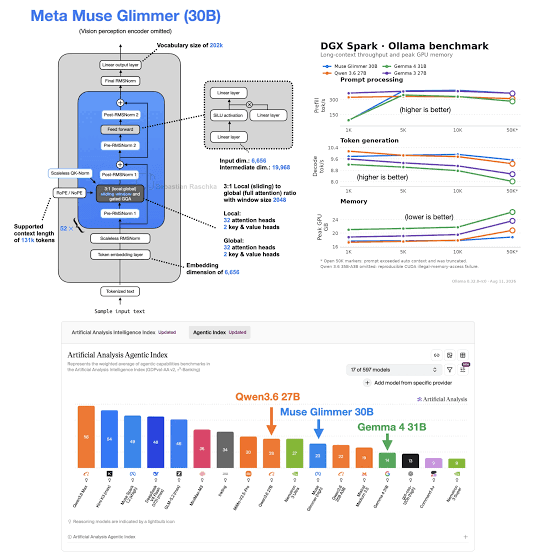
按 Meta 官方对比(厂商自报):SWE-Bench Pro 上 Glimmer 51.2,压过 Gemma4-31B 的 36.9 和 Qwen3.6-27B 的 50.2;上下文 12 万 token 以上,原生读图、支持 100 多种语言。Meta 的演示贴近企业实景:Glimmer 自主发现局域网里的 Home Assistant 实例,查询设备 API,从零写出一整套监控面板,再拉起本地服务验证自己的产出——模型要在与外部系统交互中持续保持计划。但操作系统级任务上,同尺寸 Qwen 的 OSWorld-Verified 75.6 对 Glimmer 65.9、TerminalBench 2.1 60.7 对 51.7 仍然领先。一句话:本地部署买的是数据不出门,代价是同尺寸单机能力距云端前沿还有版本差。
硬件选型速查
16GB 以下内存别考虑;24GB 卡选 K-Quant-17GB;32GB 卡或 M4/M5 Max 选 K-Quant-Dynamic;隔离合规、气隙环境叠 DGX Station 或 Jetson。本地化省掉按 token 计费的 API 账单,但硬件、电力、运维成本随之进账——跑常驻高频智能体负载前,建议把一张卡的全年持有成本算一遍再下单。
来源:Meta AI Research 官方博客、Hugging Face 模型卡、VentureBeat、InfoQ、NVIDIA 开发者博客;量化精度损失与吞吐数据为厂商自报实测。