
12GB 显存就够:全双工全模态 AI 的硬件门槛,被面壁 9B 模型改写
首个 9B 级「看、听、说」全双工模型:一张消费级显卡跑通
面壁智能联合 OpenBMB 开源社区、清华大学 THUNLP 与 THUMAI 实验室发布了 MiniCPM-o 4.5 技术报告,并同步开放全模态全双工 API。模型总参数约 9B,采用面壁与清华联合研发的 Omni-Flow 流式全模态框架,把视觉、音频、文本等多路输入流对齐到毫秒级共享时间轴:模型在持续感知环境的同时进行思考与响应,用户可以随时打断、插话,无需依赖外部语音活动检测(VAD)组件。自今年 2 月模型开放以来,Hugging Face 下载量已突破 25 万+。
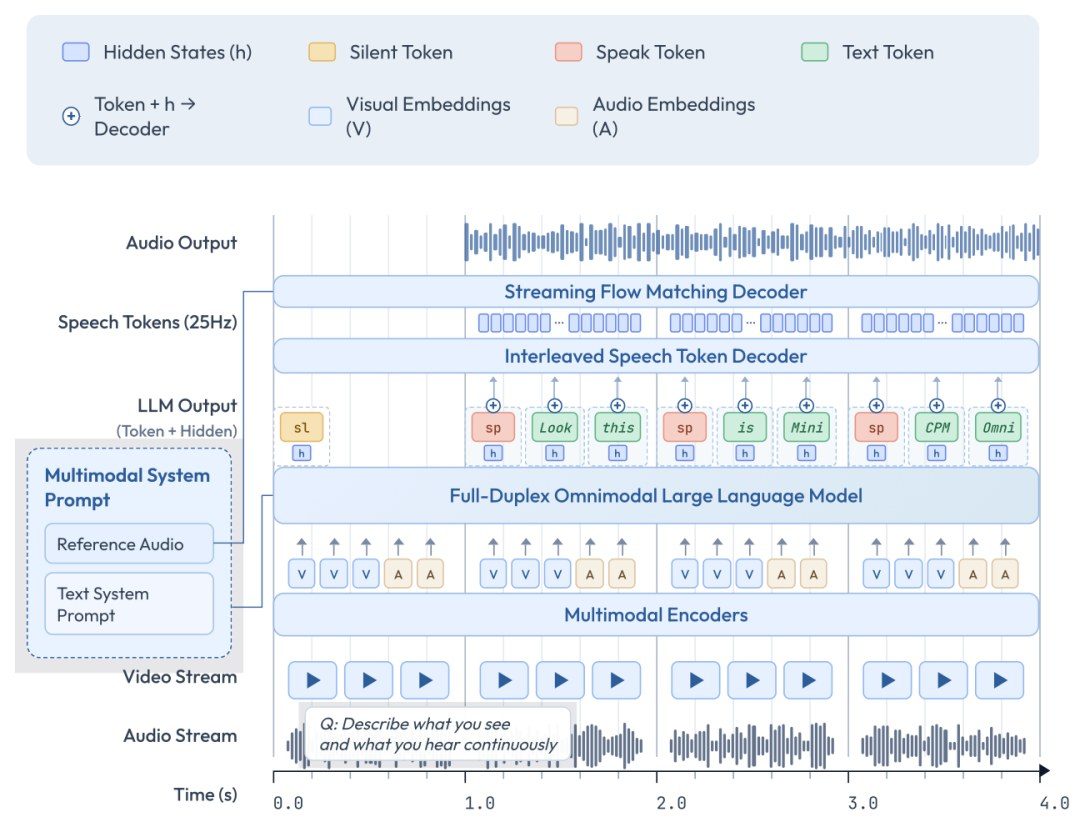
硬件选型:显存门槛重新定义到 12GB
对端侧部署者而言,这份报告最有价值的信息是成本。官方已基于 llama.cpp 完成模型量化与推理优化:在 NVIDIA RTX 5070(12GB 显存)上采用 4bit 量化(GGUF Q4_K_M),实测最低 12GB 显存即可运行,全双工模式流畅度达 RTF 0.4,即处理 1 秒音频流仅需 0.4 秒。技术报告还披露 INT4 版本仅需约 11GB 显存,约为 Qwen3-Omni 同规格 INT4 版的一半,解码速度 212 tokens/s,比 Qwen3 快 40% 以上(以上效率数字均为厂商自报,尚缺独立复测)。macOS 侧 M1–M5 Max(含 M5 Pro)且内存 16GB 以上的机器可用,官方提供 Windows/macOS 一键安装包 Comni,把「装环境、下模型、跑 Demo」三步合并成一次点击。
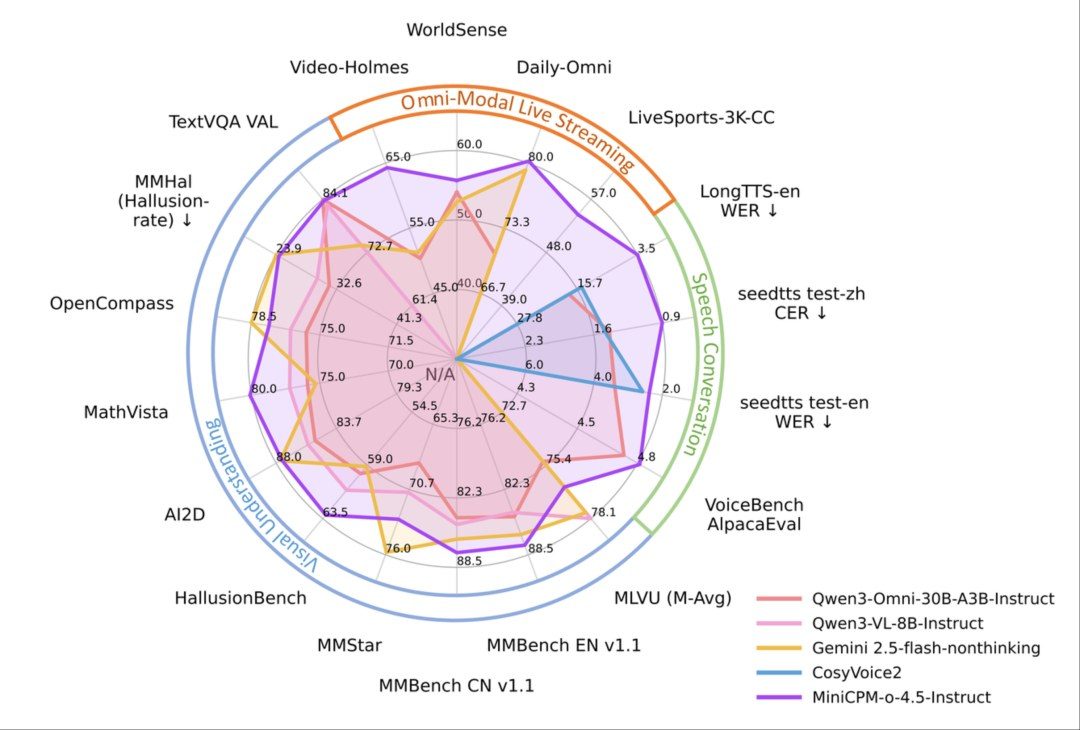
全双工到底能做什么
能力侧,面壁自报 9B 的 MiniCPM-o 4.5 在多项音视频联合理解基准上全面超越 Gemini 2.5 Flash 与 Qwen3-Omni,全双工视频理解基准 LiveSports-3K-CC 胜率 54.4%;语音生成的中英文错误率与情感表现均优于 Qwen3-Omni 和 CosyVoice2。同步开放的全模态全双工 API(api.modelbest.cn 端点)目前免费,全双工下无需 VAD 控制轮次,开发者可直接构建实时对话类应用;Demo 全栈代码已开源,Linux 用户可克隆仓库本地部署完整服务。
我们的选型判断
全双工全模态对企业端侧部署的意义,集中在三类场景:需要持续监控路况与驾驶员状态的车载座舱、为视障人士主动播报环境变化的无障碍辅助、以及需要机器人自主决定交互时机的具身智能。它们的共同点是 AI 不再是「一次性问答工具」,而是「沉默的观察者 + 及时的提醒者」——这正是对讲机式半双工交互做不来的。硬件上,12GB 显存成为「会看、会听、会说话」的多模态助手单机部署的入门线:企业做私有化试点的门槛,从服务器级显卡降到了单张消费级显卡;而「数据不出设备」对医疗、座舱、个人隐私类场景天然合规。对 ROI 而言,以车载座舱为例:传统「云 API + VAD 轮次」方案按 token 持续计费,还有网络延迟与断网风险;换成端侧 9B 全双工模型后,硬件只是一张 12GB 消费级显卡,推理边际成本趋近于零——对 7×24 小时持续监测驾驶员状态的车队,数月的 API 费用即可摊掉硬件投入。若团队打算以 API 方式接入,当前免费定价与免 VAD 依赖,是现阶段两个很实际的采用理由;对个人开发者,免费 API 与一键 Comni 安装包同样是最低成本的上手路径。