
KV Cache 不随上下文增长:一张 80GB 卡扛 512 路长推理,EdgeRock-4B 改写显存账本
一条新闻:把 KV Cache 从“变量”变成“常量”
岩山科技(002195)旗下岩芯矩阵,联合香港科技大学、卡内基梅隆大学等高校,发布并开源了多模态模型 EdgeRock-4B。它的技术底座是 Qwen3.5-4B 权重转换而来,保留了循环层,把全注意力层换成 1024 token 的局部窗口,再引入“记忆岩锚”(RMA):一个固定容量的锚点库,负责从更早的历史里挑出值得记住的细节。模型与推理代码均已公开,支持文本和图像推理,可商用。
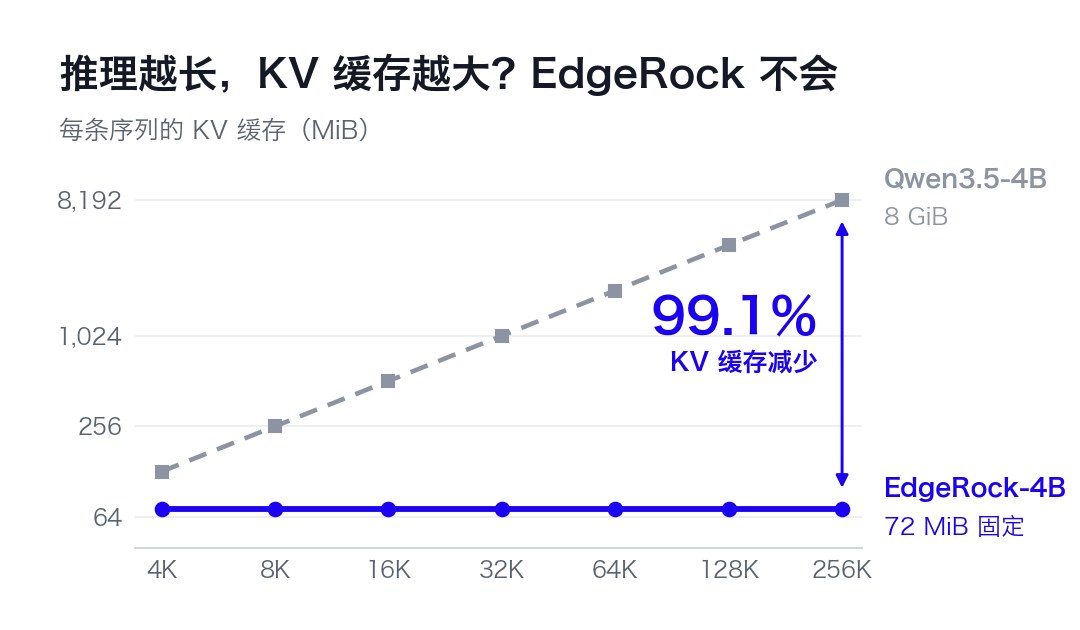
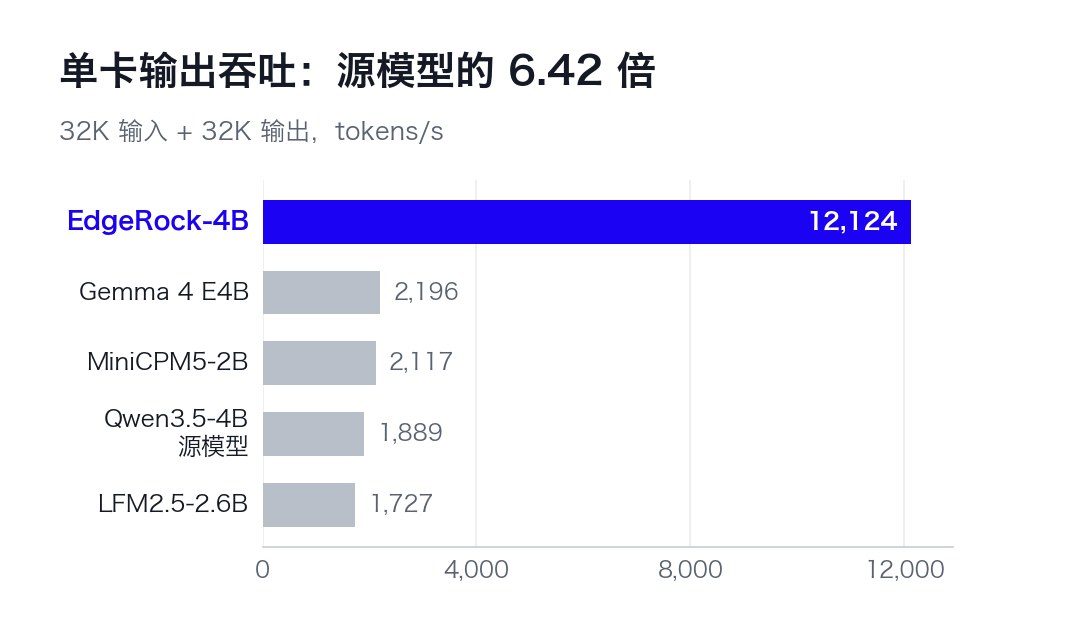
核心数据有三组,全部来自官方白皮书与岩山科技官微,多家媒体交叉核对:其一,在 256K 上下文下,每条序列的注意力 KV 固定为 72MiB,而源模型 Qwen3.5-4B 在同一长度需要 8GiB,减少 99.1%;叠加循环状态后,单条序列的全部持久历史状态固定在 97.76MiB,不随推理长度增长。其二,在单张 NVIDIA Hopper 80GB GPU 上,32K 输入加 32K 输出的长生成任务,EdgeRock-4B 可同时跑 512 条序列,输出吞吐 12124 tokens/s;源模型在最优批大小 64 下只有 1889 tokens/s,提升 6.42 倍。其三,推理能力基本保住:AIME 2024—2026 平均一次通过率达 82.9%,是 16 个有界状态对照模型最高分(18.8%)的 4.4 倍,保留源模型推理能力的 96.3%。
给私有化部署算一笔显存账
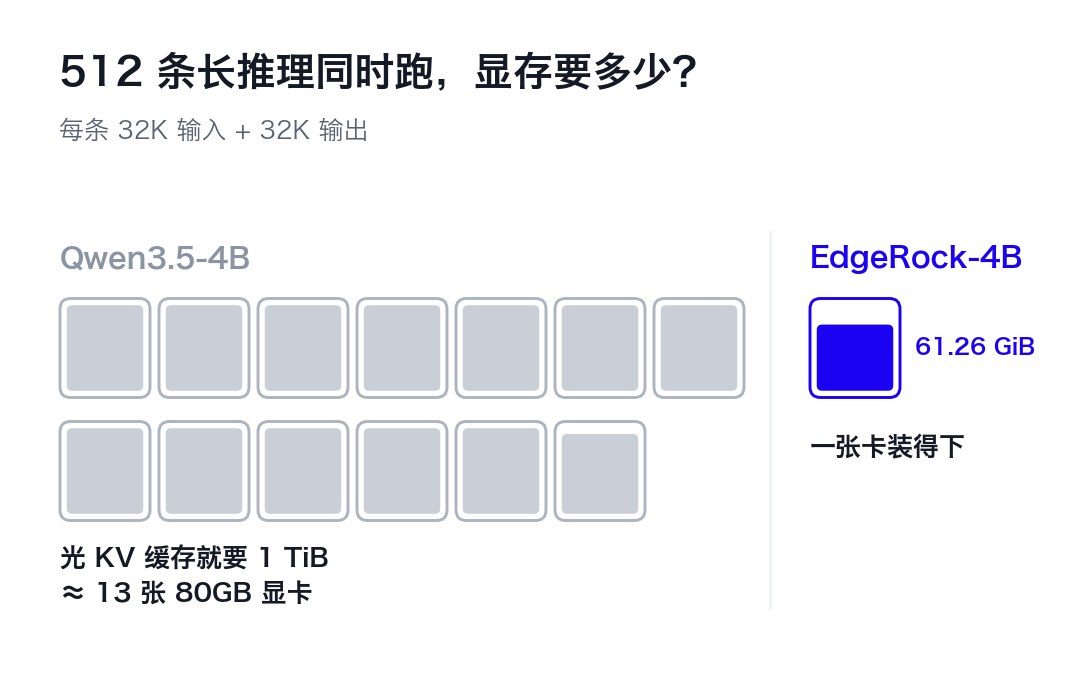
传统全注意力模型做容量规划,靠的是“猜”:按最长轨迹预留 KV,猜错了要么内存耗尽提前截断推理,要么为峰值买单。EdgeRock 把这笔账变成了减法——单条序列历史状态 97.76MiB,512 路并发全部负载中最大显存占用 61.26GiB,一张 80GB 卡装下;而同样工况下 Qwen3.5-4B 光 KV 缓存就要约 1TiB,相当于 13 张 80GB 卡。13 张卡对 1 张卡,这是架构层给硬件采购单省下的那行字。
对长程 Agent 负载尤其关键:编码、多轮工具调用、长文档处理,任务越推进、上下文越长,历史 KV 越膨胀,这正是当前自建推理服务里最大的变量成本。把变量固定住之后,一张卡的并发数由“能塞下多少条 256K”变成“80GB 除以 100MiB 余量”的简单除法,容量规划第一次可以写在采购单里而不是写在祈祷里。对端侧与机器人场景,片上存储在设计时就定死,恒定内存意味着推理可以与感知、控制共享同一块显存预算而互不挤兑,这是循环类模型喊了很久的卖点,这次在 4B 规模上给出了可用的推理分数。
两个边界要写进验收单
第一,能力天花板还是 4B 档:99.1% 是相对源模型的降幅,AIME 82.9% 放在小模型里是优秀,但与前沿模型比,这是“装得下、跑得快”,不是“更聪明”,选型时别把效率增益误读为能力升级。第二,RMA 不是免费午餐——白皮书的消融实验里,关闭锚点机制后 256 段长上下文的远距查询正确率从 94.1% 跌到 0.4%,说明长程推理确实重度依赖这套固定记忆结构,部署后若自行裁剪模块,长上下文质量会断崖。另外,12124 tokens/s 与 99.1% 均为厂商白皮书自报数字(单张 Hopper 80GB、BF16 口径),上生产前建议按真实负载复测一轮。
一句话观察:推理服务从“按上下文长度赌显存”走向“按请求数排容量”,架构把内存的确定性还给了运维——这是今年开源模型里对硬件选型最实用的一次改动。
来源:岩山科技官微(岩芯矩阵技术白皮书)、新浪财经、BAAI 智源 hub、港科大/CMU/岩芯矩阵联合报告(rockmatrix-ai/EdgeRock)。