
128GB 内存是入门票:Unsloth Dynamic V3.1 把 V4.1-Flash 量化进工作站本地
开源旗舰的社区量化,13 天就位
10 月 17 日,DeepSeek 发布 V4.1-Flash-1017:552B 主干 + 196B Engram 条件记忆,合计约 748B 参数,支持 100 万 token 上下文,定位编码与智能体任务。10 月 30 日,社区量化团队 Unsloth 放出首批 Dynamic V3.1 GGUF 量化版——这款开源旗舰的"本地运行票",到手了。
能力跃升:官方基准数字齐了
按 DeepSeek 官方模型卡:Terminal-Bench 4.0 从 31.2 升至 42.3,DeepSWE v1.1 从 74.2 升至 77.0,超过 Opus 5(74.0)与 GPT-5.6 Sol;HLE(无工具)从 36.8 升至 42.6,ProgramBench 从 20.3 升至 29.1。Artificial Analysis 智能指数得分 45,比上一代高 6 分,目前并列开放权重模型第二(与 AIBriefs 聚合数据交叉核验一致)。
内存档位账:128GB 是入门票
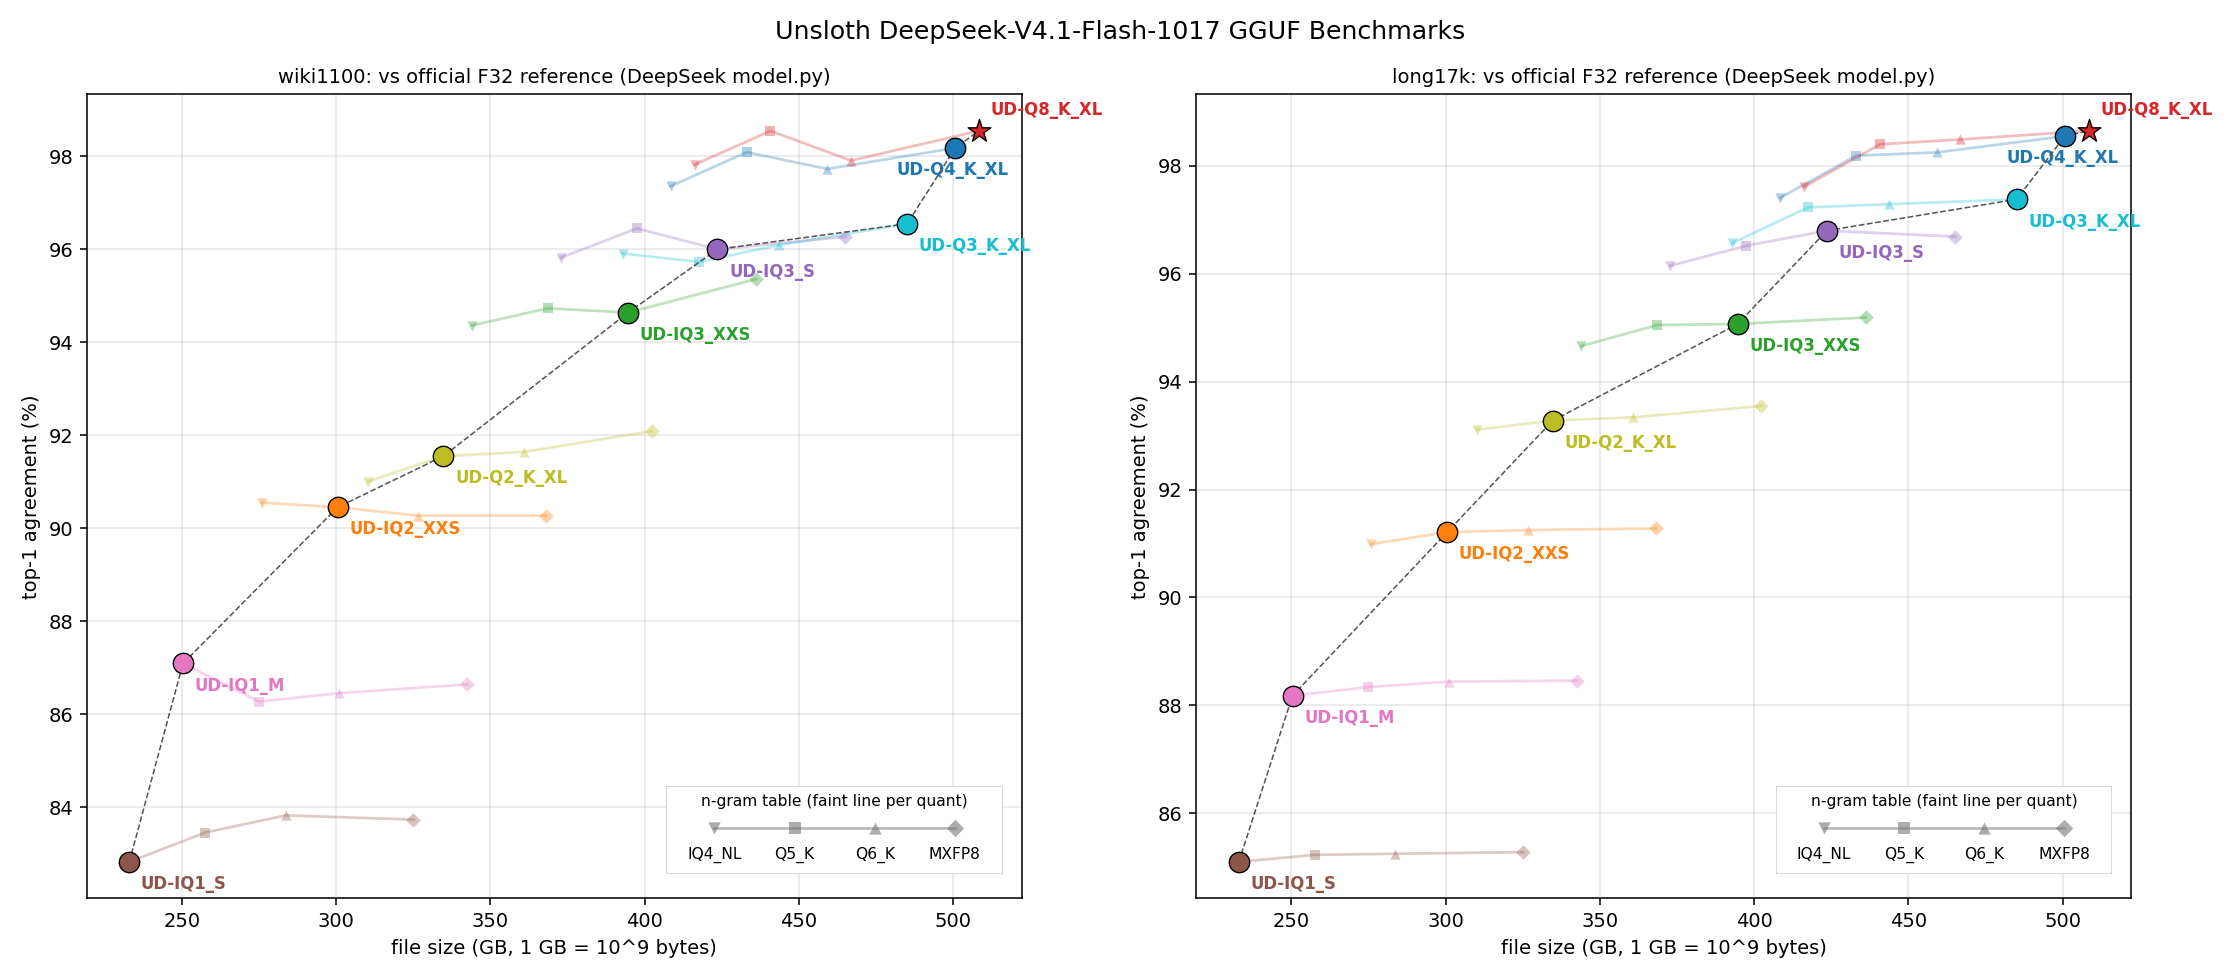
本地部署的核心问题是量化版占多少内存。Unsloth 官方硬件需求表给出完整档位:1 位 UD-IQ1_S 总包 233.0GB(含 110.6GB Engram 查找表),最低 122.4GB 内存,对应 MacBook / DGX Spark 这类 128GB 规格设备;3 位 UD-IQ3_XXS 需要 256GB 规格(Mac Studio 档);无损 UD-Q8_K_XL 为 508.4GB,面向多卡工作站。关键工程点是:110.6-202.8GB 的 Engram 查找表可以整体放 SSD,通过 mmap 按需加载进系统缓存,不占常驻显存——这正是把 748B 级参数模型塞进单机工作站的核心手段。
推理引擎侧,Unsloth 称其 llama.cpp 分支对比其它 CPU/VRAM/ngram 优化仓库推理速度约快 3 倍(厂商自报)。V4.1-Flash 还自带 DSpark 投机解码:主模型搭配 8GB-8.5GB 的小 drafter,解码端预计再提速 1.3-1.5 倍,代价是多一份 drafter 的内存。
运行参数与推理强度
DeepSeek 官方推荐采样参数 temperature=1.0、top-p=1.0,并关闭 top-k 与 min-p;长文本生成场景建议允许至少 256K 输出 token。推理强度参数 thinking_effort 默认 75("high"),可在 1-100 区间调节——数值越高模型推理越充分,但它不是 token 上限。本地跑终端智能体的团队,可以从中档 62 起步,按任务质量再调,避免默认拉满拖慢交互。
64GB 这个数字要留意
Unsloth 官方 X 帖宣称新版量化"64GB 以上内存即可运行"(厂商自报),但文档硬件需求表给出的1 位量化最低内存是 122.4GB,两个数字对不上。64GB 的说法可能对应更低精度档位或营销级表述,选型时建议以文档表格为准,并预留 5-10GB 运行时缓冲(上下文与缓存都会额外吃内存)。
社区量化生态:不止 Unsloth 一家
回看 1017 发布后的 13 天,量化生态相当热闹:10 月 21 日 Unsloth 的 Dynamic 量化版首批上架 Hugging Face;10 月 24 日 ISTA-DASLab 放出 GSQ-RCO 2 位量化,社区称其"得分与基座模型相当"(社区自测,未经官方核验);此外还有去除内容限制的 abliterated 变体。对私有化团队来说,多套量化并存意味着硬件选型可以按内存预算精细调档,不必只等官方单一精度——这也是开源权重模型对比 API 订阅的长期成本优势所在。
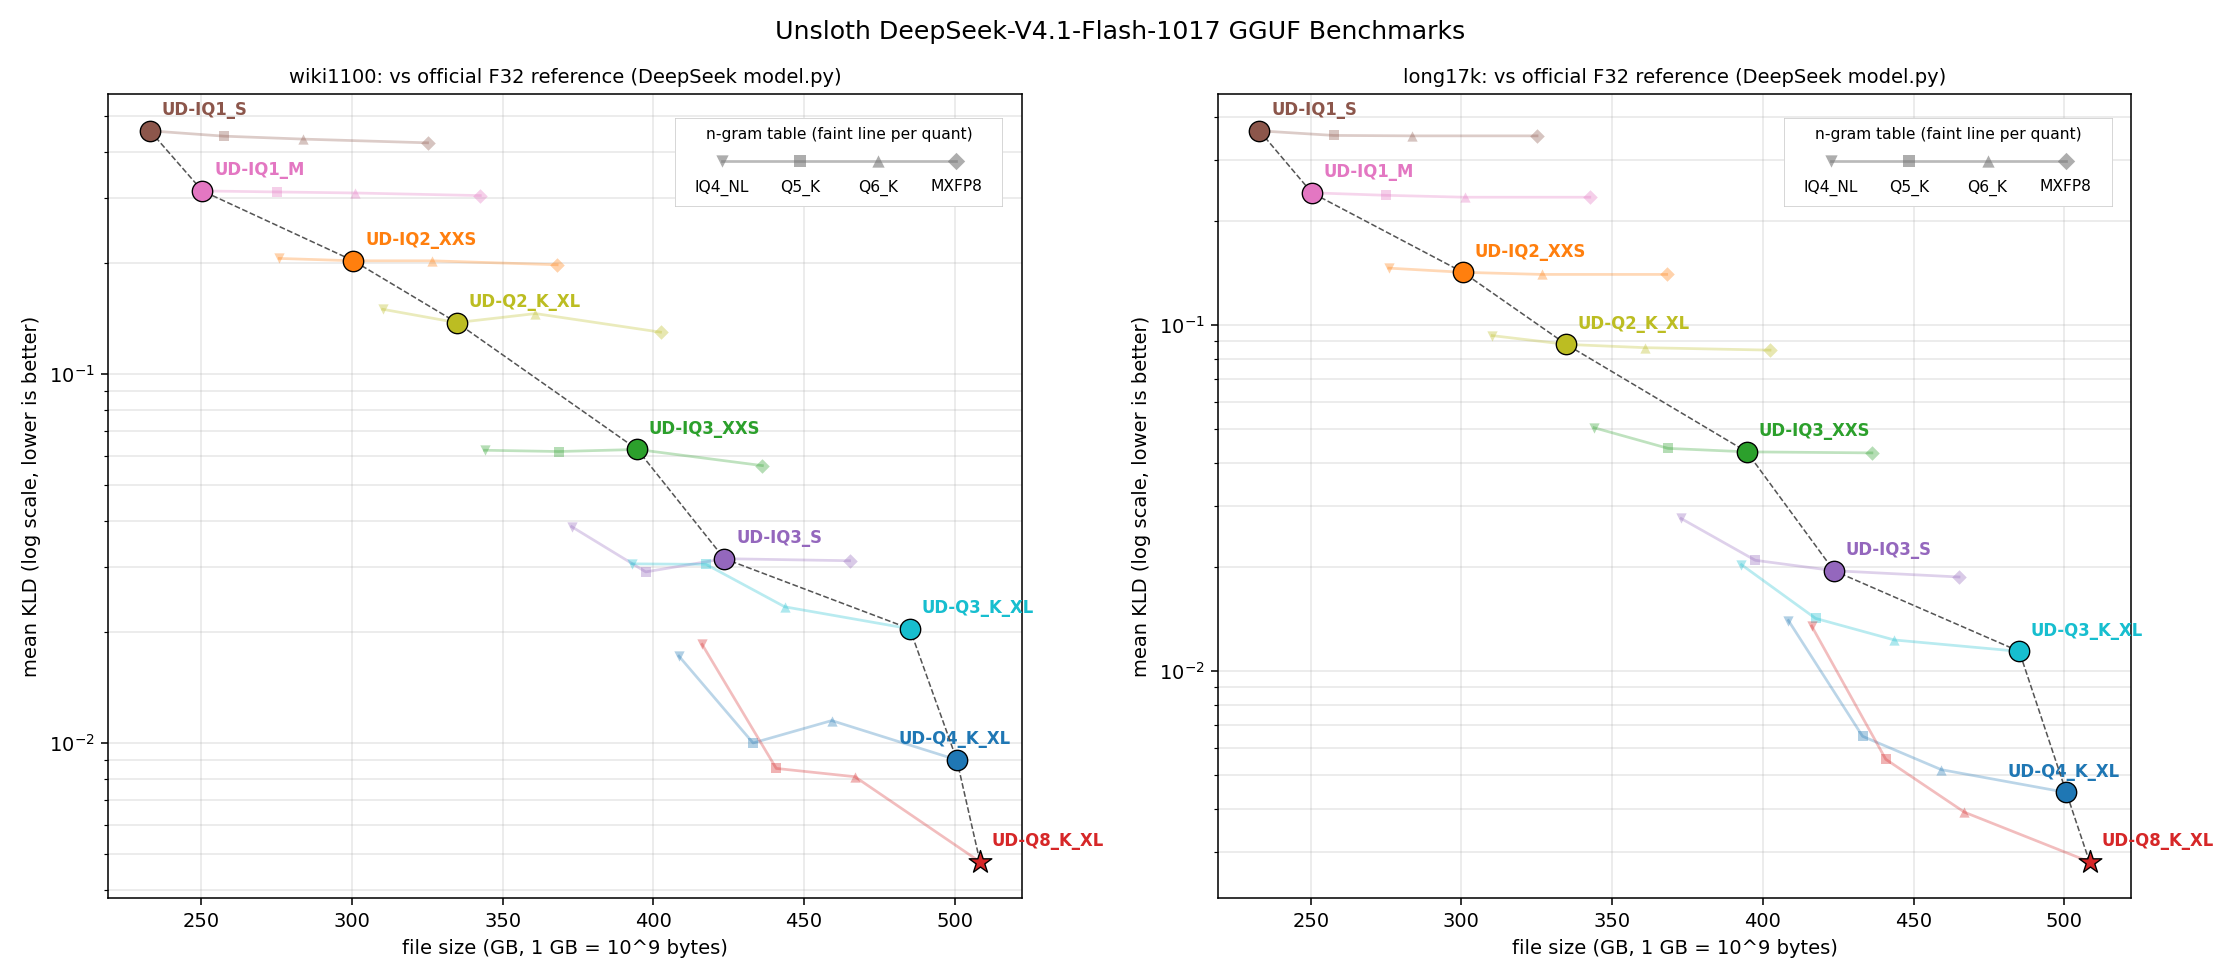
观察:1017 版的 Engram + DSpark 双架构,把本地部署的问题从"能不能跑"推进到"多少内存够跑"。128GB 统一内存现在就是 552B 级开源旗舰的入门票;还在 32GB 的机器上,可以等 2 位 / 256GB 档位再动手,或继续走 API 聚合;而已经握着 DGX Spark 或 128GB Mac 的团队,这套量化版值得直接进选型清单。
来源:DeepSeek 官方模型卡(Hugging Face)、Unsloth 文档与 X 帖子、Artificial Analysis 与 AIBriefs 聚合数据交叉核验;厂商自报数字文中已标注。