
T3 Code 开源架构本地多模型编排,实现私有化远程环境算力统一调度
开源黑马的架构演进
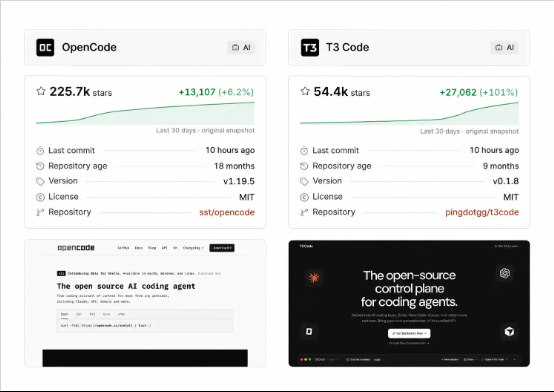
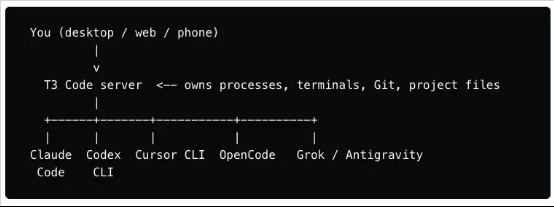
T3 Code 的 Orchestrator V2 正式进入稳定版,标志着其核心多模型与多 Harness 编排能力经过约半年打磨后趋于成熟。该项目从早期体验受限的开源替代品转型为拥有超过 70 万用户的成熟工具,在编程 Agent 领域展现出强劲竞争力。其核心定位始终深耕编程场景,通过兼容现有模型、Harness 和订阅体系,将 Codex、Claude、Cursor、Grok、OpenCode、Antigravity、Muse Code 和 Pi 等工具直接内置,并支持 ACP Registry 扩展接入。这种架构允许用户灵活组合本地资源,满足私有化部署需求。
远程算力调度的领先性
在远程环境管理层面,T3 Code 展现出显著的技术优势。用户可在单一远程环境中启动任务,并调度子 Agent 在另一已连接的远程环境中执行子任务。这一功能在头部模型厂商的桌面应用中尚属空白。其底层架构摒弃了传统的终端命令发送或 Electron 调用方式,转而通过自研 WebSocket 服务器建立连接,提升了通信效率与稳定性。对于依赖多 Agent 协作的工作流,如指定不同模型负责调研、实现与代码审查,该方案能提供最优的性能表现与资源调度。
轻量团队的技术突围
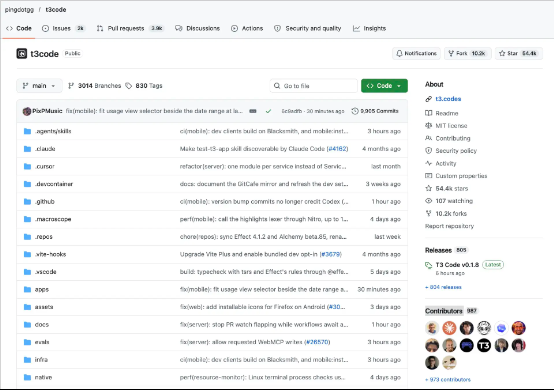
这款开源项目由三名兼职开发者主导,却成功应对了市值超万亿美元的大型科技公司竞争。项目目前在 GitHub 上拥有 5.44 万 Star、1.02 万 Fork,并汇聚了 987 位贡献者,采用 MIT 协议开放源码。值得注意的是,T3 Code 本身不通过销售 AI 服务盈利,用户需自行准备模型订阅。尽管运营开源项目成本高昂,其技术实现仍证明了轻量化团队在特定垂直领域实现高效算力管理与模型集成的可能性,为行业提供了一种低成本本地推理的参照。
模型能力评估新范式
创始人 Theo Browne 提出基于滑板动作物理特征描述的 Skatebench 测试标准,用于评估模型的三维推理与语法组合能力。测试数据显示,多数前沿模型得分在 82% 到 88% 之间,而 Gemini 3.1 Pro 达到了 95%。相比之下,Fable 等模型得分仅处于 70 多到 80 出头的区间。这种评估方法强调模型在实际任务中的理解深度,而非单纯的速度指标,为本地化模型选型提供了新的量化依据。用户可根据此类基准测试,结合本地算力条件,选择最适合推理需求的模型版本,从而优化整体硬件投入产出比。
私有部署与本地推理的价值
在 Agent 承担更多工作时,类型安全、测试、CI 及预览环境的重要性日益凸显。T3 Code 支持终端运行 WebSocket 服务,实现桌面端、网页及移动端远程连接,甚至允许跨设备操作线程。这种架构使得私有化部署更加灵活,企业可在内部网络中构建多模型协作环境,避免数据外泄风险。同时,通过统一接入不同厂商的模型接口,开发者能够在本地硬件上灵活切换算力资源,根据任务复杂度动态调整推理成本。这种对技术栈拥有权的强调,符合追求深度控制与效率优化的资深工程师需求,进一步强化了本地推理在专业开发场景中的不可替代性。
来源:InfoQ