
21000 GPU 时压成 3 小时:伯克利 SuperMimic 把全身控制训练拉进单卡档
1 张 H100、3 小时,压过 128 张卡跑 7 天
10 月 21 日,UC 伯克利 Koushil Sreenath 与 Pieter Abbeel 团队(CoRL 2026 口头报告)发布了 SuperMimic:用一个可微分世界模型训练人形机器人全身运动控制,单张 H100 跑 3 小时,收益就超过了基线 SONIC 公开检查点(128 张 NVIDIA L40 跑 168 小时、约 21000 GPU 时)。
差距大到需要看注脚:团队自己的对外口径是「GPU 时降 1000 倍以上、墙上时间快 50 倍以上」,而按 3 GPU 时对 21000 GPU 时实际算是约 7200 倍。团队同时承认,2.3 倍的数据量差(264.56 小时 BONES-SEED 公开子集 vs 611 小时全量)与最多 5.5 倍的张量核心峰值差都解释不了这个鸿沟——省算力是方法论贡献,不是硬件代差。
原理:世界模型与策略同环共训
SuperMimic 不对模拟器求导,而是先让标准刚体模拟器 MuJoCo Warp 跑一遍记录状态迁移,再用一个世界模型拟合这些迁移,把策略梯度解析地穿过世界模型。世界模型不是一次训完就冻结,而是每个迭代都和策略一起更新;想象式 rollout 比 MuJoCo Warp 直接跑快 10 倍以上,一阶梯度把所需想象步数压到 PPO 的约 1/64。想象窗口只有 32 步,靠 critic 把回报延伸到窗口之外——去掉 critic,16 步以内训练直接失败。从 1 小时到 264 小时动作数据,世界模型预测误差稳定在 0.007 到 0.011,GPU 时随目标收益增长很慢,这就是「算力不再是瓶颈」的来源。
动作库覆盖度:179 次失败到 0
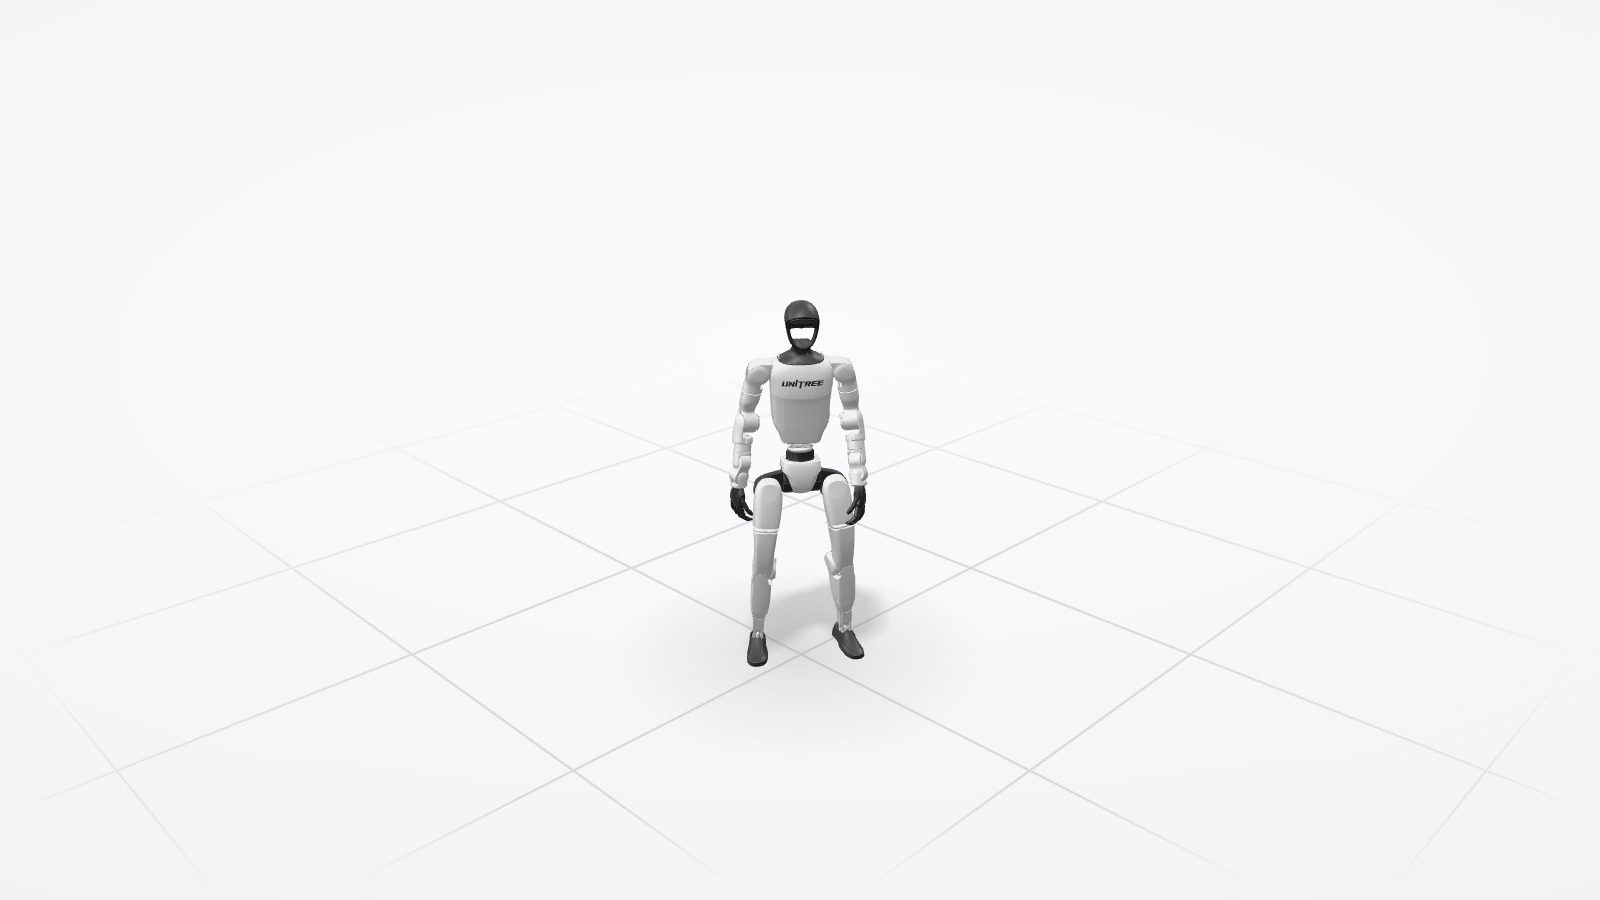
在 129,514 条基准动作上,SONIC 公开检查点失败 179 条——44 条翻腾、22 条侧滚全部失败;SuperMimic 单卡 3 小时剩 25 条,2 张 H100 跑 9.8 小时后为 0。同一套策略不做逐动作调参,直接上了实体 Unitree G1,官网还放了一个能在浏览器里跑的 demo。首作者是伯克利博士生 Liao,曾在波士顿动力实习,他主导的机器人学习框架 MoJoCo Playground 拿过 RSS 2025 最佳 Demo。
私有化视角:算力采购单该怎么改
对做机器人在研的团队,这组数字直接改写硬件预算。原来全身控制训练是「128 卡 × 7 天」的集群级任务,如今降到单卡 3 小时——迭代频率可以从一两个月一轮提到每天几轮,试错成本量级从五位数 GPU 时掉到个位数。野村在跟踪报告中把这篇列为「机器人身体控制训练正在变便宜的最有力证据」,并认为训练成本占机器人硬件成本约束正在松动。
选型上两个提醒:一是单卡档位也要选算力高一档的,H100 张量核心峰值是 L40 的 5.5 倍,这是 1000 倍差距里属于硬件的那部分;二是别把「1000 倍」直接写进对外材料,引用团队保守口径,并注明基线约 21000 GPU 时为论文自报。
观察一句:当训练门槛掉到一张卡,人形机器人研发的瓶颈就从算力预算转移到动作数据与真机验证环节——下一轮成本优化大概率朝这两个方向打。
来源:SuperMimic 项目官网(UC Berkeley,CoRL 2026 口头报告)、arXiv:2610.28480、42how 技术解读、野村报告转引;基线算力数据为论文自报。