
Ricursive 发布 Ripple-65B,本地低成本推理挑战巨头
低成本开放权重模型亮相
由前谷歌研究员创立的人工智能实验室 Ricursive Intelligence 于当地时间本月 4 日发布了名为 Ripple-65B Preview 的新模型。该模型被宣传为美国开放权重领域中智能体编程表现最佳的系统。Ricursive Intelligence 此前主要致力于 AI 驱动的芯片设计平台,此次发布的 Ripple-65B Preview 是其专用模型向通用场景延伸的变体,旨在通过开放权重降低企业获取先进 AI 能力的门槛。
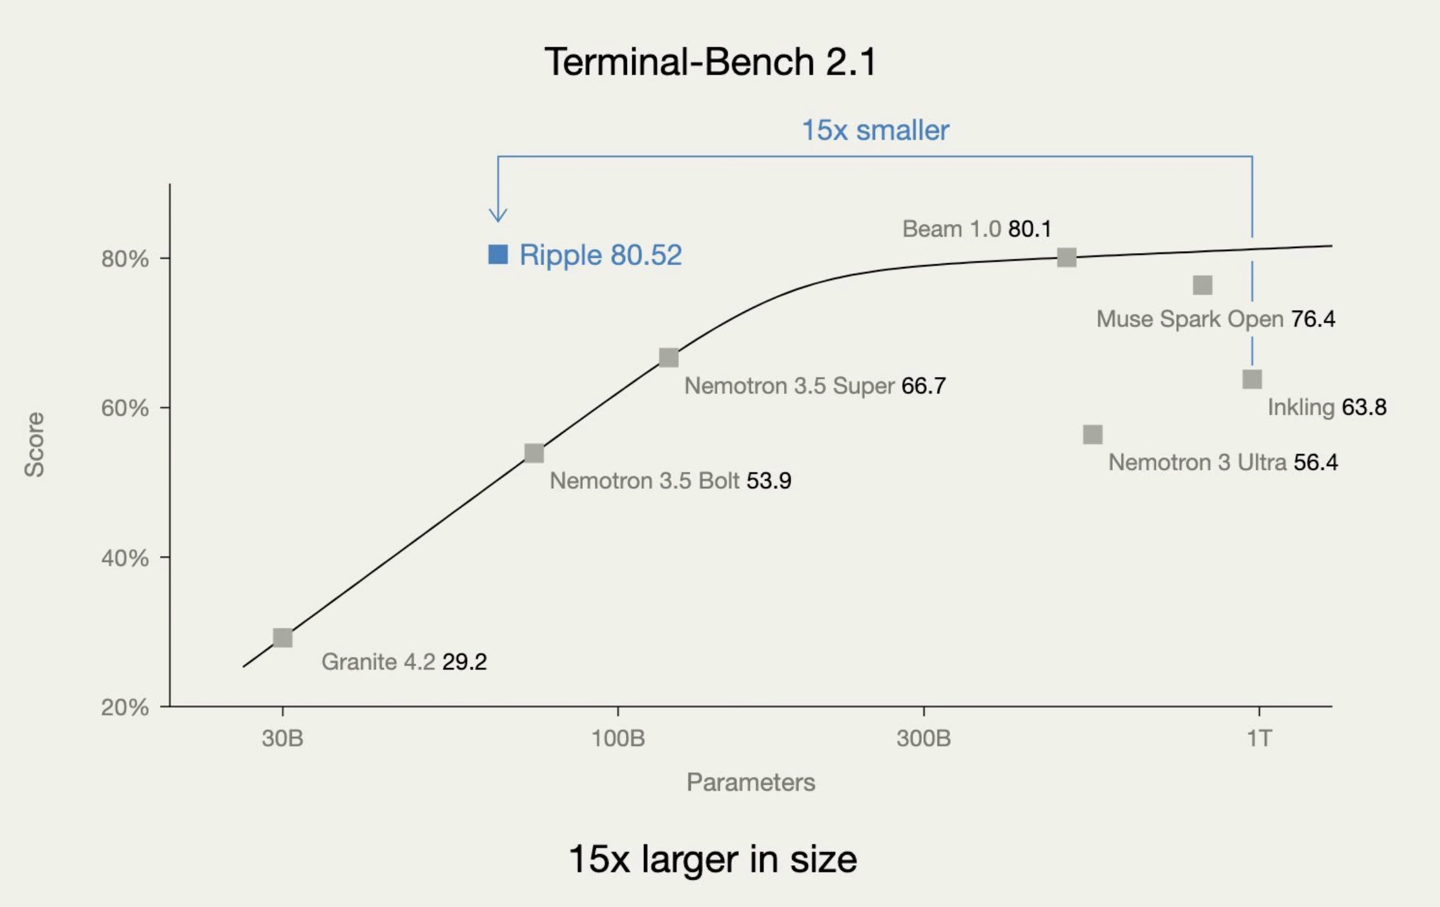
超越更大规模竞品
尽管 Ripple-65B Preview 参数量级不及竞争对手,但其在 TerminalBench 2.1 基准测试中展现了极强的竞争力。测试结果显示,该模型的表现优于 Meta Muse Spark Open 816B 以及 NVIDIA Nemotron 3 Ultra 550B 等规模显著更大的竞争者。这一结果暗示了模型效率与架构设计的优化在提升推理能力上的关键作用,对于追求高性价比推理方案的用户而言具有较高参考价值。
训练数据与架构细节
Ripple-65B Preview 是一款稠密模型,其预训练过程使用了 12T Token 的数据量。此外,该模型支持 1M 的上下文长度,这对于处理长文档、复杂代码库或长时间运行的智能体任务至关重要。支持超长上下文意味着在进行本地部署时,模型能够更完整地理解复杂指令和历史交互记录,从而提升智能体编程任务的连贯性和准确性。
开发成本与算力视角
Ricursive Intelligence 披露,从头开发和训练该模型的成本为 3,200 万美元。按照原文提供的汇率换算,这约合 2.14 亿元人民币。相较于万亿参数大模型动辄数亿美元的训练投入,这一成本结构展示了小参数、高效率模型在算力需求上的显著优势。对于考虑私有化部署的企业来说,较低的初始训练成本意味着更低的硬件摊销压力和更短的回报周期,使得在本地服务器集群中部署此类模型成为可能。
本地推理与部署前景
结合其开放权重属性和相对较低的训练成本,Ripple-65B Preview 有望在边缘计算设备和企业本地数据中心中快速落地。由于模型支持 1M 上下文,虽然对显存有一定要求,但相比 800B 级别模型,其硬件门槛大幅降低。基于原文数据,这种成本效益比使得该模型成为智能体编程场景下极具吸引力的本地推理选择,尤其适合对数据隐私有严格要求且算力预算有限的组织。
来源:IT之家