
155 条回复「串」进别人对话:GLM-5.3 KV 缓存事故,私有化部署验收单加 4 项自查
事件:155 条回复混进了「别人的对话」
10 月 26 日,Cloudflare 与开源推理引擎 SGLang 联合发布事故披露:今年 8 月 27 日至 9 月 9 日,GLM-5.3(Z.ai 开放权重模型,以 @cf/zai-org/glm-5.3 在 Workers AI 提供服务)向少数客户返回了含有「其他客户此前请求数据」的回复,累计 155 条受影响响应,全部来自超过 681,280 token 的超长提示词。Cloudflare 在宣布事故后 40 分钟内下线该模型,当天完成配置修复与引擎补丁后恢复服务,并称未发现蓄意利用的证据:受影响请求的时间与体量符合常规长上下文使用。
根因:配置失误与引擎缺陷「叠加」
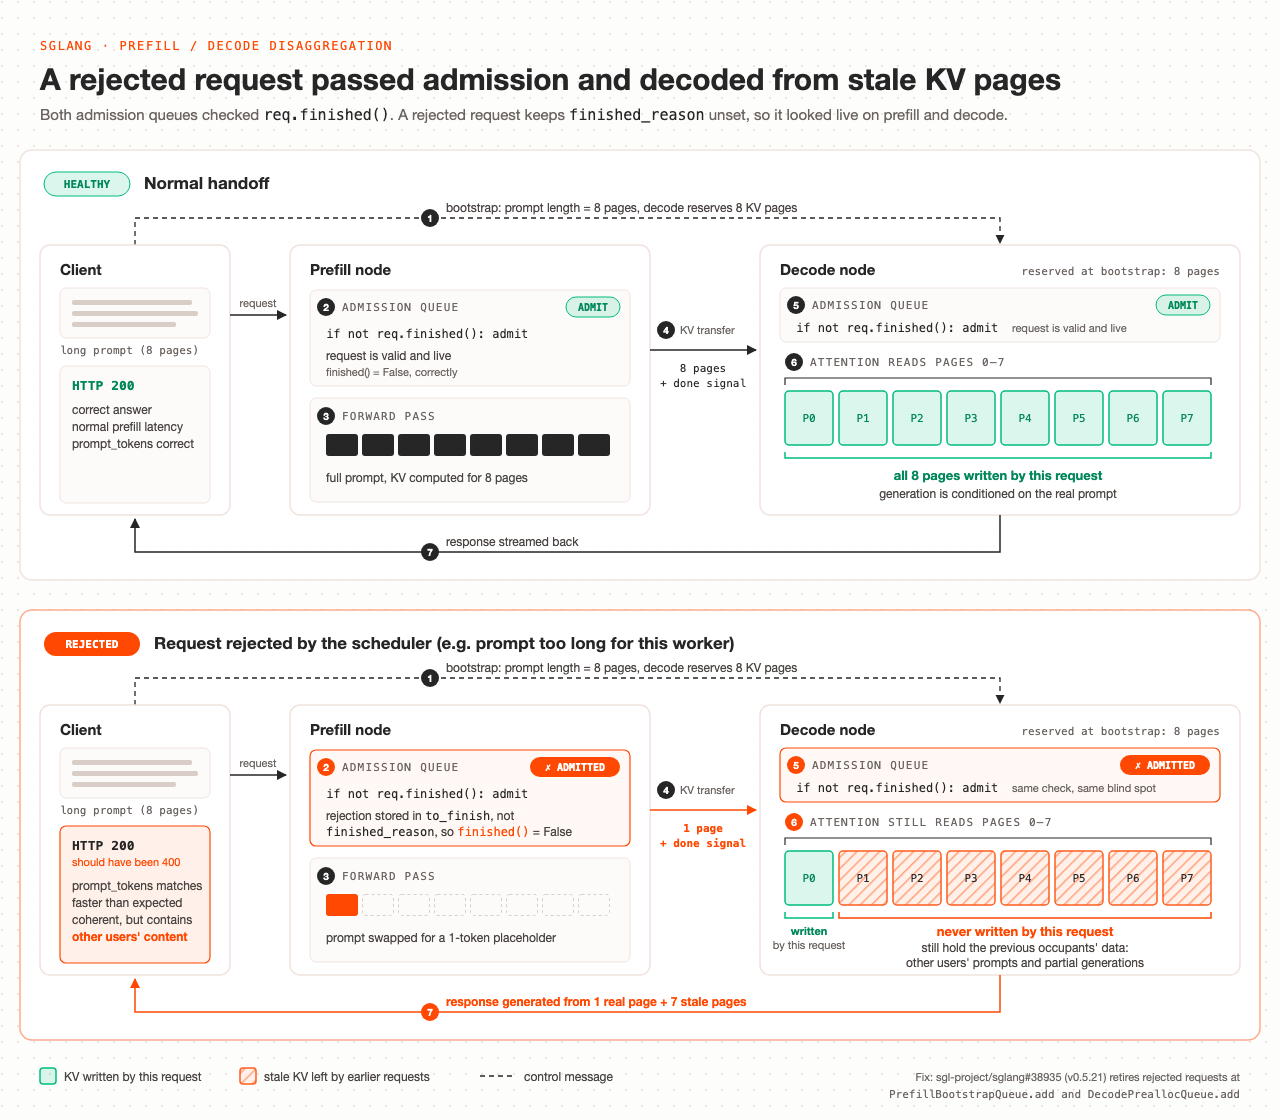
根因有两层。第一层是配置:GLM-5.3 以 1,048,576 token 的上下文窗口上线,但 prefill 侧 GPU 的 KV cache 池只能容纳 681,280 token。团队上线前知道这个错配,却默认引擎「放不下会报错」,长上下文测试只验证了 HTTP 状态码与性能,没有验证输出内容。第二层是 SGLang 缺陷:在分离式 prefill/decode 模式下,超出池容量的请求被内部标记「拒绝」并换成单 token 占位符,但两侧的准入队列只检查「请求是否结束」、不检查「是否被拒」,占位请求因此顺利通过交接;decode 端读取 8 个 KV 页时,P1 至 P7 仍是其他用户请求的残留数据。结果客户端收到的是 HTTP 200 而非 400,回复「连贯、快速、还夹着别人的内容」。修复后 prefill KV 池扩大到约 204 万 token(约为上下文窗口的 2 倍),合法请求从此不会触发拒绝路径。
给私有化部署:验收单加 4 项自查
如果你的自建 GPU 集群正用 SGLang 跑 GLM、DeepSeek 等开放权重模型,这份事故可以当「验收清单」读。SGLang 侧披露更直接:中止传输竞态存在于使用 Mooncake、NIXL 等 KV 传输后端的 PD 分离部署,影响范围自 2025 年初的 v0.4.x 系列直至 v0.5.21,单节点部署不受影响。自建侧建议把以下 4 项写进验收单:
1. KV 池对齐上下文窗口。池大小是启动时按权重加载后的剩余显存自动算出的,不是显式参数。每次调整量化、张量并行或 CUDA graph 尺寸后都要重新核对,把「KV 池 ≥ 上下文窗口」写进部署检查表。
2. SGLang 升到 v0.5.22 以上。10 月 19 日发布的该版本包含两处关键修复:在准入队列拦截被拒请求(#38935)、回收中止的 prefill 请求(#36988)。同一行为早在 7 月就以 SGLang issue #30233 被报告,是这次真实事故加速了修复落地。
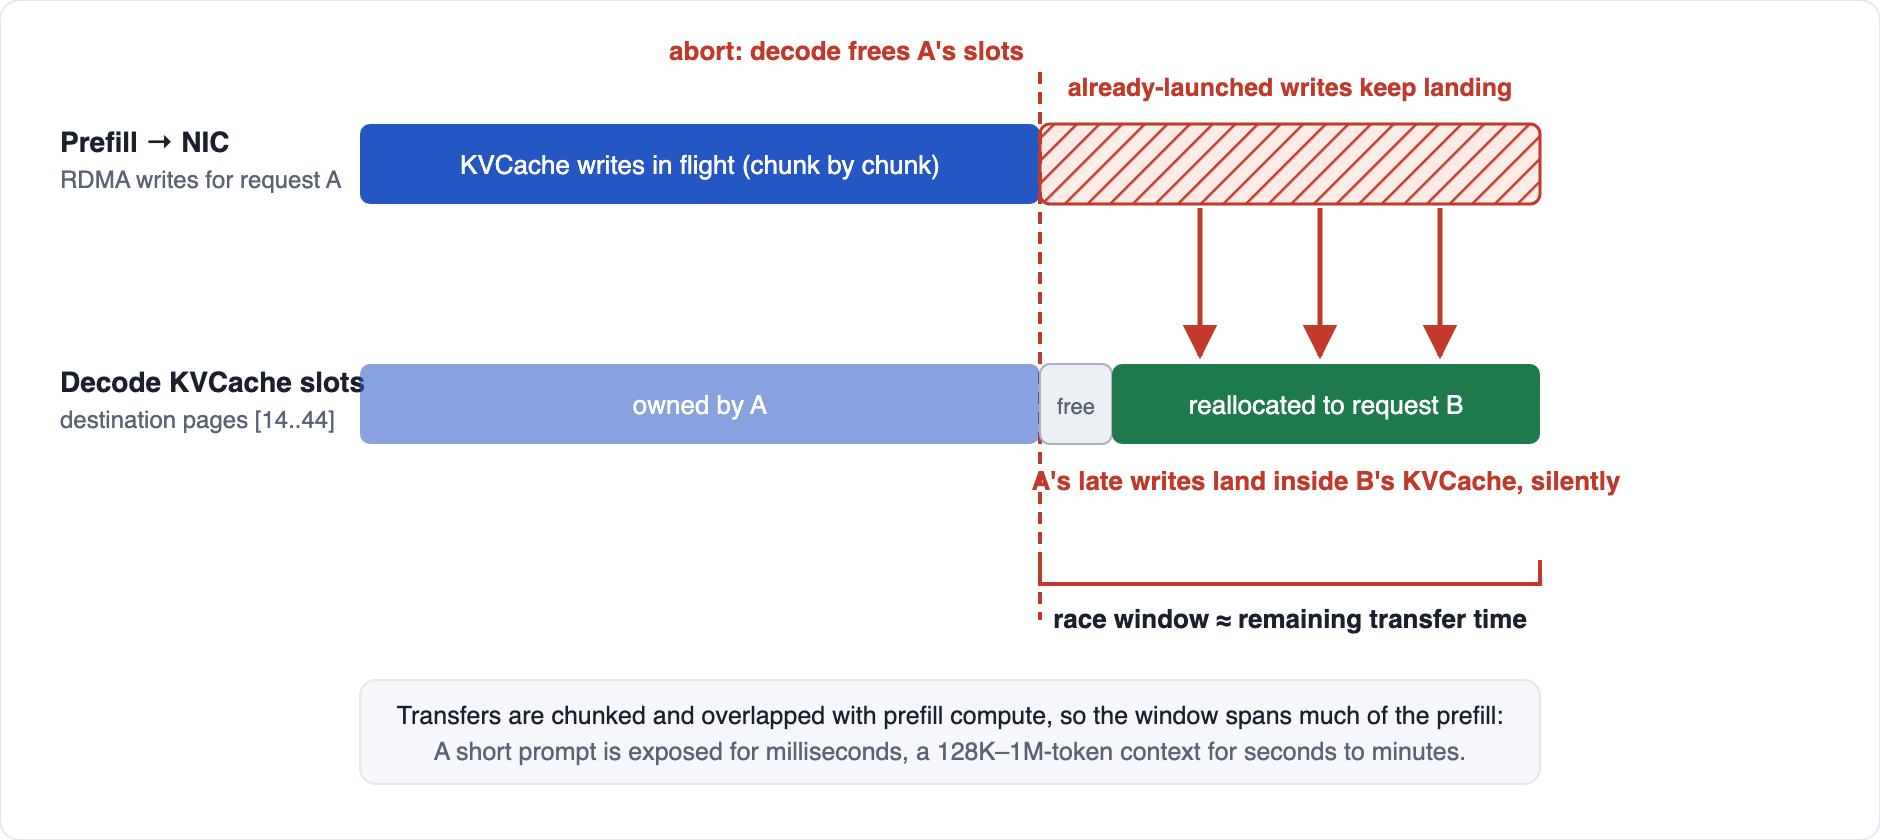
3. 延迟 KV 释放 + 限制 Mooncake 传输批次。RDMA 写入一旦发出无法撤回,若中止时立即释放页、交给下一个请求,迟到的写入就会落进别人的缓存。启用延迟释放机制,并为传输批次设上限。
4. 打开损坏检测。支持的环境启用 –disaggregation-enable-kv-checksum 与 –kv-canary,让绕过预防的损坏至少可被发现。
从成本与运维角度看,这类「静默串扰」比可用性故障更隐蔽:不报错、不破坏 SLO,只有抽查输出时才会发现里面混着别的租户的提示词片段。如果已自建多租户长上下文负载(agentic coding、文档问答等),建议把「输出完整性」列为新的 SLO 项,并在本次披露后 48 小时内完成一次全量自查。
观察:这件事改变的不是某家厂商,而是「行业默认动作」——KV 缓存隔离验收从此是任何做分离式推理私有化团队的必做项,也是 API 聚合平台选择推理服务商时的天然审计条款。
来源:Cloudflare 博客《Cross-request KV cache exposure in the GLM-5.3 Workers AI model》(2026-10-26)、SGLang 团队博客《SGLang security update: improving request isolation》(2026-10-26),另经 Unite.AI、DataStudios 等报道交叉核对。