
8GB 显存档跑 Agent「记忆写入」:腾讯开源 Hy-Memory 30B,组件化私有化的新车道
Agent 的「记忆写入」,被做成了独立组件
10 月 15 日,腾讯混元把 Hy-Memory 2.0 全套开源,Apache-2.0 许可:30B-A3B 记忆写入模型、双系统认知记忆框架、MemHub 客户端,三层都在包里。这个模型不是「通用聊天模型」,而是干一件很具体的事——在 Mem0、MemOS、EverMemOS 这类外部记忆框架里跑写路径,替通用 LLM 决定哪些信息该留、怎么表述、新证据来了怎么更新记忆库。官方技术报告是 arXiv:2610.22196,讲的就是归因强化学习怎么训练记忆写入。
对私有化系统来说,「组件化」意味着什么:记忆写入是 agent 栈里的高频后台任务,会话结束、工具调用、代码变更都可能触发一次。过去这一步要么塞给主推理模型兼职,要么走闭源旗舰 API——前者挤占主力算力,后者费用按量叠加、对话数据还出内网。现在它有了独立的开源小模型,自建栈里加一条低成本车道就行。
硬件选型:8GB 档就能跑
基座 30.06B 参数、BF16、激活约 3B(MoE,A3B)。显存账很好算:BF16 全精度权重约 60GB,两张 48GB 卡;官方同步开源的 FP8 版约 30GB,一张 48GB 卡装得下。关键是 GGUF 量化档位——按官方量化配方(imatrix 校准 + MoE 混合精度,路由专家压 IQ1_M、共享专家与注意力留 Q8_0),最小档文件只有 8.03GB,在 Mem0 的 LoCoMo 场景上只比 24.71GB 的 Q6_K 版低 1.53 个百分点(57.25% vs 58.78%)。也就是说记忆写入服务 8GB 档够用,24GB 卡还能和主模型共卡。
部署侧模型卡直接给了 vLLM v0.31.0 的样例,OpenAI 兼容 API、no-think 模式,接现有私有化推理栈不需要改接口。框架层 hy-memory 包默认用 SQLite、ChromaDB、Kuzu 等本地组件,pip 装完配两个端点(LLM + embedding)就能跑。
数字要盯住:四套记忆系统均分超闭源旗舰
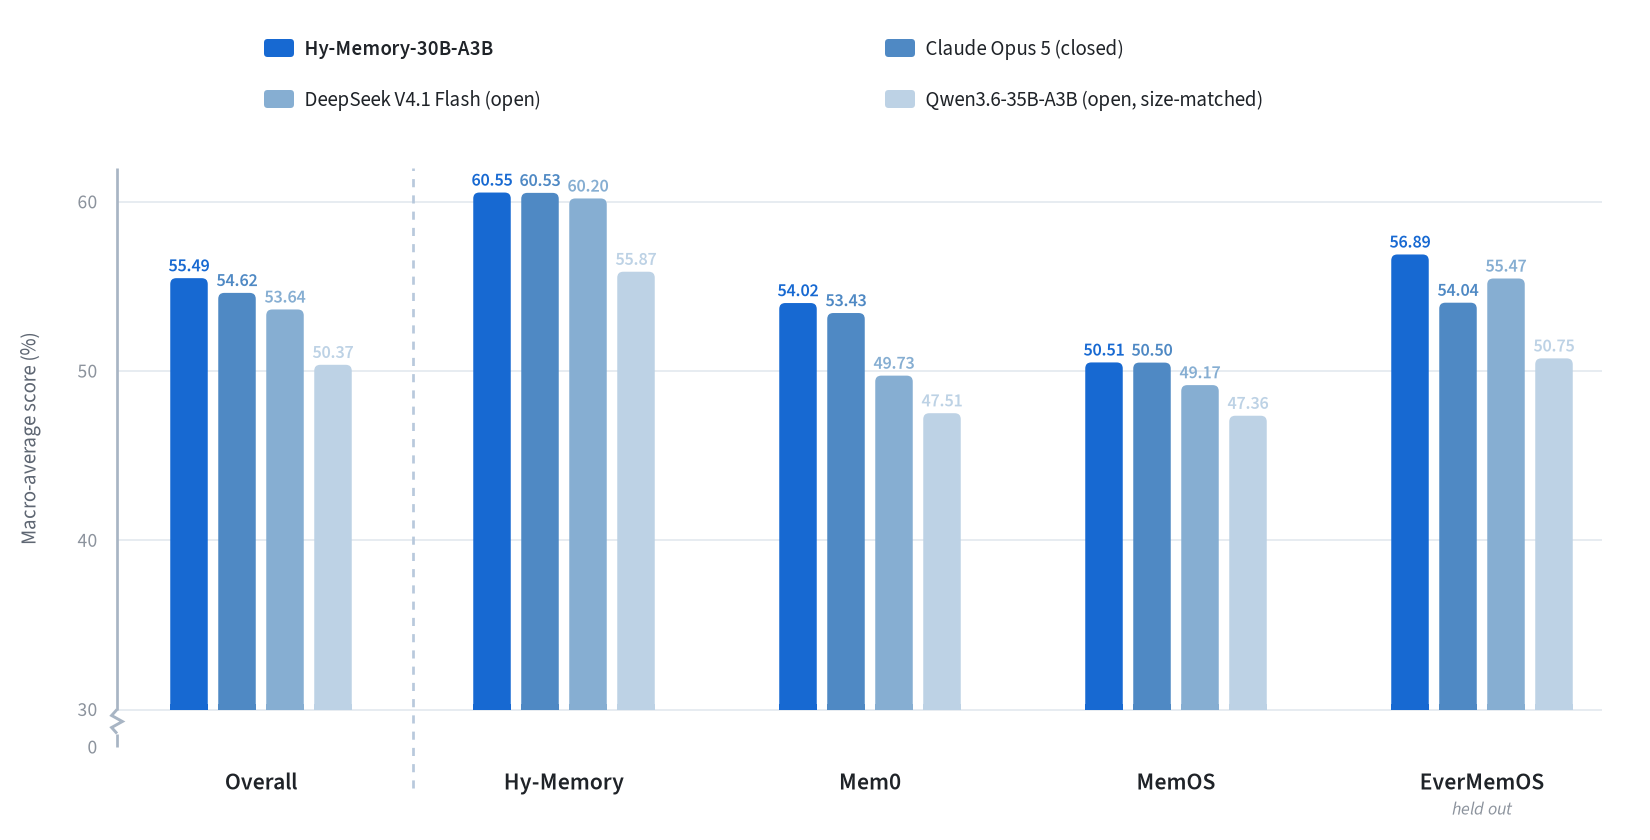
模型卡在 Mem0、Hy-Memory、MemOS、EverMemOS 四个框架的固定 20% 样本矩阵上,六指标均分 55.49,排在 Claude Opus 5(54.62)、DeepSeek V4.1 Flash(53.64)、Qwen3.6-35B-A3B(50.37)前面;相对自家底座 Hy3-A3B Base(47.66)提升 7.8 分。更值得注意的是留出的 EverMemOS——没参与训练,得分 56.89 仍是四项第一,说明能力不是只在自家框架里成立。上述均为厂商自报成绩,以模型卡与官方页面为准,第三方复现暂缺。
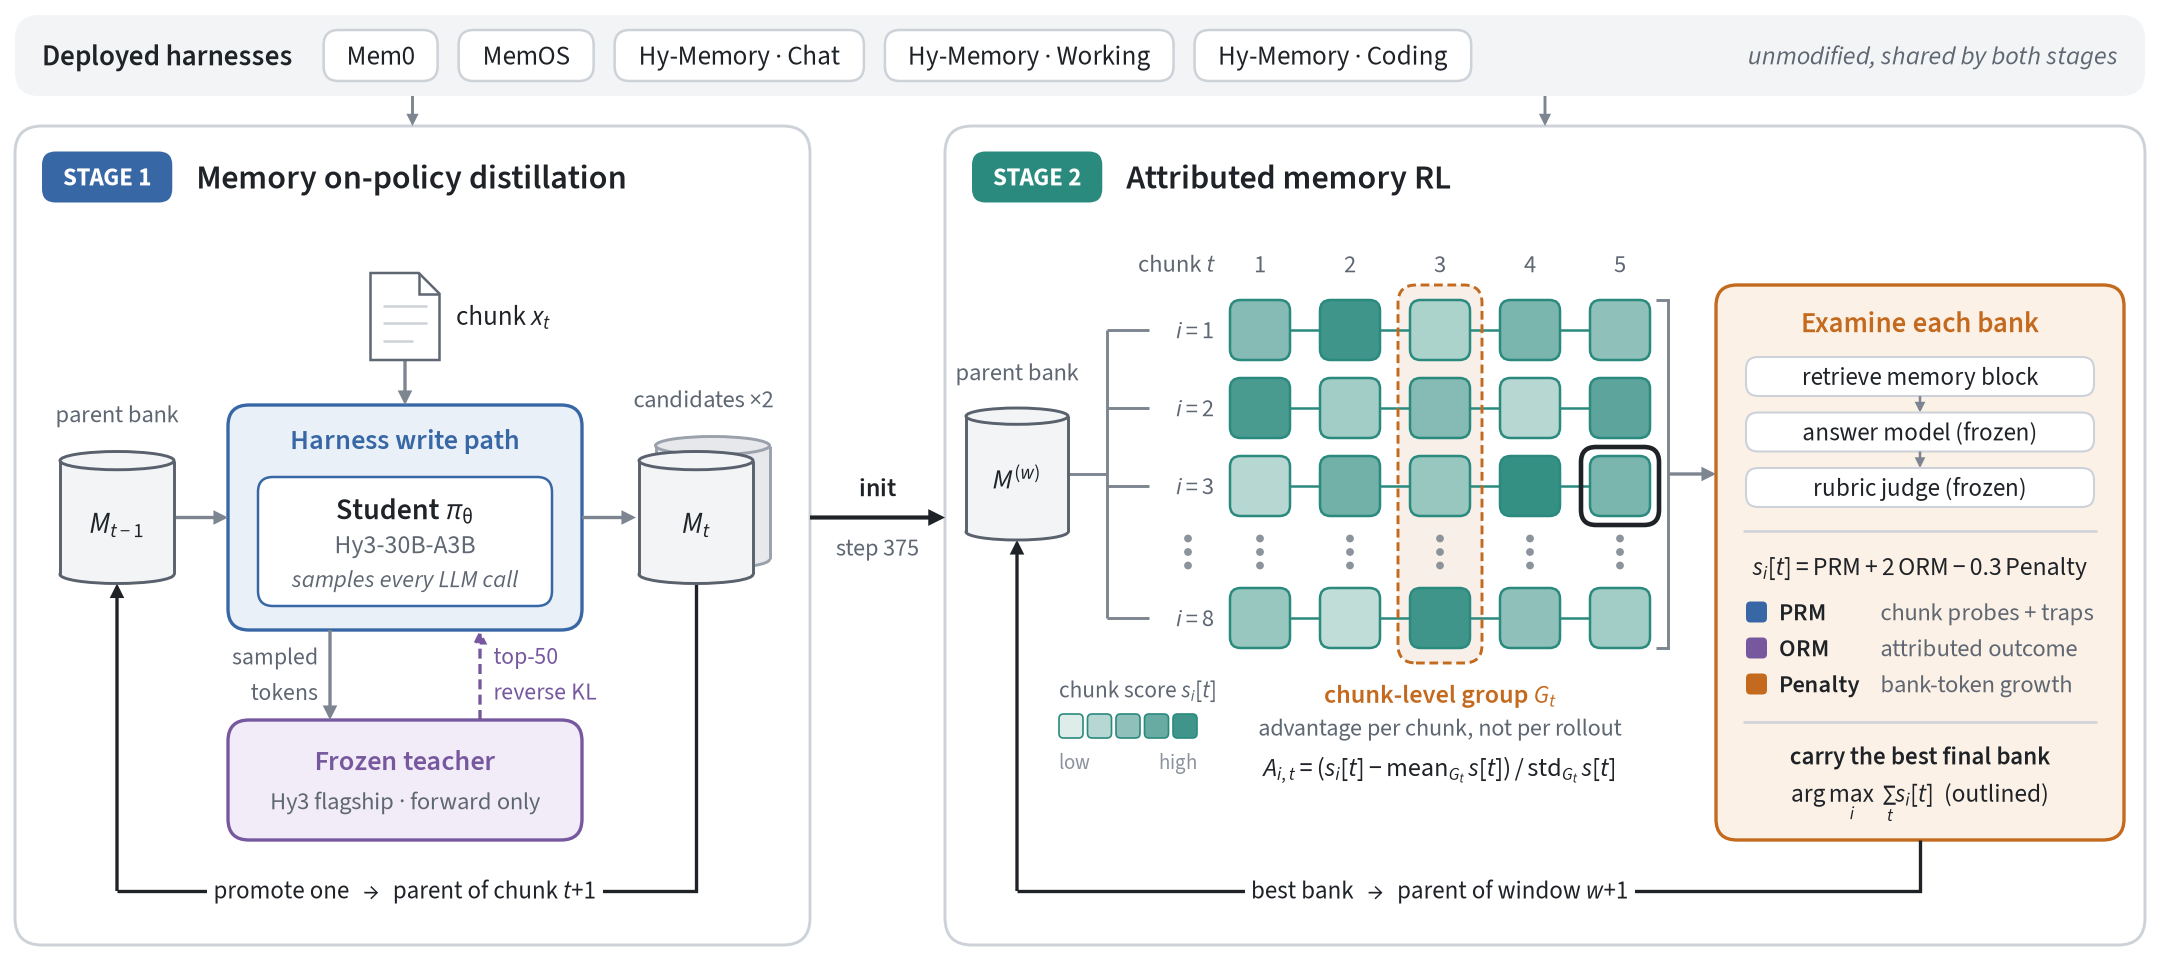
训练走两阶段:先记忆在线策略蒸馏(OPD)给稠密教师信号,再做归因强化学习——把信用分配到记忆库的 chunk 级,而不是整段对话。官方放出的训练流程图如下,每个格是一次 rollout 后记忆库的状态,深浅代表该 chunk 得分。
在途记录与验收三行
官方给的在途数据:腾讯证券 AI 助手换用 Hy-Memory 后,整体分 64.3 提到 79.6,多跳召回提升 40 个百分点;iWiki 场景里单靠记忆插件就比「全量原始历史」高 48.6%;腾讯新闻长期偏好理解平均 91.68/100。这些都是厂商侧数据,采购前建议拿自己的评测集复测。验收单建议补三行:量化档位复测——8GB 档 1.53 分差距是官方单跑结果,换业务场景要在自有 24-32GB 卡上重测;端点归属——框架的 LLM 与 embedding 端点可指向外部 API,私有化部署必须锁内网;基准归属——55.49 均分是厂商自报,签约前跑一轮独立基准。写路径组件本身成本很低,但它是 agent 长期记忆的底座,选型一次,受益的是所有上层任务。
来源:腾讯混元 Hy-Memory 官方发布页、Hugging Face 模型卡与 GGUF 仓库、技术报告 arXiv:2610.22196、GitHub Tencent-Hunyuan/Hy-Memory、鲸智社区 10-26 报道