
PwC 研究:Agent Grep 检索成本激增,知识编译成降本关键
检索范式面临成本瓶颈
随着企业将检索增强生成(RAG)纳入生产环境,传统的“查询-匹配-排序”流程暴露出结构性缺陷。高级 RAG 架构虽然引入了知识图谱和递归摘要,但复杂度并未带来对等的效果提升,反而增加了系统维护难度。这种“复杂度换不来效果”的现状,促使行业重新审视检索范式的底层逻辑,尤其是当算力成本成为制约大规模部署的关键因素时。
精确匹配的重估
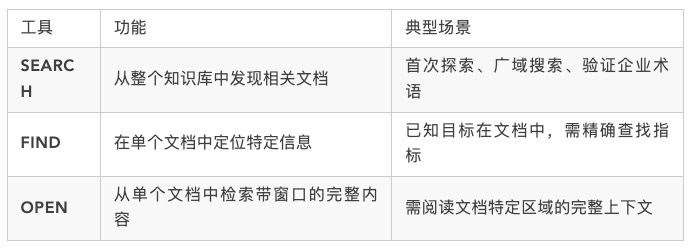
PwC US 的研究报告揭示了反直觉现象:在配备向量搜索和 Grep 的 Agent 实验中,精确字符串匹配(Grep)常常比语义搜索提供更高的准确率。这并非意味着语义理解失效,而是表明在证据定位场景下,如代码追踪或日期查询,直接匹配字面证据比模糊语义检索更高效。这种发现挑战了 RAG 必须依赖复杂语义引擎的传统假设,为降低推理成本提供了新视角。
Agent 交互模式的质变
OpenAI 对 GPT-5 在 BrowseComp-Plus 数据集上的分析指出,AI Agent 的使用行为与人类截然不同。数据显示,98% 的会话中使用引号搜索,且查询长度中位数超过人类用户的 99th 百分位。Agent 能构造带多个约束的复杂精确查询,这种结构化能力让 Grep 在 Agent Harness 中威力倍增。这种交互模式的质变,使得基于简单工具的编排框架在特定场景下优于重型向量数据库,从而在硬件算力层面实现了更轻量的资源占用。
冷启动与算力浪费
然而,Harness 加 Grep 的组合并非终点。当数据规模扩大,Agent 需反复探索以定位答案区域,导致迭代次数线性增长,Token 消耗指数上升。Pinecone 的估算指出,Agent 有 85% 的计算精力消耗在“重新发现”知识的循环上,而非真正的任务完成。这种缺乏状态积累和持续演进的“冷启动”问题,是范式层面的深层缺陷,直接推高了单位查询的推理成本。
知识编译的降本价值
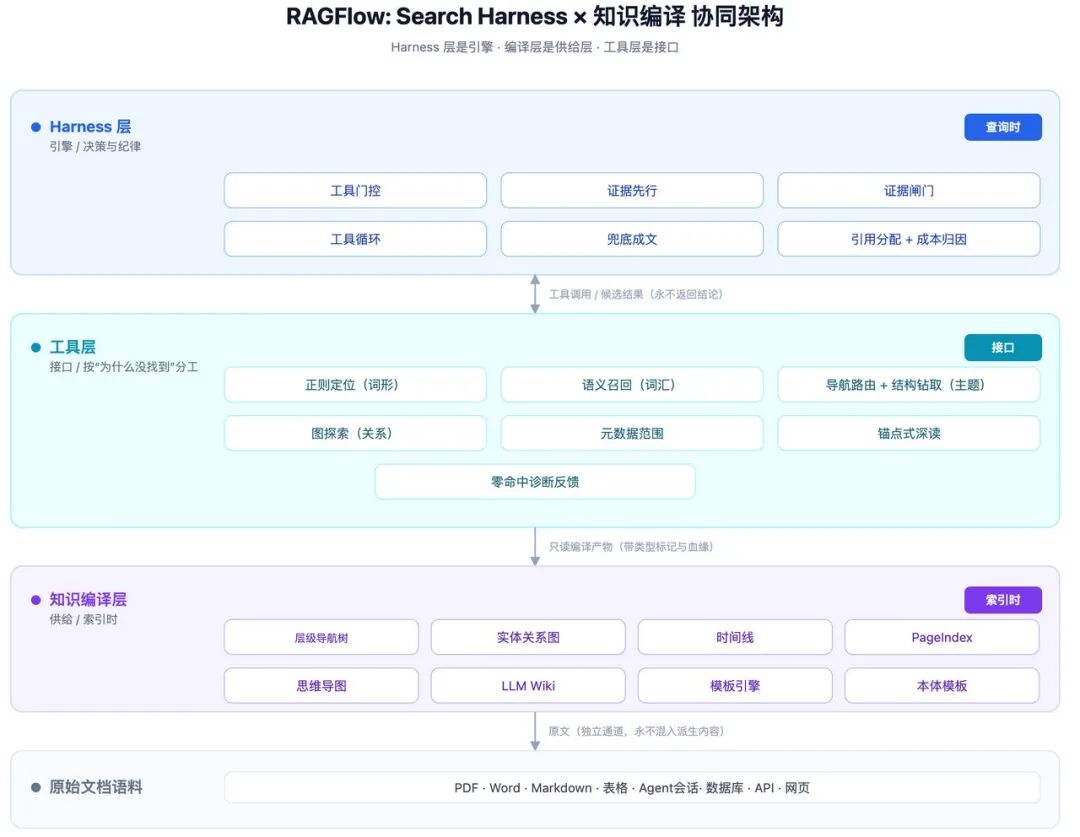
针对上述困境,Karpathy 提出的“LLM Wiki”概念主张将原始笔记编译为持续更新的 Wiki,而非每次查询时临时拼凑。核心主张在于将 Search Harness 作为引擎,知识编译作为上下文供给层。通过将部分理解工作从查询时移至索引时,系统能以更少的迭代次数和更低的 Token 消耗精准定位答案。这种机制不仅提升了检索质量,更通过减少无效计算,显著优化了私有化部署场景下的算力效率与硬件利用率,为大规模本地推理提供了可持续的成本控制路径。
来源:InfoQ