
35B MoE 装进 3GB 内存:MiniCPM-V 4.7 的端侧部署生态与硬件选型拆解
35B 参数、3GB 内存,为什么手机能真的跑起来
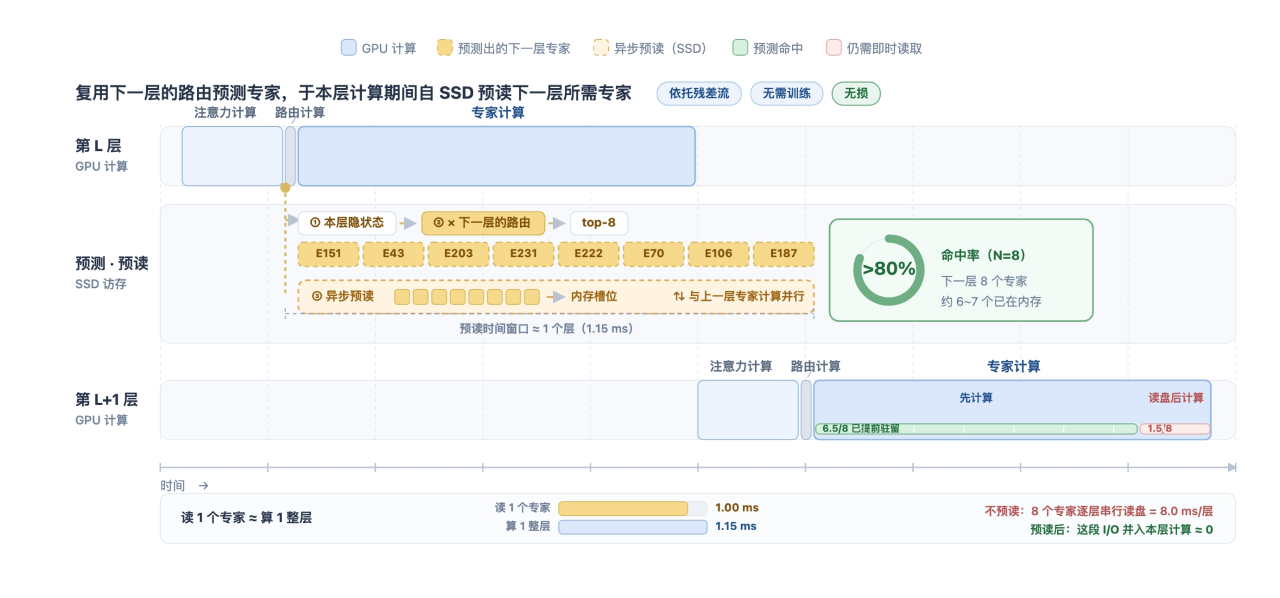
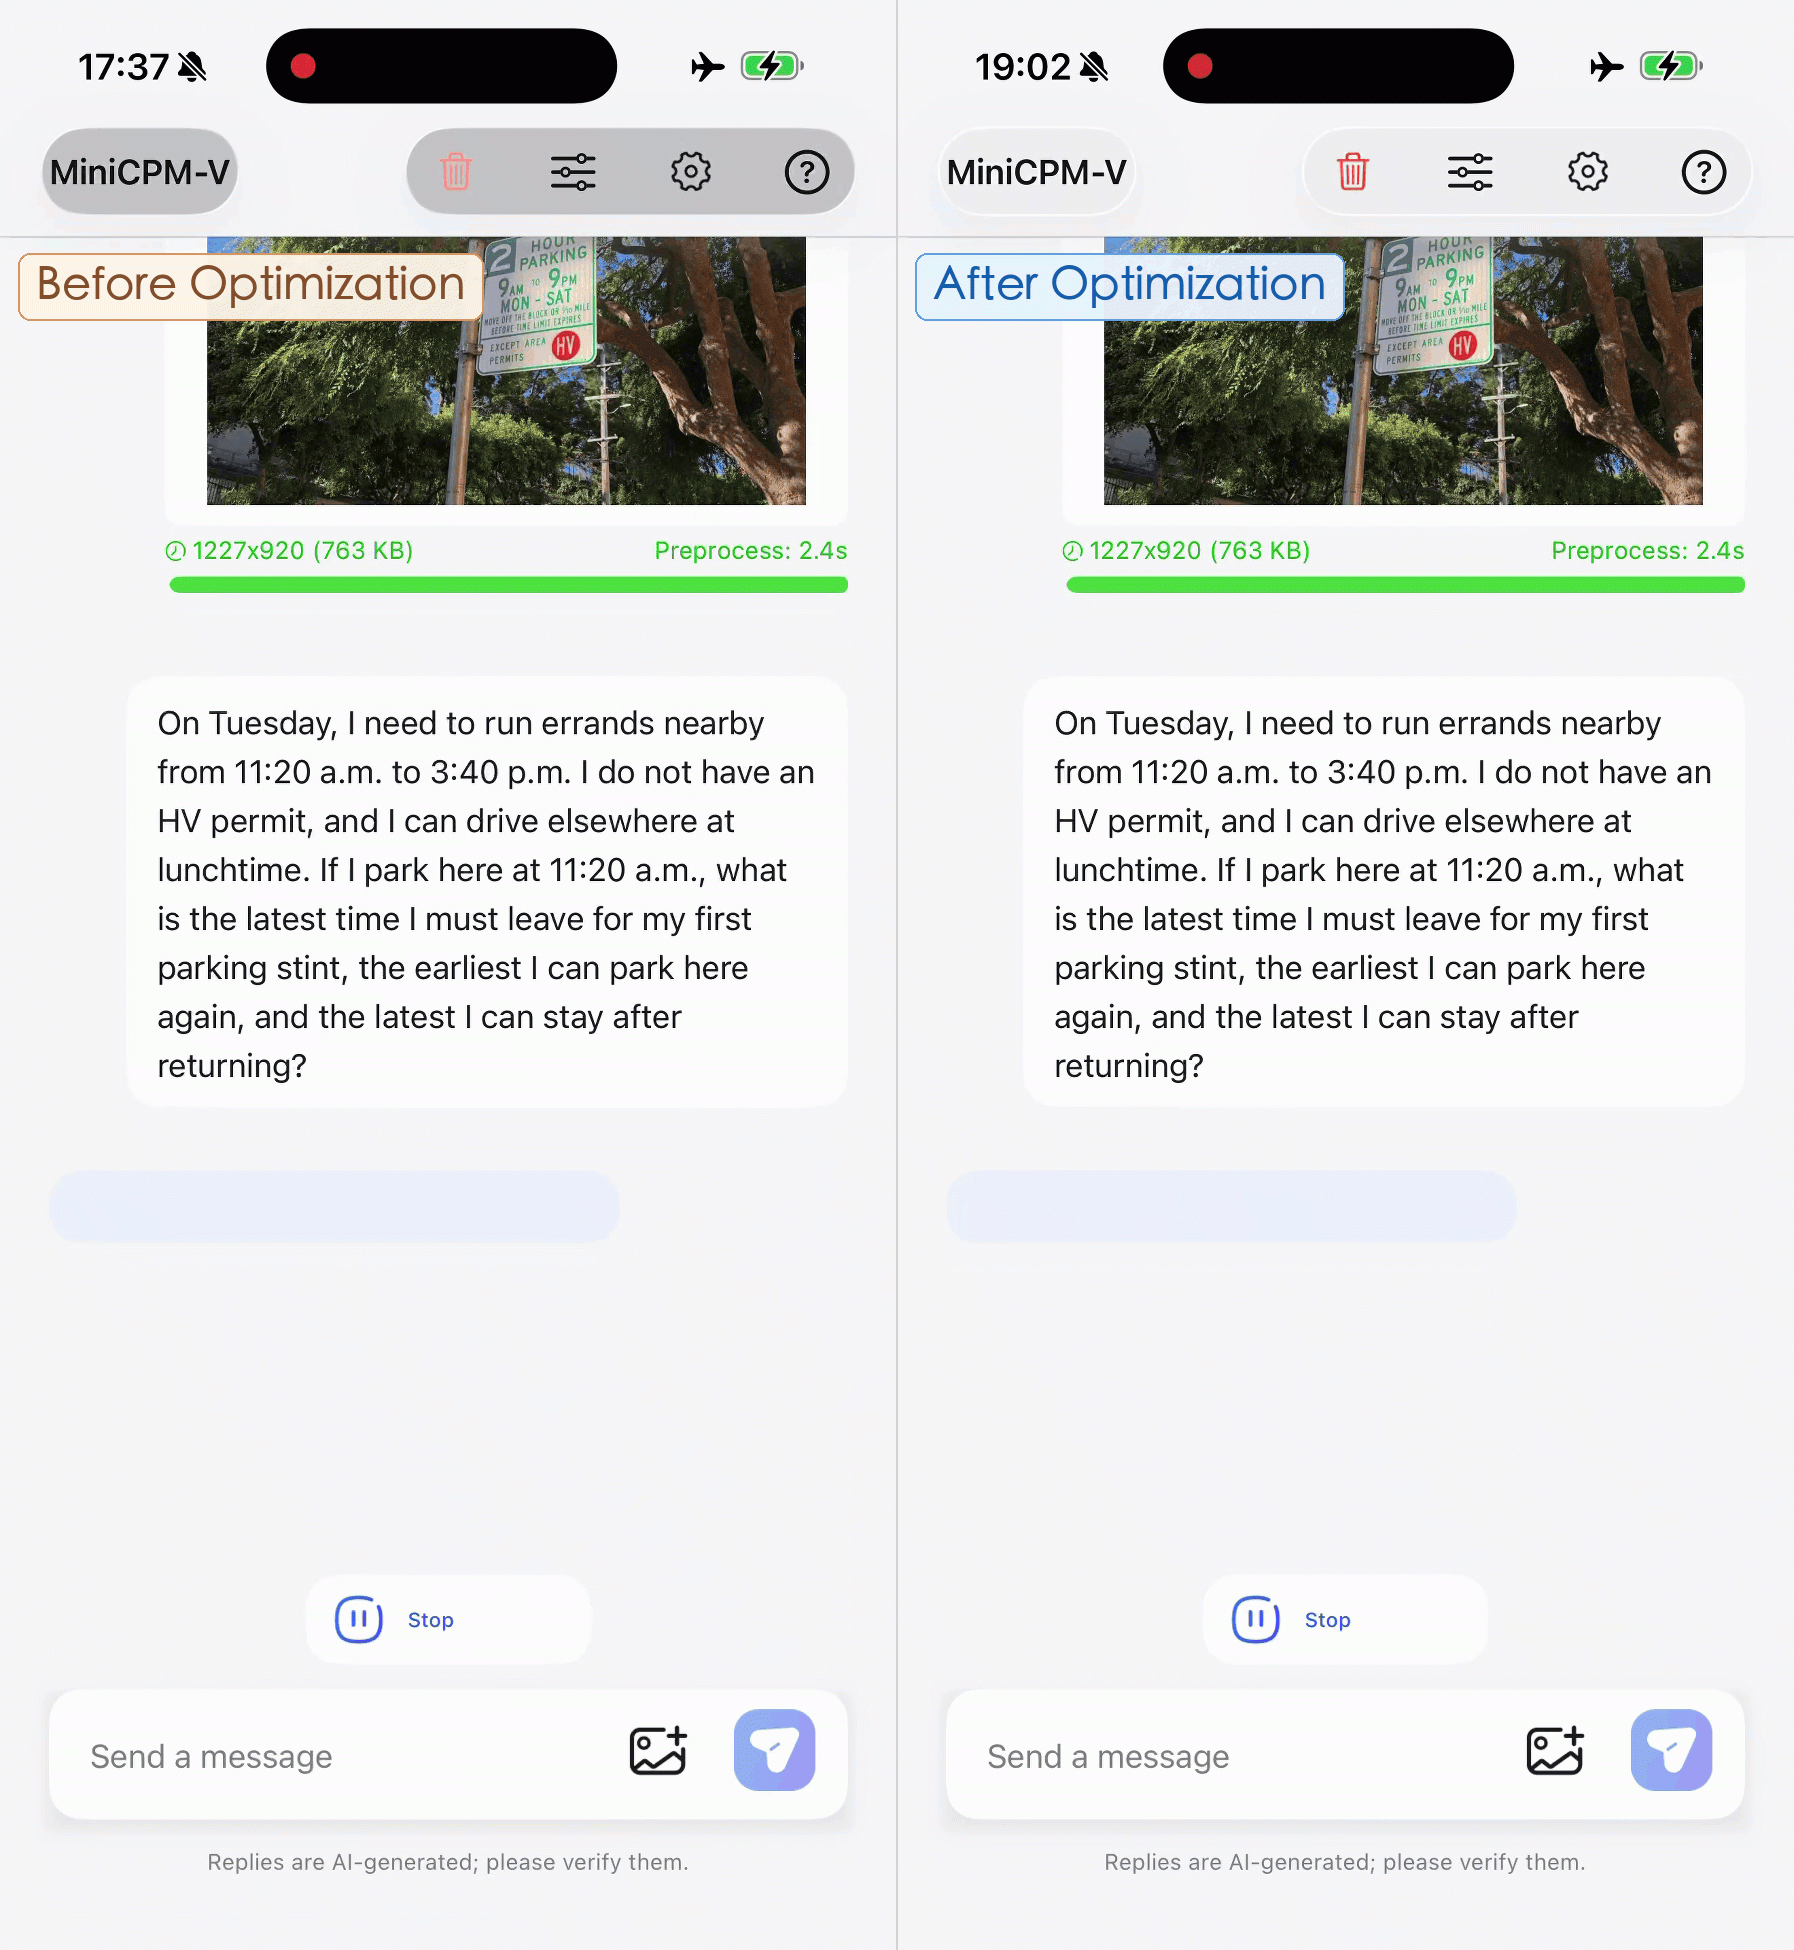
10 月 12 日,OpenBMB(面壁智能)开源了 MiniCPM-V 4.7 系列,Apache-2.0 许可,一次放出 35B-A3B 与 1B 两个版本。35B-A3B 是这条视觉线的首个 MoE 模型,完整 BF16 权重大约 65.6GiB,超过主流 16GB 手机全部内存的 4 倍。端侧跑通的钥匙是前瞻专家调度 LES:大部分专家权重放在固态硬盘里,计算当前层的同时,后台线程已经把下一层要用的专家从闪存搬进内存,读盘等待被压进计算过程里,输出与关闭 LES 时完全一致,提速不牺牲精度。OpenBMB GitHub 口径:iPhone 17 Pro Max 上约 3GB 内存、解码 13+ token/s;媒体引用的官方测试口径是 iPad Pro M4 16GB 17+ token/s、iPhone 18 Pro Max 20+ token/s(以上速度均为厂商自报)。
硬件选型视角:Day-0 适配的价值是"不用自己修"
OpenBMB GitHub 写明,MiniCPM-V 4.7 官方支持 iOS、Android、HarmonyOS,芯片平台覆盖 Intel、AMD、Arm、瑞芯微、后摩五家。面壁官方发布材料进一步称 NVIDIA、Apple 亦完成 Day-0 级适配,并通过 FlagOS 路径完成海光、沐曦、摩尔线程、昆仑芯、华为、天数智芯、平头哥、曦望、清微等多款国产 AI 芯片与端侧芯片的 Day-0 适配(国产芯片清单来自官方发布材料,具体交付状态以厂商公告为准)。对企业私有化部署而言,这意味着引入一个多模态模型基本不用再等上游框架适配:硬件采购和接入可以并行推进,部署周期从"周级修补丁"压缩到"天级上线"。
量化档位与框架矩阵,对应的成本逻辑
权重矩阵较全:35B-A3B 提供 BF16、FP8、int4、AWQ、GPTQ、GGUF 六种形态,1B 与 35B 还各带 DSpark 投机解码头(BF16 与 GGUF)。软件侧支持 llama.cpp、Ollama、MLX、vLLM、SGLang,官方微调代码(SRFT 自回放微调)同步开源。落地分档可以这么看:16GB 消费级显卡走 INT4(AWQ/GPTQ)承接纯文本与轻视觉流量;24GB 及以上留 FP8 甚至 BF16 余量;多模态输入占比高(图片、长视频)时建议直接 24GB 档起步,因为图像与视频激活值会明显抬升显存占用。1B 版本主打低功耗终端——摄像头、车机、工业网关这类场景,面壁称其综合得分与推理效率均领先 Qwen3.5-0.8B(厂商自报)。
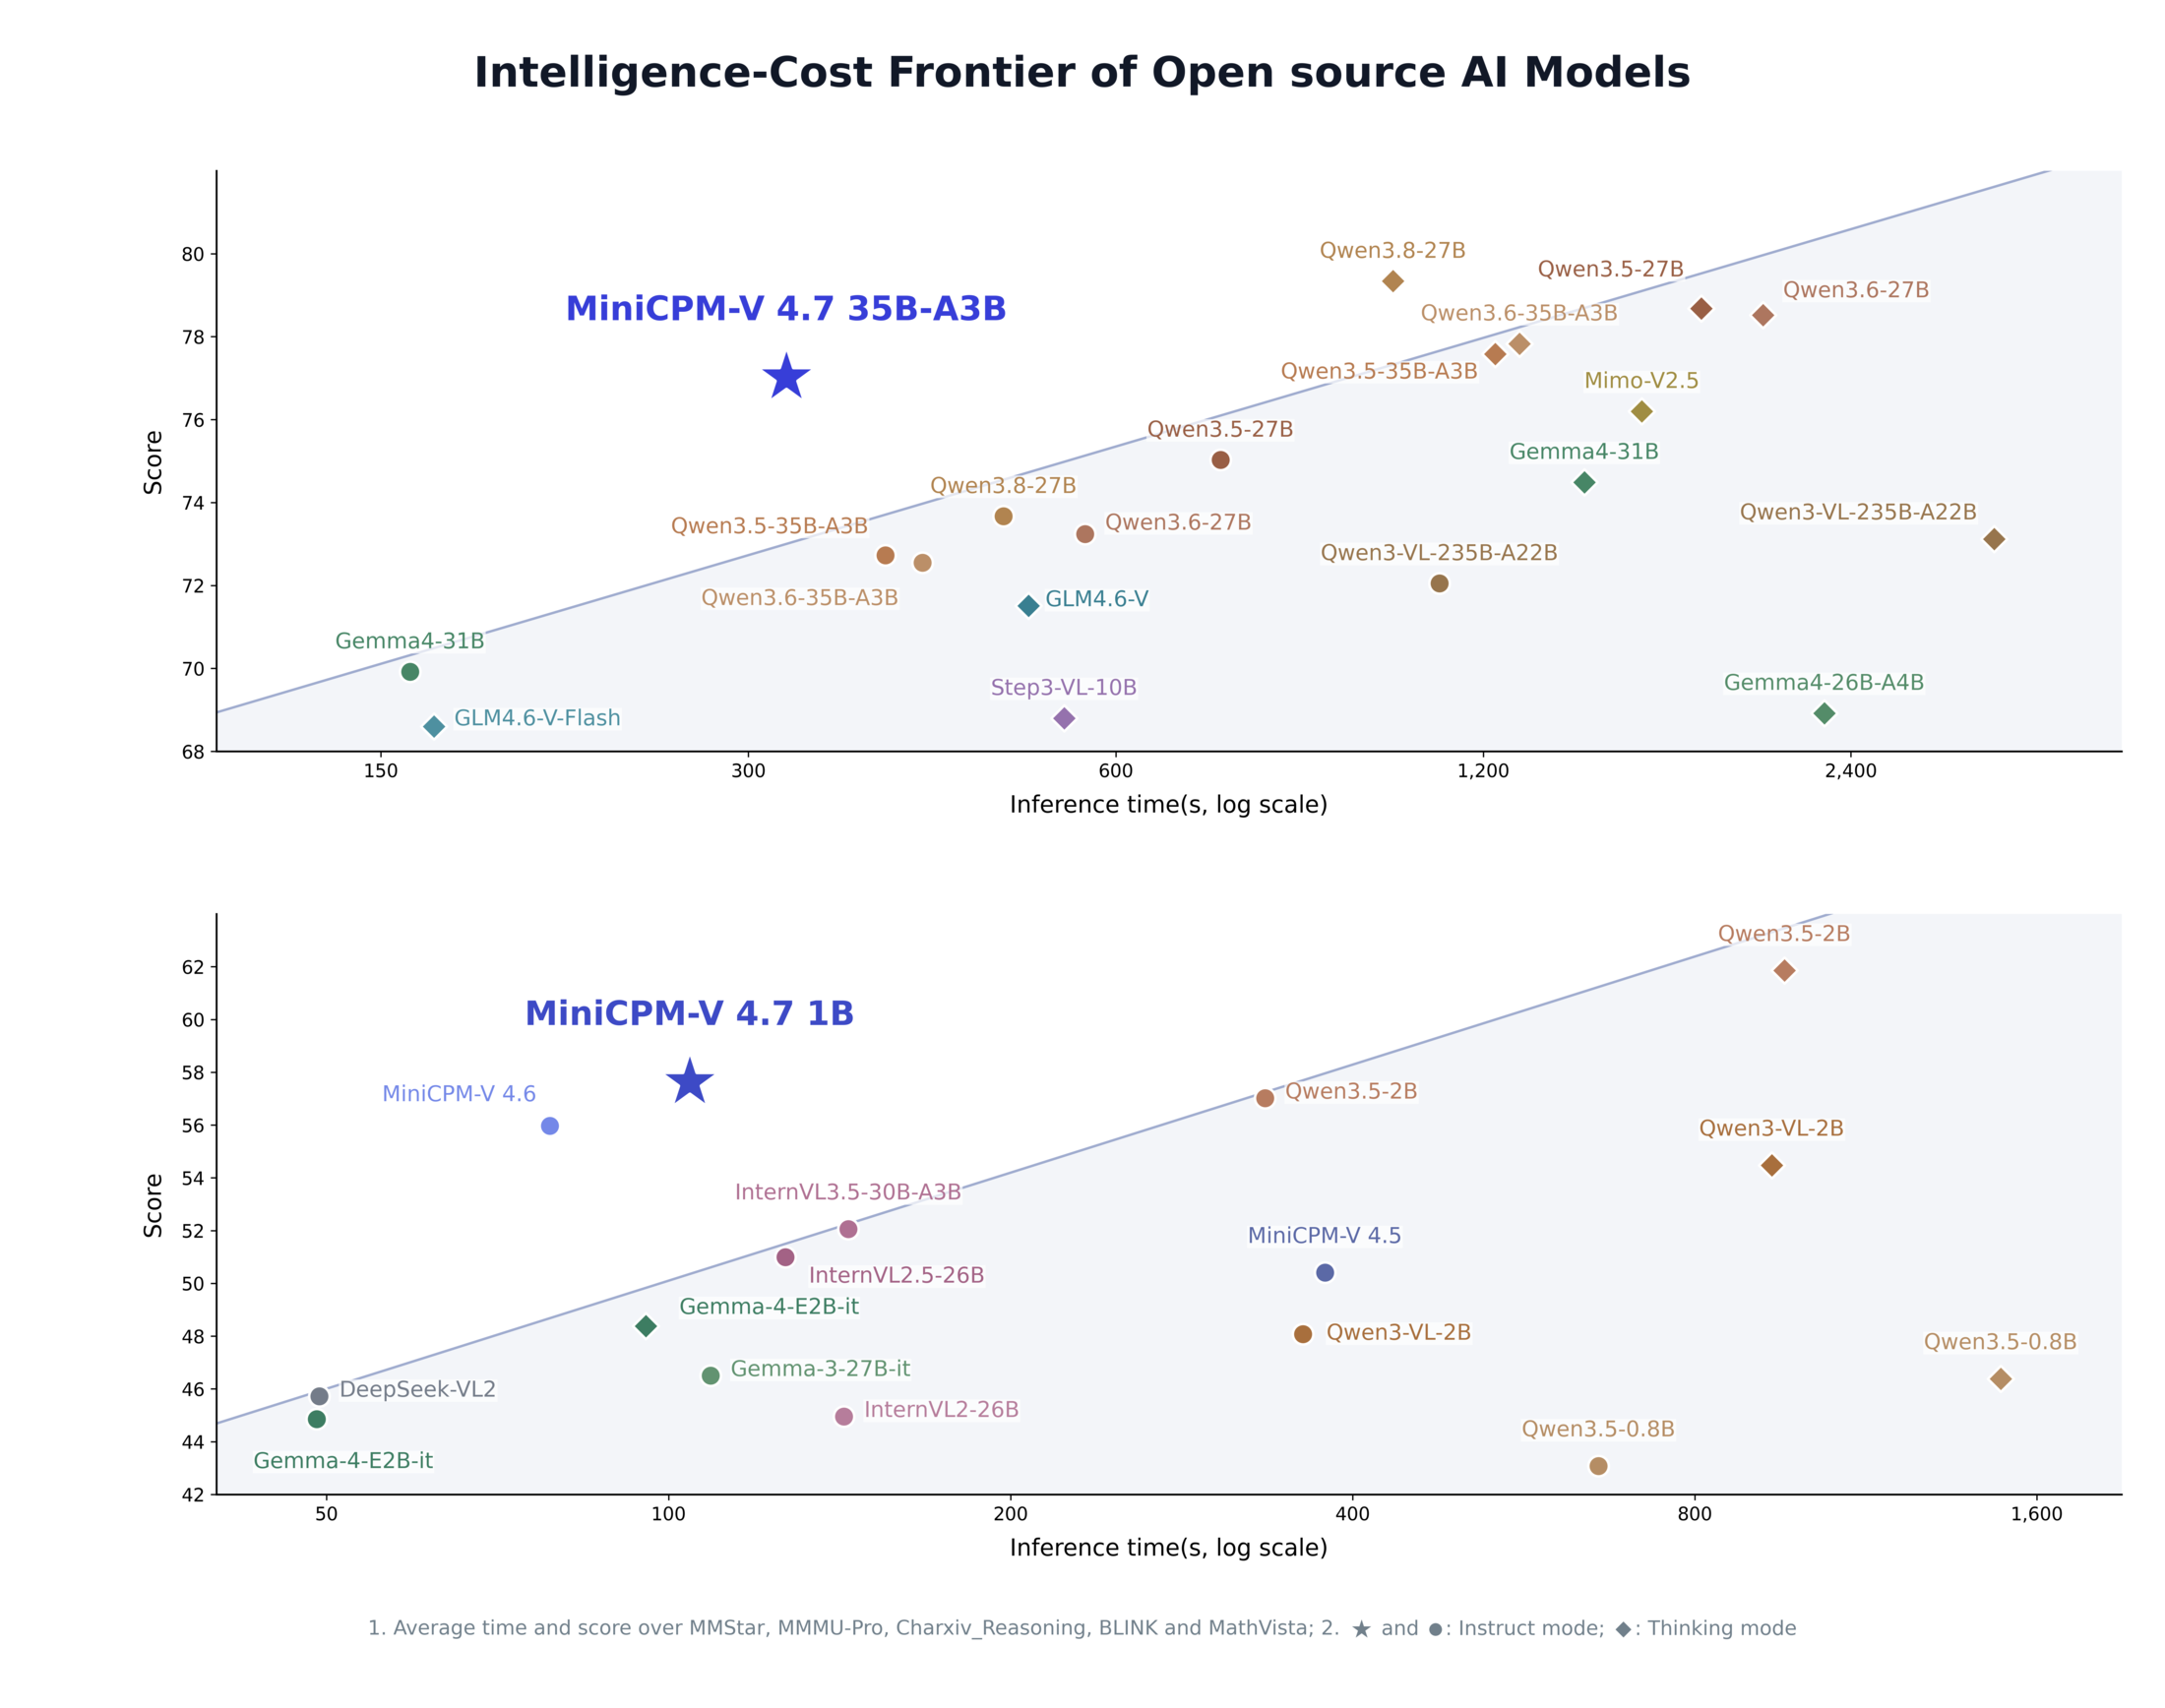
观察:端侧大模型的门槛,从"能不能跑"降到"该配什么卡"
上一槽我们拆过 LES 的调度机制,这一篇生态侧的信号更实际:一个模型同时进了五家海外芯片平台、十余条国产芯片路径和五个主流推理框架,模型侧不再是端侧 AI 选型的瓶颈。真正的决策点变成两件事:一是需要多强的多模态能力——35B-A3B 顶能力上限,1B 兜普惠下限,两档正好对应不同算力预算;二是按现有硬件清点重估——3GB 内存即可流畅运行 35B 级模型,意味着很多存量办公设备、边缘盒子可以原地复用,省掉一轮新采购。对已有私有化部署需求的企业,建议先拿 3GB 档配置做压测,再决定加不加卡。
来源:面壁智能/OpenBMB 官方发布材料、OpenBMB GitHub(MiniCPM-V 仓库)、凤凰网科技(2026-10-26);性能数字均为厂商自报,第三方独立复测进行中。